Teste do LLM OpenCode — estatísticas de codificação e precisão
Testei como o OpenCode funciona com vários LLMs hospedados localmente no Ollama e llama.cpp, e, para comparação, adicionei alguns modelos gratuitos do OpenCode Zen.
OpenHands é uma plataforma de código aberto e agnóstica em relação ao modelo para agentes de desenvolvimento de software impulsionados por IA.
Ele permite que um agente se comporte mais como um parceiro de programação do que como uma simples ferramenta de autocompletar.
Hospede APIs compatíveis com OpenAI com o LocalAI em minutos.
O LocalAI é um servidor de inferência de auto-hospedagem, com prioridade local, projetado para funcionar como uma API OpenAI plug-and-play para executar cargas de trabalho de IA no seu próprio hardware (laptop, estação de trabalho ou servidor local).
Instale o Oh My Opencode e desenvolva mais rápido.
O Oh My Opencode transforma o OpenCode em um harness de codificação multi-agente: um orquestrador delega trabalhos para agentes especialistas que executam em paralelo.
A inferência de LLM parece ser “apenas outra API” — até que a latência dispare, as filas se acumulem e suas GPUs fiquem com 95% de memória sem uma explicação óbvia.
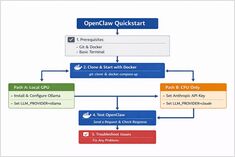
O OpenClaw é um assistente de IA auto-hospedado projetado para funcionar com tempos de execução de LLM locais, como Ollama, ou com modelos baseados em nuvem, como o Claude Sonnet.
AWS S3, Garage ou MinIO — visão geral e comparação.
AWS S3 continua a ser a linha de base “padrão” para armazenamento de objetos: é totalmente gerido, possui consistência forte e foi concebido para uma durabilidade e disponibilidade extremamente elevadas. Garage e MinIO são alternativas autoalojadas e compatíveis com S3: o Garage foi desenhado para clusters pequenos a médios, leves e geo-distribuídos, enquanto o MinIO enfatiza a ampla cobertura de funcionalidades da API S3 e o alto desempenho em implementações de maior escala.
Garage é um sistema de armazenamento de objetos de código aberto, auto-hospedado e compatível com S3, projetado para implantações de pequeno a médio porte, com forte ênfase em resiliência e distribuição geográfica.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
Hospedar LLMs localmente mantém dados, modelos e inferência sob seu controle – um caminho prático para a soberania de IA para equipes, empresas e nações.
Teste de velocidade de LLM em RTX 4080 com 16 GB de VRAM
Rodar modelos de linguagem grandes localmente oferece privacidade, capacidade de uso offline e zero custos de API.
Este benchmark revela exatamente o que se pode esperar de 14 modelos populares de
LLMs no Ollama em uma RTX 4080.
O ecossistema Go continua a prosperar com projetos inovadores que abrangem ferramentas de IA, aplicativos auto-hospedados e infraestrutura de desenvolvimento. Esta análise examina os repositórios Go mais populares no GitHub deste mês.
O vLLM é um motor de inferência e entrega (serving) de alta vazão e alta eficiência de memória para Modelos de Linguagem de Grande Escala (LLMs), desenvolvido pelo Sky Computing Lab da UC Berkeley.