LLM Performance

KV Cache em GPUs de 16 GB: Tornando o Contexto Longo Realmente Viável

KV Cache em GPUs de 16 GB: Tornando o Contexto Longo Realmente Viável

Por que a contextualização de 128K falha em 16 GB

Um modelo pode anunciar uma janela de contexto de 128K e ainda assim falhar com 40K tokens em uma GPU de 16 GB. O limite arquitetural nunca prometeu que pesos, cache de KV, buffers de computação e o compositor do ambiente gráfico caberiam no seu cartão ao mesmo tempo.

Decodificação Especulativa: Inferência de LLMs 20-50% Mais Rápida

Decodificação Especulativa: Inferência de LLMs 20-50% Mais Rápida

Inferência de LLM mais rápida sem perda de qualidade – um guia prático

Um modelo de 70B gera um token por passagem de frente, e cada passagem recarrega os pesos da VRAM, calcula a atenção através do contexto e sincroniza a memória. Entre os tokens, a GPU fica ociosa enquanto aguarda que as dependências sequenciais sejam resolvidas.

Qwen 3.6 27B e 35B MTP vs Padrão em GPU de 16GB

Qwen 3.6 27B e 35B MTP vs Padrão em GPU de 16GB

MTP vs. decodificação padrão na RTX 4080 — benchmarks reais

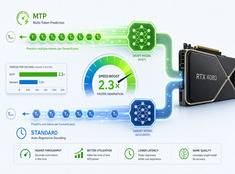
Testei o desempenho da decodificação especulativa (Previsão de Múltiplos Tokens, MTP) no Qwen 3.6 27B e 35B em uma RTX 4080 com 16 GB de VRAM.

Validação de Saída Estruturada de LLMs em Python que Funciona

Validação de Saída Estruturada de LLMs em Python que Funciona

Pare de interpretar vibes. Valide contratos.

A maioria dos tutoriais sobre “saída estruturada” de LLMs é superficial. Eles ensinam você a pedir JSON educadamente e depois torcer para que o modelo se comporte. Isso não é validação. Isso é otimismo com chaves.

BAML vs Instructor: Saídas Estruturadas de LLMs

BAML vs Instructor: Saídas Estruturadas de LLMs

Saídas de LLM com segurança de tipo usando BAML e Instructor

Ao trabalhar com Modelos de Linguagem Grande (LLMs) em produção, obter saídas estruturadas e com segurança de tipos é fundamental. Dois frameworks populares — BAML e Instructor — adotam abordagens diferentes para resolver este problema.

ASICs para LLMs e chips especializados em inferência (por que são importantes)

ASICs para LLMs e chips especializados em inferência (por que são importantes)

As ASICs e o silício personalizado aumentam a velocidade e a eficiência da inferência de LLMs.

O futuro da IA não se trata apenas de modelos mais inteligentes. Também se trata de silício que corresponda à forma como esses modelos são realmente servidos. O hardware especializado para inferência de LLMs segue um caminho reminiscente da transição da mineração de Bitcoin das GPUs para ASICs de propósito específico, mas com restrições ainda mais rígidas, pois os modelos e as receitas de precisão continuam a evoluir.