Selfhosting

Clone uma VM no Virt-Manager com virt-clone e virt-sysprep

Clone uma VM no Virt-Manager com virt-clone e virt-sysprep

Clonar uma VM copia bytes, não identidade.

O Virt-Manager (a interface gráfica do libvirt) copia um disco KVM e atribui ao clone um UUID e um MAC. O sistema convidado (guest) mantém seu machine-id e as chaves de host SSH até que o virt-sysprep os remova.
Loops de Memória Autoreforçantes em Agentes de IA: Causas e Soluções

Loops de Memória Autoreforçantes em Agentes de IA: Causas e Soluções

Quando conclusões lembradas se tornam novas evidências.

A memória persistente transforma um agente de uma ferramenta que precisa ser reexplicada em um que carrega o contexto para frente — mas abre um modo de falha que o chat sem estado evita: uma interpretação pode se tornar memória, recuperada como fato, e justificar uma versão mais forte de si mesma.

Mnemosyne para Hermes Agent: Guia Rápido de Memória Local

Mnemosyne para Hermes Agent: Guia Rápido de Memória Local

Memória local do Hermes com gravações controladas.

Mnemosyne é um provedor de memória local-first para o Hermes Agent, armazenando memória de trabalho, fatos estruturados, dados temporais e história episódica em SQLite local — sem serviço hospedado, sem chamadas de rede obrigatórias e com controle de gravação excepcionalmente granular.

Como migrar do OpenClaw para o Hermes Agent com segurança

Como migrar do OpenClaw para o Hermes Agent com segurança

Um cutover seguro que vai além do import de uma linha

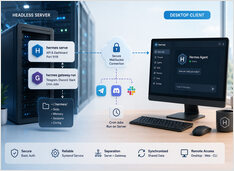
Migrar um assistente de IA não é o mesmo que copiar uma configuração de aplicativo. A parte difícil é preservar identidade, memória, comportamento das ferramentas, trabalhos agendados e acesso a mensagens, sem que dois gateways atuem como o mesmo bot.

KV Cache em GPUs de 16 GB: Tornando o Contexto Longo Realmente Viável

KV Cache em GPUs de 16 GB: Tornando o Contexto Longo Realmente Viável

Por que a contextualização de 128K falha em 16 GB

Um modelo pode anunciar uma janela de contexto de 128K e ainda assim falhar com 40K tokens em uma GPU de 16 GB. O limite arquitetural nunca prometeu que pesos, cache de KV, buffers de computação e o compositor do ambiente gráfico caberiam no seu cartão ao mesmo tempo.

Gravidade de Dados: O Custo Real da IA Prioritária em APIs

Gravidade de Dados: O Custo Real da IA Prioritária em APIs

Por que seu stack de IA fica mais grudento a cada mês.

Cada chamada de API parece uma transação simples — até que uma quantidade suficiente delas se acumule, de modo que seus dados de ajuste fino, seus conjuntos de avaliação e seus esquemas de ferramentas fiquem moldados em torno de um único fornecedor, e a troca deixe de ser apenas uma mudança de roteamento.

GPUs para IA em 2026: NVIDIA, AMD e Intel Comparadas

GPUs para IA em 2026: NVIDIA, AMD e Intel Comparadas

Comparação de GPUs de IA entre três fornecedores

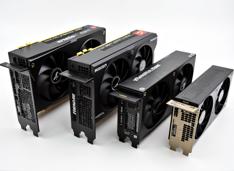
O cenário do hardware de IA mudou significativamente em 2026, com NVIDIA, AMD e Intel competindo por desenvolvedores que necessitam de GPUs capazes de executar modelos de linguagem grandes (LLMs) e cargas de trabalho de inferência de IA localmente.