Hardware

KV Cache em GPUs de 16 GB: Tornando o Contexto Longo Realmente Viável

KV Cache em GPUs de 16 GB: Tornando o Contexto Longo Realmente Viável

Por que a contextualização de 128K falha em 16 GB

Um modelo pode anunciar uma janela de contexto de 128K e ainda assim falhar com 40K tokens em uma GPU de 16 GB. O limite arquitetural nunca prometeu que pesos, cache de KV, buffers de computação e o compositor do ambiente gráfico caberiam no seu cartão ao mesmo tempo.
Gravidade de Dados: O Custo Real da IA Prioritária em APIs

Gravidade de Dados: O Custo Real da IA Prioritária em APIs

Por que seu stack de IA fica mais grudento a cada mês.

Cada chamada de API parece uma transação simples — até que uma quantidade suficiente delas se acumule, de modo que seus dados de ajuste fino, seus conjuntos de avaliação e seus esquemas de ferramentas fiquem moldados em torno de um único fornecedor, e a troca deixe de ser apenas uma mudança de roteamento.

GPUs para IA em 2026: NVIDIA, AMD e Intel Comparadas

GPUs para IA em 2026: NVIDIA, AMD e Intel Comparadas

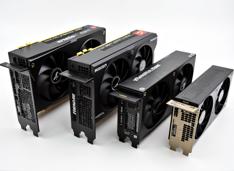
Comparação de GPUs de IA entre três fornecedores

O cenário do hardware de IA mudou significativamente em 2026, com NVIDIA, AMD e Intel competindo por desenvolvedores que necessitam de GPUs capazes de executar modelos de linguagem grandes (LLMs) e cargas de trabalho de inferência de IA localmente.

Qwen 3.6 27B e 35B MTP vs Padrão em GPU de 16GB

Qwen 3.6 27B e 35B MTP vs Padrão em GPU de 16GB

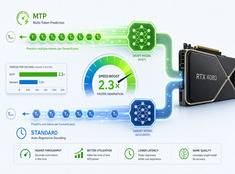
MTP vs. decodificação padrão na RTX 4080 — benchmarks reais

Testei o desempenho da decodificação especulativa (Previsão de Múltiplos Tokens, MTP) no Qwen 3.6 27B e 35B em uma RTX 4080 com 16 GB de VRAM.