NVIDIA

KV Cache em GPUs de 16 GB: Tornando o Contexto Longo Realmente Viável

KV Cache em GPUs de 16 GB: Tornando o Contexto Longo Realmente Viável

Por que a contextualização de 128K falha em 16 GB

Um modelo pode anunciar uma janela de contexto de 128K e ainda assim falhar com 40K tokens em uma GPU de 16 GB. O limite arquitetural nunca prometeu que pesos, cache de KV, buffers de computação e o compositor do ambiente gráfico caberiam no seu cartão ao mesmo tempo.

GPUs para IA em 2026: NVIDIA, AMD e Intel Comparadas

GPUs para IA em 2026: NVIDIA, AMD e Intel Comparadas

Comparação de GPUs de IA entre três fornecedores

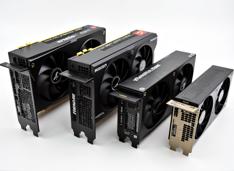
O cenário do hardware de IA mudou significativamente em 2026, com NVIDIA, AMD e Intel competindo por desenvolvedores que necessitam de GPUs capazes de executar modelos de linguagem grandes (LLMs) e cargas de trabalho de inferência de IA localmente.

Qwen 3.6 27B e 35B MTP vs Padrão em GPU de 16GB

Qwen 3.6 27B e 35B MTP vs Padrão em GPU de 16GB

MTP vs. decodificação padrão na RTX 4080 — benchmarks reais

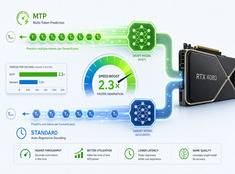
Testei o desempenho da decodificação especulativa (Previsão de Múltiplos Tokens, MTP) no Qwen 3.6 27B e 35B em uma RTX 4080 com 16 GB de VRAM.

Ollama no Docker Compose com GPU e Armazenamento Persistente de Modelos

Ollama no Docker Compose com GPU e Armazenamento Persistente de Modelos

Servidor Ollama com prioridade na criação, GPU e persistência.

Ollama funciona muito bem em hardware nativo. Ele fica ainda mais interessante quando o tratamos como um serviço: um endpoint estável, versões fixas, armazenamento persistente e uma GPU que está disponível ou simplesmente não está.