
ASICs para LLMs e chips especializados em inferência (por que são importantes)
As ASICs e o silício personalizado aumentam a velocidade e a eficiência da inferência de LLMs.
O futuro da IA não se trata apenas de modelos mais inteligentes. Também se trata de silício que corresponda à forma como esses modelos são realmente servidos. O hardware especializado para inferência de LLMs segue um caminho reminiscente da transição da mineração de Bitcoin das GPUs para ASICs de propósito específico, mas com restrições ainda mais rígidas, pois os modelos e as receitas de precisão continuam a evoluir.
Para mais informações sobre taxa de transferência (throughput), latência, VRAM e benchmarks em diferentes runtimes e hardware, consulte Desempenho de LLMs: Benchmarks, Gargalos & Otimização.
 Imaginação Elétrica - Flux texto para imagem LLM.
Por que os LLMs se beneficiam de hardware específico para inferência
Os modelos de linguagem grandes transformaram a IA, mas cada resposta fluente depende de grandes e previsíveis fluxos de operações de matrizes e tráfego de memória. À medida que os gastos com inferência crescem — muitas vezes ultrapassando os de treinamento ao longo da vida útil de um modelo —, os chips otimizadas para servir (serving), e não para todas as cargas de trabalho possíveis, tornam-se economicamente atrativos.
A analogia com a mineração de Bitcoin é imperfeita, mas instrutiva. Ambas são tarefas repetitivas e bem delimitadas, onde remover a generalidade não utilizada do die pode trazer grandes ganhos em throughput e joules por operação útil.
O que a história da mineração de Bitcoin sugere sobre ASICs de inferência
A mineração de Bitcoin evoluiu através de quatro gerações:
| Era | Hardware | Benefício Chave | Limitação |
|---|---|---|---|
| 2015–2020 | GPUs (CUDA, ROCm) | Flexibilidade | Alto consumo de energia, limitado pela memória |
| 2021–2023 | TPUs, NPUs | Especialização de grão grosso | Ainda voltada para treinamento |
| 2024–2025 | ASICs de Transformers | Sintonizados para inferência de baixo bit | Geralidade limitada |
A IA está seguindo um caminho semelhante. Cada transição melhorou o desempenho e a eficiência energética em ordens de grandeza.
No entanto, diferente dos ASICs de Bitcoin (que apenas calculam SHA-256), os ASICs de inferência precisam de alguma flexibilidade. Os modelos evoluem, as arquiteturas mudam e os esquemas de precisão melhoram. O truque é especializar o suficiente — fixando os padrões principais no hardware enquanto mantém adaptabilidade nas bordas.
Como a inferência de LLMs difere do treinamento (e o que os chips exploram)
As cargas de trabalho de inferência expõem padrões que o hardware especializado pode atacar:
- Baixa precisão domina — aritmética de 8-bit, 4-bit, até mesmo ternária ou binária funciona bem para inferência
- A memória é o gargalo — Mover pesos e caches KV consome muito mais energia do que o cálculo
- A latência importa mais que o throughput — Os usuários esperam tokens em menos de 200ms
- Paralelismo massivo de requisições — Milhares de requisições de inferência concorrentes por chip
- Padrões previsíveis — As camadas de Transformers são altamente estruturadas e podem ser fixadas no hardware
- Oportunidades de esparsidade — Os modelos usam cada vez mais técnicas de poda e MoE (Mixture-of-Experts)
Um chip de inferência de propósito construído pode fixar essas premissas no hardware para alcançar 10–50× melhor desempenho por watt do que GPUs de propósito geral.
Quem está construindo silício otimizado para inferência de LLMs
O mercado de ASICs de inferência abrange empresas estabelecidas, designs de escala de wafer e startups apostando em silício em forma de transformer:
| Empresa | Chip / Plataforma | Especialidade |
|---|---|---|
| Groq | LPU (Language Processing Unit) | Throughput determinístico para LLMs |
| Etched AI | ASIC Sohu | Motor de Transformer fixado no hardware |
| Tenstorrent | Grayskull / Blackhole | ML geral com malha de alta largura de banda |
| Taalas | HC1 (produto Llama 3.1 8B) / roadmap HC2 | Silício “hardcore” específico de modelo; mescla armazenamento e computação |
| OpenAI × Broadcom | Chip de Inferência Personalizado | Lançamento rumorado em 2026 |
| Intel | Crescent Island | GPU Xe3P apenas para inferência com 160GB de HBM |
| Cerebras | Wafer-Scale Engine (WSE-3) | Enorme largura de banda de memória no die |
Muito disso já está em data centers de produção, não apenas em apresentações de slides. Equipes menores, como d-Matrix, Rain AI, Mythic e Tenet, também estão persegundo arquiteturas ajustadas para inferência de baixo bit e esparsidade estruturada.
Taalas HC1, Chat Jimmy e o serviço ultra-rápido de modelos pequenos
A Taalas é um exemplo recente da escola “especializar quase tudo”. A empresa argumenta que a fronteira entre memória e computação (DRAM off-chip versus SRAM on-chip) domina os custos, o consumo de energia e a complexidade de engenharia para inferência, e que o silício por modelo — o que eles chamam de Hardcore Models — pode eliminar essa fronteira quando uma implantação está disposta a fixar os pesos e o grafo.
Seu primeiro produto de envio, o HC1, fixa no hardware uma variante do Llama 3.1 8B. Essa escolha é pragmática: o modelo é pequeno o suficiente para ser implementado rapidamente, amplamente documentado e ainda útil para muitas tarefas de automação, classificação e rascunho onde a profundidade de raciocínio bruto importa menos que a latência e o custo. A Taalas relata na ordem de 16k–17k tokens decodificados por segundo por usuário para esta configuração (a metodologia do fornecedor e as comparações aparecem em seu relatório), além de alegar grandes ganhos em capital e energia em relação a pilhas convencionais de GPU para a mesma classe de modelo. As peças da primeira geração usam armazenamento misto agressivo de baixo bit; a empresa descreve a transição para formatos flutuantes padrão de 4-bit no HC2 para recuperar folga na qualidade.
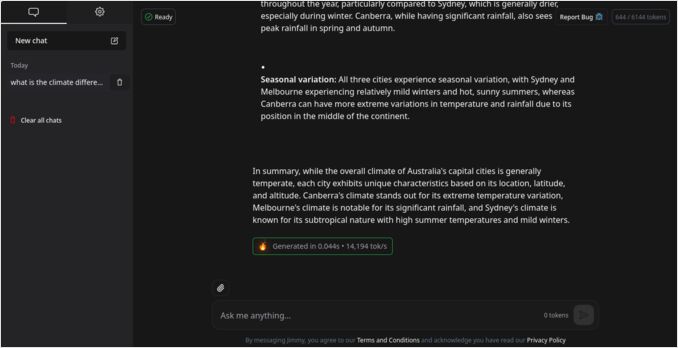
Para desenvolvedores que desejam sentir o que essa classe de throughput implica na prática, a Taalas executa um chatbot de demonstração gratuito, o Chat Jimmy, e oferece acesso à API através de um formulário de aplicação em seu site. É explicitamente uma prova de conceito — não um assistente de fronteira —, mas ilustra um público real que pode preferir um modelo modesto na “velocidade da cognição humana” a um modelo maior que parece lento ou caro.
Arquitetura de um ASIC de inferência de transformers
Como é, na verdade, o interior de um chip otimizado para transformers?
+--------------------------------------+
|         Interface do Host            |
|   (PCIe / CXL / NVLink / Ethernet)   |
+--------------------------------------+
|  Interconexão no Chip (mesh/ring)    |
+--------------------------------------+
|  Tiles / Núcleos de Computação       |
|   — Unidades de multiplicação de matrizes densas |
|   — ALUs de baixa precisão (int8/int4) |
|   — Unidades de Desquantização / Ativação |
+--------------------------------------+
|  SRAM no Chip & Buffers de Cache KV  |
|   — Pesos quentes, caches fundidos    |
+--------------------------------------+
|  Pipelines de Quantização / Desquantização |
+--------------------------------------+
|  Agendador / Controlador             |
|   — Motor de execução de grafo estático |
+--------------------------------------+
|  Interface de DRAM / HBM Off-chip    |
+--------------------------------------+
As principais características arquitetônicas incluem:
- Núcleos de computação — Unidades de multiplicação de matrizes densas otimizadas para operações int8, int4 e ternárias
- SRAM no chip — Grandes buffers seguram pesos quentes e caches KV, minimizando acessos caros à DRAM
- Interconexões em streaming — A topologia em malha (mesh) permite escalonamento eficiente entre vários chips
- Motores de quantização — Quantização/desquantização em tempo real entre camadas
- Stack de compilador — Traduz grafos PyTorch/ONNX diretamente em micro-operações específicas do chip
- Kernels de atenção fixados no hardware — Elimina a sobrecarga de fluxo de controle para softmax e outras operações
A filosofia de design espelha os ASICs de Bitcoin: cada transistor serve à carga de trabalho específica. Nenhum silício desperdiçado em recursos que a inferência não precisa.
Benchmarks de GPU versus ASIC para inferência de LLMs
Números públicos representativos mostram como o hardware especializado de inferência pode se distanciar de pilhas de GPU de propósito geral nas mesmas famílias de modelos (sempre verifique a metodologia e as premissas de agrupamento para suas próprias cargas de trabalho):
| Modelo | Hardware | Throughput (tokens/s) | Tempo até o Primeiro Token | Multiplicador de Desempenho |
|---|---|---|---|---|
| Llama-2-70B | NVIDIA H100 (8x DGX) | ~80–100 | ~1,7s | Baseline (1×) |
| Llama-2-70B | Groq LPU | 241–300 | 0,22s | 3–18× mais rápido |
| Llama-3.3-70B | Groq LPU | ~276 | ~0,2s | 3× consistente |
| Gemma-7B | Groq LPU | 814 | <0,1s | 5–15× mais rápido |
| Llama-3.1-8B | Taalas HC1 (fornecedor) | ~16k–17k tokens decodificados/s/usuário | — | Eixo separado (grafo 8B fixo, não 70B) |
Fontes: Groq.com, ArtificialAnalysis.ai, NVIDIA Developer Blog; números do Taalas HC1 obtidos da publicação de produto da empresa.
As linhas focadas na Groq mostram grandes ganhos em throughput e tempo-ate-o-primeiro-token em comparação com uma baseline de GPU de alto nível em modelos grandes. A linha da Taalas não é outro multiplicador em relação às linhas de 70B; ela ilustra o quão longe a decodificação por usuário pode ser empurrada quando o modelo e o grafo estão fixos no silício, às custas da flexibilidade.
Compromissos ao se especializar o silício de inferência
A especialização compra desempenho, mas reintroduz riscos de produto e de engenharia:
-
Flexibilidade vs. Eficiência. Um ASIC totalmente fixo passa voando pelos modelos de transformers de hoje, mas pode ter dificuldade com as arquiteturas de amanhã. O que acontece quando os mecanismos de atenção evoluem ou novas famílias de modelos surgem? Isso não é hipotético — modelos de espaço de estado, modelos de linguagem de difusão e modelos de mundo JEPA já estão desafiando a dominância do transformer no lado dos modelos; veja o que vem depois dos LLMs para onde essas arquiteturas podem deixar o silício de transformer fixado no hardware.
-
Quantização e Precisão. A menor precisão economiza grandes quantidades de energia, mas gerenciar a degradação da precisão requer esquemas de quantização sofisticados. Nem todos os modelos quantizam graciosamente para 4-bit ou menos.
-
Ecossistema de Software. Hardware sem compiladores, kernels e frameworks robustos é inútil. A NVIDIA ainda domina em grande parte devido ao ecossistema maduro do CUDA. Novos fabricantes de chips devem investir pesadamente em software.
-
Custo e Risco. Lançar um chip para fabricação custa dezenas de milhões de dólares e leva de 12 a 24 meses. Para startups, esta é uma aposta massiva em premissas arquitetônicas que podem não se sustentar.
Ainda assim, em hiper escala, ganhos de eficiência de apenas 2× se traduzem em bilhões em economias. Para provedores de nuvem executando milhões de requisições de inferência por segundo, o silício personalizado é cada vez mais inevitável.
Uma lista de especificações desejadas para um chip de inferência de LLMs
| Recurso | Especificação Ideal |
|---|---|
| Processo | Nó de 3–5nm |
| SRAM no Chip | 100MB+ fortemente acoplado |
| Precisão | Suporte nativo para int8 / int4 / ternário |
| Throughput | 500+ tokens/segundo (modelo de 70B) |
| Latência | <100ms até o primeiro token |
| Interconexão | Malha de baixa latência ou links ópticos |
| Compilador | Toolchain PyTorch/ONNX → microcódigo |
| Energia | <0,3 joules por token |
Olhando para frente (2026–2030)
Espera-se que a paisagem do hardware de inferência se estratifique em três camadas grossas:
-
Chips de Treinamento. GPUs de alto nível, como NVIDIA B200 e AMD Instinct MI400, continuarão dominando o treinamento com sua flexibilidade FP16/FP8 e enorme largura de banda de memória.
-
ASICs de Inferência. Aceleradores de transformers fixados no hardware, de baixa precisão, tratarão o serviço de produção em hiper escala, otimizados para custo e eficiência.
-
NPUs de Borda (Edge). Chips pequenos e ultra-eficientes levarão LLMs quantizados para smartphones, veículos, dispositivos IoT e robôs, habilitando inteligência no dispositivo sem dependência da nuvem.
Além do hardware, veremos:
- Clusters híbridos — GPUs para treinamento flexível, ASICs (ou motores de inferência em escala de wafer) para serviço eficiente
- Inferência como Serviço (Inference-as-a-Service) — Hiper escaladores misturando aceleradores de primeira parte (AWS Inferentia, Google TPU, entre outros) com GPUs
- Co-design de hardware e software — Modelos moldados para esparsidade por blocos, roteamento MoE e camadas amigáveis à quantização
- Silício por modelo ou por família — Empresas como a Taalas apostando que algumas implantações trocarão flexibilidade arquitetural por custo e latência extremos em um grafo conhecido
- APIs de inferência abertas — Pressão para manter interfaces de serviço portáveis mesmo quando o silício não for
Pensamentos finais
A “ASICização” da inferência de IA já está em andamento. Assim como a mineração de Bitcoin evoluiu de CPUs para silício especializado, o deploy de IA está seguindo o mesmo caminho.
A próxima revolução em IA não será sobre modelos maiores — será sobre melhores chips. Hardware otimizado para os padrões específicos da inferência de transformers determinará quem pode implantar IA economicamente em escala.
Assim como os mineradores de Bitcoin otimizaram cada watt desperdiçado, o hardware de inferência espremerá cada último FLOP-por-joule. Quando isso acontecer, a verdadeira quebra não estará nos algoritmos — estará no silício que os executa.
O futuro da IA está sendo gravado em silício, um transistor de cada vez.
Para mais benchmarks, escolhas de hardware e ajuste de desempenho, verifique nosso hub Desempenho de LLMs: Benchmarks, Gargalos & Otimização.
Links Úteis
- Benchmarks Oficiais da Groq
- Taalas — O caminho para a IA ubíqua (HC1, roadmap, filosofia)
- Chat Jimmy — Demonstração Llama 3.1 8B da Taalas
- Formulário de solicitação de acesso à API da Taalas
- Artificial Analysis - Classificação de Desempenho de LLMs
- Resumo Técnico NVIDIA H100
- Etched AI - Anúncio do ASIC de Transformer
- Cerebras Wafer-Scale Engine
- Preços das NVidia RTX 5080 e RTX 5090 na Austrália - Outubro de 2025
- Desempenho de LLMs e Faixas PCIe: Considerações Principais
- Teste de Velocidade de Modelos de Linguagem Grandes
- Comparando a adequação de GPUs NVidia para IA
- A Quadro RTX 5880 Ada 48GB é Boa?
