
Docker Model Runner: Guia de Configuração do Tamanho do Contexto
Configure tamanhos de contexto no Docker Model Runner com soluções alternativas
A configuração de tamanhos de contexto no Docker Model Runner é mais complexa do que deveria.
Configure tamanhos de contexto no Docker Model Runner com soluções alternativas
A configuração de tamanhos de contexto no Docker Model Runner é mais complexa do que deveria.
Modelo de IA para aprimorar imagens com instruções textuais
A Black Forest Labs lançou o FLUX.1-Kontext-dev, um modelo avançado de IA para transformação de imagem em imagem que aprimora imagens existentes usando instruções de texto.
Ative a aceleração por GPU para o Docker Model Runner com suporte NVIDIA CUDA.
Docker Model Runner é a ferramenta oficial da Docker para executar modelos de IA localmente, mas habilitar a aceleração de GPU da NVidia no Docker Model Runner requer configuração específica.
Reduza os custos de LLMs em 80% com otimização inteligente de tokens
A otimização de tokens é a habilidade crucial que separa aplicações de LLMs com custo-efetividade de experimentos que drenam o orçamento.
Benchmarks do GPT-OSS 120b em três plataformas de IA
Descobri alguns testes de desempenho interessantes do GPT-OSS 120b rodando no Ollama em três plataformas diferentes: NVIDIA DGX Spark, Mac Studio e RTX 4080. O modelo GPT-OSS 120b da biblioteca Ollama pesa 65 GB, o que significa que ele não cabe na VRAM de 16 GB de uma RTX 4080 (ou na mais recente RTX 5080).
Construa servidores MCP para assistentes de IA com exemplos em Python
O Protocolo de Contexto de Modelo (MCP) está revolucionando a forma como assistentes de IA interagem com fontes de dados externas e ferramentas. Neste guia, exploraremos como construir servidores MCP em Python, com exemplos focados em capacidades de pesquisa e raspagem web.
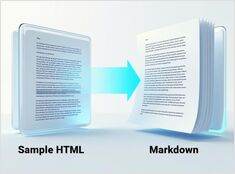
Python para converter HTML em Markdown limpo e pronto para LLM
Convertendo HTML para Markdown é uma tarefa fundamental nos fluxos de trabalho de desenvolvimento modernos, especialmente ao preparar conteúdo web para Modelos de Linguagem de Grande Porte (LLMs), sistemas de documentação ou geradores de sites estáticos como o Hugo.
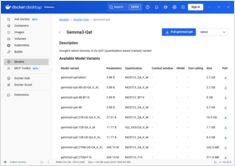
Referência rápida para comandos do Docker Model Runner
Docker Model Runner (DMR) é a solução oficial do Docker para executar modelos de IA localmente, introduzida em abril de 2025. Esta lista de comandos essenciais fornece uma referência rápida para todos os comandos, configurações e melhores práticas.
Compare o Docker Model Runner e o Ollama para LLM locais.
Execução local de grandes modelos de linguagem (LLMs) tornou-se cada vez mais popular devido à privacidade, controle de custos e capacidades offline. O cenário mudou significativamente em abril de 2025, quando a Docker introduziu o Docker Model Runner (DMR), sua solução oficial para implantação de modelos de IA.
As ASICs e o silício personalizado aumentam a velocidade e a eficiência da inferência de LLMs.
O futuro da IA não se trata apenas de modelos mais inteligentes. Também se trata de silício que corresponda à forma como esses modelos são realmente servidos. O hardware especializado para inferência de LLMs segue um caminho reminiscente da transição da mineração de Bitcoin das GPUs para ASICs de propósito específico, mas com restrições ainda mais rígidas, pois os modelos e as receitas de precisão continuam a evoluir.
Disponibilidade, preços reais no varejo em seis países e comparação com o Mac Studio.
NVIDIA DGX Spark é real, está à venda a partir de 15/10/2025 e é direcionado a desenvolvedores de CUDA que precisam de trabalho local com LLMs e uma pilha de IA integrada da NVIDIA. O preço de varejo nos EUA (MSRP) é de $3.999; o preço de varejo no Reino Unido/Alemanha/Japão é mais alto devido ao IVA e aos canais de distribuição. Os preços públicos em AUD/KRW ainda não foram amplamente publicados.
Comparando velocidade, parâmetros e desempenho desses dois modelos
Aqui está uma comparação entre Qwen3:30b e GPT-OSS:20b, focando no seguimento de instruções e nos parâmetros de desempenho, especificações e velocidade.
+ Exemplos Específicos Utilizando LLMs de Raciocínio
Neste post, exploraremos duas maneiras de conectar sua aplicação Python ao Ollama: 1. Via API REST HTTP; 2. Via a biblioteca oficial Python do Ollama.
Não é muito agradável.
Os modelos GPT-OSS da Ollama apresentam problemas recorrentes no manuseio de saída estruturada, especialmente quando utilizados com frameworks como LangChain, SDK da OpenAI, vllm e outros.
APIs ligeiramente diferentes exigem uma abordagem especial.
Aqui está uma comparação lado a lado do suporte para saída estruturada (obter JSON confiável de volta) em provedores populares de LLMs, além de exemplos mínimos em Python
Algumas maneiras de obter saída estruturada do Ollama
Grandes Modelos de Linguagem (LLMs) são poderosos, mas em produção raramente queremos parágrafos em formato livre. Em vez disso, queremos dados previsíveis: atributos, fatos ou objetos estruturados que você pode alimentar em um aplicativo. Isso é Saída Estruturada de LLM.