A Inteligência Artificial está redefinindo a forma como o software é escrito, revisado, implantado e mantido. Desde assistentes de código com IA até automação GitOps e fluxos de trabalho DevOps, os desenvolvedores agora dependem de ferramentas alimentadas por IA em todo o ciclo de vida do software.
OpenCode é um agente de codificação com IA de código aberto que você pode executar no terminal (TUI + CLI), com interfaces opcionais para desktop e IDEs. Este é o Início Rápido do OpenCode: instalar, verificar, conectar um modelo/provedor e executar fluxos de trabalho reais (CLI + API).
A inferência de LLM parece ser “apenas outra API” — até que a latência dispare, as filas se acumulem e suas GPUs fiquem com 95% de memória sem uma explicação óbvia.
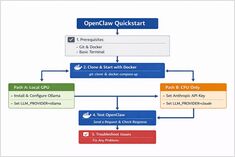
O OpenClaw é um assistente de IA auto-hospedado projetado para funcionar com tempos de execução de LLM locais, como Ollama, ou com modelos baseados em nuvem, como o Claude Sonnet.
Construa fluxos de trabalho em Go com o SDK Temporal
Temporal é um mecanismo de workflow de código aberto e nível empresarial que permite aos desenvolvedores construir aplicações de workflow duráveis, escaláveis e tolerantes a falhas, utilizando linguagens de programação familiares como Go.
Estratégia de observabilidade ponta a ponta para inferência de LLM e aplicações de LLM
Os sistemas de LLM falham de maneiras que a monitorização tradicional de APIs não consegue revelar — as filas enchem-se silenciosamente, a memória da GPU satura-se muito antes de a CPU parecer ocupada e a latência explode na camada de loteamento (batching) em vez da camada de aplicação.
Métricas, painéis, logs e alertas para sistemas de produção — Prometheus, Grafana, Kubernetes e cargas de trabalho de IA.
Observabilidade é a base de sistemas de produção confiáveis.
Sem métricas, painéis e alertas, os clusters Kubernetes se desviam, as cargas de trabalho de IA falham silenciosamente e as regressões de latência passam despercebidas até que os usuários reclame.
De RAG básico à produção: chunking, busca vetorial, reranking e avaliação em um único guia.
Production-focused guide to building RAG systems: chunking, vector stores, hybrid retrieval, reranking, evaluation, and when to choose RAG over fine-tuning.
A performance engineering hub for running LLMs efficiently: runtime behavior, bottlenecks, benchmarks, and the real constraints that shape throughput and latency.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
Hospedar LLMs localmente mantém dados, modelos e inferência sob seu controle – um caminho prático para a soberania de IA para equipes, empresas e nações.
Teste de velocidade de LLM em RTX 4080 com 16 GB de VRAM
Rodar modelos de linguagem grandes localmente oferece privacidade, capacidade de uso offline e zero custos de API.
Este benchmark revela exatamente o que se pode esperar de 14 modelos populares de
LLMs no Ollama em uma RTX 4080.
O ecossistema Rust está explodindo com projetos inovadores, particularmente em ferramentas de codificação com IA e aplicações de terminal.
Esta análise aborda os repositórios Rust mais populares no GitHub deste mês.
O ecossistema Go continua a prosperar com projetos inovadores que abrangem ferramentas de IA, aplicativos auto-hospedados e infraestrutura de desenvolvimento. Esta análise examina os repositórios Go mais populares no GitHub deste mês.