AI

SGLang QuickStart: Instale, Configure e Execute LLMs via API OpenAI

SGLang QuickStart: Instale, Configure e Execute LLMs via API OpenAI

Execute modelos abertos com rapidez usando o SGLang.

O SGLang é um framework de serviço de alto desempenho para grandes modelos de linguagem e modelos multimodais, construído para fornecer inferência de baixa latência e alto throughput, desde uma única GPU até clusters distribuídos.
Início Rápido do LocalAI: Execute LLMs Compatíveis com OpenAI Localmente

Início Rápido do LocalAI: Execute LLMs Compatíveis com OpenAI Localmente

Hospede APIs compatíveis com OpenAI com o LocalAI em minutos.

O LocalAI é um servidor de inferência de auto-hospedagem, com prioridade local, projetado para funcionar como uma API OpenAI plug-and-play para executar cargas de trabalho de IA no seu próprio hardware (laptop, estação de trabalho ou servidor local).

Introdução rápida ao llama.cpp com CLI e servidor

Introdução rápida ao llama.cpp com CLI e servidor

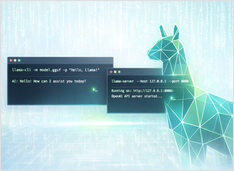
Execute modelos GGUF com o CLI e o servidor

llama.cpp é um motor de inferência em C/C++ para modelos GGUF: llama-cli para chat interativo, llama-completion para prompts roteirizados e llama-server para uma API HTTP compatível com OpenAI.

Airtable para Desenvolvedores e DevOps: Planos, API, Webhooks e Exemplos em Go/Python

Airtable para Desenvolvedores e DevOps: Planos, API, Webhooks e Exemplos em Go/Python

Airtable - Limites do plano gratuito, API, webhooks, Go e Python.

O Airtable deve ser pensado como uma plataforma de aplicativos low-code construída em torno de uma interface de planilha “semelhante a banco de dados” colaborativa - excelente para criar rapidamente ferramentas operacionais (rastreadores internos, CRMs leves, pipelines de conteúdo, filas de avaliação de IA) onde usuários não desenvolvedores precisam de uma interface amigável, mas os desenvolvedores também precisam de uma superfície de API para automação e integração.