
A Ascensão e Queda do OpenClaw — Cronologia e as Verdadeiras Razões por Trás do Colapso
OpenClaw surgiu rapidamente. Depois desapareceu ainda mais depressa.
O OpenClaw não fracassou como produto. Ele perdeu seu combustível.
OpenClaw surgiu rapidamente. Depois desapareceu ainda mais depressa.
O OpenClaw não fracassou como produto. Ele perdeu seu combustível.
Sirva e troque LLMs sem reinicializações.
Por muito tempo, o llama.cpp teve uma limitação flagrante:
você só podia servir um modelo por processo, e alternar significava reiniciar.
Ferramentas, métodos e wikis auto-hospedados para PKM comparados.
A gestão de conhecimento pessoal abrange Obsidian, Logseq, DokuWiki, Zettelkasten e PARA — a escolha certa depende se você deseja um gráfico de notas local, uma wiki auto-hospedada ou um fluxo de trabalho orientado por outliners.
Configurações do Hermes com perfil em primeiro lugar para cargas de trabalho sérias
O assistente de IA Hermes, documentado oficialmente como Hermes Agent, não se posiciona como um simples wrapper de chat.
As habilidades que valem a pena manter e as que devem ser ignoradas
O OpenClaw possui dois tipos de extensões, e é fácil confundi-los.
Plugins estendem o tempo de execução. Skills (habilidades) estendem o comportamento do agente.
Plugins primeiro. Nomenclatura de habilidades em resumo.
Este artigo trata dos plugins do OpenClaw — pacotes nativos de gateway que adicionam canais, provedores de modelos, ferramentas, voz, memória, mídia, pesquisa web e outras superfícies de tempo de execução.
Como os sistemas reais do OpenClaw são realmente estruturados
OpenClaw parece simples em demonstrações. Em produção, ele se torna um sistema.
Busca de IA auto-hospedada com LLMs locais
O Vane é uma das entradas mais pragmáticas no espaço de “busca com IA e citações”: um motor de respostas self-hosted que combina recuperação web em tempo real com LLMs locais ou na nuvem, mantendo toda a pilha sob seu controle.
Instalação e guia rápido do Hermes Agent para desenvolvedores
O Hermes Agent é um assistente de IA auto-hospedado e agnóstico de modelos que roda em uma máquina local ou em um VPS de baixo custo, opera através de interfaces de terminal e mensagens e melhora ao longo do tempo transformando tarefas repetitivas em habilidades reutilizáveis.
Instale o TGI, desenvolva rapidamente e depure ainda mais rápido.
A Inferência de Geração de Texto (TGI) tem uma energia muito específica. Não é o mais novo na rua da inferência, mas é aquele que já aprendeu como a produção quebra -
Execute modelos abertos com rapidez usando o SGLang.
O SGLang é um framework de serviço de alto desempenho para grandes modelos de linguagem e modelos multimodais, construído para fornecer inferência de baixa latência e alto throughput, desde uma única GPU até clusters distribuídos.
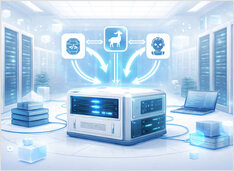
Troque modelos de LLM locais a quente sem alterar os clientes.
Em breve, você estará alternando entre vLLM, llama.cpp e mais — cada pilha em sua própria porta. Tudo a jusante ainda quer uma única URL base /v1; caso contrário, você continuará trocando portas, perfis e scripts pontuais. O llama-swap é o proxy /v1 antes dessas pilhas.
A maioria dos ambientes locais de IA começa com um modelo e um runtime.
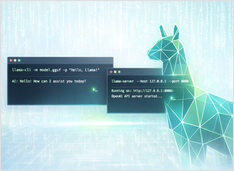
Execute modelos GGUF com o CLI e o servidor
llama.cpp é um motor de inferência em C/C++ para modelos GGUF: llama-cli para chat interativo, llama-completion para prompts roteirizados e llama-server para uma API HTTP compatível com OpenAI.
Guia do Assistente de IA OpenClaw
A maioria das configurações de IA local começa da mesma maneira: um modelo, um runtime e uma interface de chat.
Compare CMS headless: recursos, desempenho e casos de uso
Escolher a headless CMS correta pode fazer ou quebrar sua estratégia de gerenciamento de conteúdo. Vamos comparar três soluções de código aberto que influenciam como os desenvolvedores constroem aplicações orientadas a conteúdo.