Llm

Do Ollama ao vLLM: quando migrar seu servidor local de LLM

Do Ollama ao vLLM: quando migrar seu servidor local de LLM

Quando migrar do Ollama para o vLLM

Ollama é uma das formas mais simples de executar um modelo de linguagem local, mas a conveniência pode mascarar o momento em que um experimento local se torna um serviço de inferência compartilhado que necessita de melhor agendamento e observabilidade.

Mantendo Especificações, Testes e Código Sincronizados no Desenvolvimento de IA

Mantendo Especificações, Testes e Código Sincronizados no Desenvolvimento de IA

Evite que agentes de IA se desviem das especificações, testes e código.

Agentes de codificação com IA entregam funcionalidades rapidamente, mas especificações, testes e código se afastam silenciosamente uns dos outros. Este guia aborda um modelo de rastreabilidade, mapeamento de especificação para teste e de especificação para código, e as verificações de CI que detectam esse desvio antes de um merge.

GPUs para IA em 2026: NVIDIA, AMD e Intel Comparadas

GPUs para IA em 2026: NVIDIA, AMD e Intel Comparadas

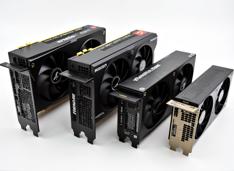
Comparação de GPUs de IA entre três fornecedores

O cenário do hardware de IA mudou significativamente em 2026, com NVIDIA, AMD e Intel competindo por desenvolvedores que necessitam de GPUs capazes de executar modelos de linguagem grandes (LLMs) e cargas de trabalho de inferência de IA localmente.

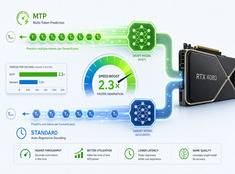
Decodificação Especulativa: Inferência de LLMs 20-50% Mais Rápida

Decodificação Especulativa: Inferência de LLMs 20-50% Mais Rápida

Inferência de LLM mais rápida sem perda de qualidade – um guia prático

Um modelo de 70B gera um token por passagem de frente, e cada passagem recarrega os pesos da VRAM, calcula a atenção através do contexto e sincroniza a memória. Entre os tokens, a GPU fica ociosa enquanto aguarda que as dependências sequenciais sejam resolvidas.