DevOps

Introdução rápida ao llama.cpp com CLI e servidor

Introdução rápida ao llama.cpp com CLI e servidor

Execute modelos GGUF com o CLI e o servidor

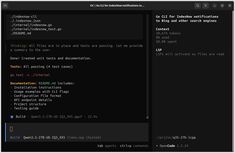
llama.cpp é um motor de inferência em C/C++ para modelos GGUF: llama-cli para chat interativo, llama-completion para prompts roteirizados e llama-server para uma API HTTP compatível com OpenAI.

Airtable para Desenvolvedores e DevOps: Planos, API, Webhooks e Exemplos em Go/Python

Airtable para Desenvolvedores e DevOps: Planos, API, Webhooks e Exemplos em Go/Python

Airtable - Limites do plano gratuito, API, webhooks, Go e Python.

O Airtable deve ser pensado como uma plataforma de aplicativos low-code construída em torno de uma interface de planilha “semelhante a banco de dados” colaborativa - excelente para criar rapidamente ferramentas operacionais (rastreadores internos, CRMs leves, pipelines de conteúdo, filas de avaliação de IA) onde usuários não desenvolvedores precisam de uma interface amigável, mas os desenvolvedores também precisam de uma superfície de API para automação e integração.

Garage vs MinIO vs AWS S3: Comparação de Objetos de Armazenamento e Matriz de Funcionalidades

Garage vs MinIO vs AWS S3: Comparação de Objetos de Armazenamento e Matriz de Funcionalidades

AWS S3, Garage ou MinIO — visão geral e comparação.

AWS S3 continua a ser a linha de base “padrão” para armazenamento de objetos: é totalmente gerido, possui consistência forte e foi concebido para uma durabilidade e disponibilidade extremamente elevadas.
Garage e MinIO são alternativas autoalojadas e compatíveis com S3: o Garage foi desenhado para clusters pequenos a médios, leves e geo-distribuídos, enquanto o MinIO enfatiza a ampla cobertura de funcionalidades da API S3 e o alto desempenho em implementações de maior escala.

Observabilidade para Sistemas de LLM: Métricas, Traços, Logs e Testes em Produção

Observabilidade para Sistemas de LLM: Métricas, Traços, Logs e Testes em Produção

Estratégia de observabilidade ponta a ponta para inferência de LLM e aplicações de LLM

Os sistemas de LLM falham de maneiras que a monitorização tradicional de APIs não consegue revelar — as filas enchem-se silenciosamente, a memória da GPU satura-se muito antes de a CPU parecer ocupada e a latência explode na camada de loteamento (batching) em vez da camada de aplicação.

Wayland versus X11: Comparação de 2026

Wayland versus X11: Comparação de 2026

Servidores de exibição modernos do Linux comparados

A paisagem do servidor de exibição Linux tem evoluído dramaticamente na última década. Wayland, que começou como um projeto ambicioso para substituir o envelhecido X11 (Sistema X Window), tornou-se agora o padrão nas principais distribuições Linux.