AI

Qwen 3.6 27B e 35B MTP vs Padrão em GPU de 16GB

Qwen 3.6 27B e 35B MTP vs Padrão em GPU de 16GB

MTP vs. decodificação padrão na RTX 4080 — benchmarks reais

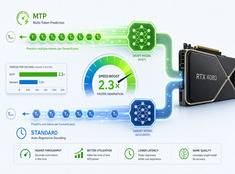
Testei o desempenho da decodificação especulativa (Previsão de Múltiplos Tokens, MTP) no Qwen 3.6 27B e 35B em uma RTX 4080 com 16 GB de VRAM.

PKM vs RAG vs Wiki vs Sistemas de Memória: Explicado com Clareza

PKM vs RAG vs Wiki vs Sistemas de Memória: Explicado com Clareza

Um mapa dos sistemas de conhecimento modernos

PKM, RAG, wikis, sistemas de memória de IA e, agora, fluxos de trabalho práticos assistidos por IA são frequentemente discutidos como se resolvessem o mesmo problema. Eles não o fazem. Todos lidam com conhecimento, mas operam em camadas diferentes:

Validação de Saída Estruturada de LLMs em Python que Funciona

Validação de Saída Estruturada de LLMs em Python que Funciona

Pare de interpretar vibes. Valide contratos.

A maioria dos tutoriais sobre “saída estruturada” de LLMs é superficial. Eles ensinam você a pedir JSON educadamente e depois torcer para que o modelo se comporte. Isso não é validação. Isso é otimismo com chaves.

Criação de Habilidades para o Agente Hermes — Estrutura e Boas Práticas do SKILL.md

Criação de Habilidades para o Agente Hermes — Estrutura e Boas Práticas do SKILL.md

Habilidades do autor Hermes que carregam rapidamente e funcionam de forma confiável

O Hermes Agent trata habilidades (skills) como o método padrão para ensinar fluxos de trabalho repetíveis. A documentação oficial as descreve como documentos de conhecimento sob demanda, alinhados com o formato aberto agentskills.io, carregados através de divulgação progressiva, de modo que o modelo vê primeiro um índice pequeno e só busca instruções completas quando uma tarefa realmente precisa delas.

Memória de Sistemas de IA — Conhecimento Persistente e Memória de Agentes

Memória de Sistemas de IA — Conhecimento Persistente e Memória de Agentes

Conhecimento persistente além de uma única thread de chat.

Esta seção reúne guias sobre conhecimento persistente e memória para sistemas de IA — como assistentes mantêm fatos, preferências e contexto destilado entre sessões sem encaixar cada token em um único prompt. Aqui, memória significa retenção intencional (fatos do usuário, resumos, armazenamento suportado por plugins), e não RAM de GPU ou pesos de modelos.