Инференс LLM выглядит как «еще один API» — до тех пор, пока не возникнут скачки задержки, не начнут накапливаться очереди, а ваши GPU не окажутся загружены по памяти на 95% без очевидной причины.
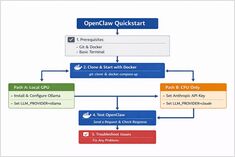
Локальная установка OpenClaw с использованием Ollama
OpenClaw — это автономный ИИ-ассистент, предназначенный для работы с локальными средами выполнения LLM, такими как Ollama, или с облачными моделями, такими как Claude Sonnet.
AWS S3 остается “стандартным” базовым решением для объектного хранения: это полностью управляемая, сильно согласованная система, разработанная для чрезвычайно высокой долговечности и доступности.
Garage и MinIO — это самонастраиваемые альтернативы, совместимые с S3: Garage предназначен для легковесных, геораспределенных кластеров малого и среднего размера, в то время как MinIO делает акцент на широком покрытии API S3 и высокой производительности в крупных развертываниях.
Гараж — это открытое, саморазмещаемое, совместимое с S3 объектное хранилище, предназначенное для небольших и средних развертываний с акцентом на устойчивость и геораспределение.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
Управляйте данными и моделями с помощью развернутых локально LLM
Хостинг больших языковых моделей (LLM) на собственных серверах обеспечивает контроль над данными, моделями и процессом инференса — это практический путь к суверенному искусственному интеллекту для команд, предприятий и целых стран.
Запуск больших языковых моделей локально обеспечивает конфиденциальность, возможность работы в автономном режиме и нулевые расходы на API.
Этот бенчмарк показывает, чего можно ожидать от 14 популярных
LLM на Ollama на видеокарте RTX 4080.
Экосистема Go продолжает процветать с инновационными проектами, охватывающими инструменты ИИ, самоуправляемые приложения и инфраструктуру разработчиков. Этот обзор анализирует самые популярные репозитории Go на GitHub в этом месяце.
Сегодня мы рассматриваем топовые потребительские графические процессоры и модули оперативной памяти. Конкретно я смотрю на цены на RTX-5080 и RTX-5090, а также на 32ГБ (2x16ГБ) DDR5 6000.
vLLM — это высокопроизводительный и энергоэффективный движок инференса и сервинга для больших языковых моделей (LLM), разработанный лабораторией Sky Computing Lab при Калифорнийском университете в Беркли (UC Berkeley).
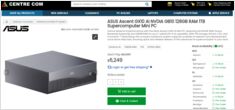
Актуальные цены в австралийских долларах от местных розничных продавцов уже доступны.
Компьютер
NVIDIA DGX Spark
(GB10 Grace Blackwell)
поступил в продажу в Австралии
у крупных розничных продавцов компьютеров с наличием на местных складах.
Если вы следите за
мировым ценообразованием и доступностью DGX Spark,
то вам будет интересно узнать, что в Австралии цены варьируются от 6 249 до 7 999 австралийских долларов в зависимости от конфигурации накопителей и конкретного продавца.
Размышления об использовании больших языковых моделей для саморазмещаемого Cognee
Выбор лучшей LLM для Cognee требует баланса между качеством построения графов, уровнями галлюцинаций и ограничениями оборудования. Cognee лучше всего работает с крупными моделями с низким уровнем галлюцинаций (32B+) через Ollama, но средние варианты подходят для более легких настроек.
Библиотека Python для Ollama теперь включает в себя нативные возможности поиска в интернете с Ollama. С несколькими строками кода вы можете дополнить свои локальные LLMs актуальной информацией из интернета, снижая вероятность галлюцинаций и повышая точность.
Выберите правильную векторную базу данных для вашего стека RAG
Выбор правильного векторного хранилища может стать решающим фактором для производительности, стоимости и масштабируемости вашего приложения RAG. Это комплексное сравнение охватывает самые популярные варианты на 2024–2025 годы.