Selfhosting

Mnemosyne для агента Hermes: быстрое начало работы с локальной памятью

Mnemosyne для агента Hermes: быстрое начало работы с локальной памятью

Локальная память Hermes с контролируемой записью.

Mnemosyne — это локальный провайдер памяти для Hermes Agent, который хранит рабочую память, структурированные факты, временные данные и эпизодическую историю в локальной базе SQLite — без хостинг-сервисов, без обязательных сетевых вызовов и с исключительно детальным контролем записи.
Самоусиливающиеся петли памяти в ИИ-агентах: причины и способы исправления

Самоусиливающиеся петли памяти в ИИ-агентах: причины и способы исправления

«Когда осмысленные выводы превращаются в новые доказательства.»

Персистентная память превращает агента из инструмента, которому каждый раз приходится объяснять контекст, в систему, способную передавать этот контекст дальше. Однако это открывает сценарий сбоя, которого нет в stateless-чат-режиме: интерпретация может стать частью памяти, извлекаться как факт и обосновывать более сильную версию самой себя.

Как безопасно выполнить миграцию с OpenClaw на Hermes Agent

Как безопасно выполнить миграцию с OpenClaw на Hermes Agent

Безопасный перевод, выходящий за рамки однострочного импорта

Миграция ИИ-ассистента — это не то же самое, что копирование конфигурации приложения. Сложная часть заключается в сохранении идентичности, памяти, поведения инструментов, запланированных задач и доступа к сообщениям без возникновения ситуации, когда два шлюза (gateway) работают как один и тот же бот.

llama.cpp против Ollama в 2026 году: какой рантайм выбрать?

llama.cpp против Ollama в 2026 году: какой рантайм выбрать?

«Когда llama-server превосходит Ollama»

Ollama и llama.cpp часто сравнивают, будто бы это конкурирующие движки вывода. Настоящий выбор — между управляемым сервисом моделей и набором инструментов, которым вы управляете напрямую.

ROCm и Vulkan для локального запуска LLM на GPU AMD: руководство на 2026 год

ROCm и Vulkan для локального запуска LLM на GPU AMD: руководство на 2026 год

Выберите правильный AMD-бэкенд для каждого движка

ROCm и Vulkan обе ускоряют работу GPU AMD для локального размещения LLM, но они не взаимозаменяемы. Правильный выбор зависит от движка, графического процессора и характера нагрузки.

KV Cache на GPU с 16 ГБ: Как действительно уместить длинный контекст

KV Cache на GPU с 16 ГБ: Как действительно уместить длинный контекст

Почему контекст 128K не работает на 16 ГБ

Модель может заявлять о поддержке контекстного окна в 128K, но проваливаться уже на 40K токенах на видеокарте с 16 ГБ. Архитектурный потолок никогда не обещал, что веса, KV-кэш, вычислительные буферы и системный композитор смогут одновременно уместиться на вашем устройстве.

Гравитация данных: реальная цена API-first подходов в ИИ

Гравитация данных: реальная цена API-first подходов в ИИ

Почему ваш стек ИИ становится всё более «липким» каждый месяц.

Каждый вызов API кажется простой транзакцией — пока их количество не накопится настолько, что ваши данные для тонкой настройки, системы оценки и схемы инструментов не окажутся привязаны к одному вендору, и переключение перестанет быть просто изменением маршрутизации.

Обслуживание LLM Wiki: дрейф, противоречия и рецензирование

Обслуживание LLM Wiki: дрейф, противоречия и рецензирование

Обеспечьте достоверность скомпилированных знаний

Неудача в использовании LLM Wiki наступает тогда, когда старые факты остаются правдоподобными, противоречия становятся гладкими, а сгенерированные резюме отдаляются от своих источников.

Syncthing для синхронизации файлов в системах самостоятельного хостинга знаний

Syncthing для синхронизации файлов в системах самостоятельного хостинга знаний

Частная синхронизация для локальных знаний.

Syncthing синхронизирует файлы между устройствами, которыми вы управляете, что делает его одним из самых практичных инструментов для создания собственной инфраструктуры знаний, позволяющей избежать привязки к облачным сервисам.

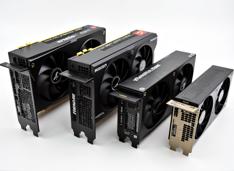
GPU для ИИ в 2026 году: сравнение NVIDIA, AMD и Intel

GPU для ИИ в 2026 году: сравнение NVIDIA, AMD и Intel

Сравнение AI-GPU от трёх производителей

Ландшафт аппаратных решений для ИИ значительно изменился в 2026 году: NVIDIA, AMD и Intel соревнуются за разработчиков, которым требуются GPU, способные запускать локальные большие языковые модели (LLM) и выполнять задачи инференса.

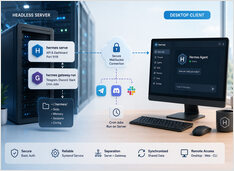
Агент Hermes: настройка безголового сервера и удалённого рабочего стола

Агент Hermes: настройка безголового сервера и удалённого рабочего стола

Сервер Headless Hermes с доступом по удаленному рабочему столу

Запуск агента Hermes на сервере без графического интерфейса (headless) при подключении с настольного клиента на другом компьютере требует наличия двух процессов на сервере и одного клиентского соединения.

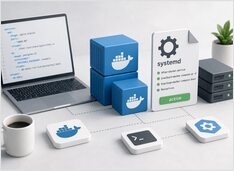
Запуск Docker Compose как службы Linux с помощью systemd

Запуск Docker Compose как службы Linux с помощью systemd

Запуск Docker Compose при загрузке, управляемый через systemd.

Docker Compose на Linux-сервере должен запускаться при загрузке, корректно останавливаться при выключении и переживать перезагрузки без ручного вмешательства.

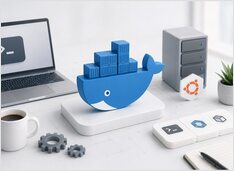
Установка Docker на Ubuntu: APT, Snap, Rootless — полное руководство 2026

Установка Docker на Ubuntu: APT, Snap, Rootless — полное руководство 2026

Выберите правильный путь установки Docker в Ubuntu.

Установка Docker на Ubuntu должна быть простой, но на практике несколько вариантов установки Docker конкурируют за одно и то же имя команды, каждый из которых имеет различную упаковку, поведение при обновлении и последствия для безопасности.

Устранение неполадок APT в Ubuntu: исправление сломанных пакетов, блокировок и ошибок GPG

Устранение неполадок APT в Ubuntu: исправление сломанных пакетов, блокировок и ошибок GPG

Исправьте APT в Ubuntu без гаданий.

Неудачи с APT — обычное явление на машинах с Ubuntu, которые используются длительное время. Они обычно возникают после обновления версии, изменения стороннего репозитория, удаления PPA, ручной установки пакета .deb или прерванного процесса установки пакетов.

Системы памяти в ИИ-ассистентах

Системы памяти в ИИ-ассистентах

Рабочая, структурная и поисковая память для ассистентов.

Память превращает ассистентов из реактивных в персистентные, но именно в ней множество систем тихо деградируют. Исследования утверждают, что разделения на краткосрочную и долгосрочную память больше недостаточно для современных агентных систем памяти; SDK от OpenAI и LangGraph указывают на более простую стек-модель — рабочая память, персистентное состояние и поиск (retrieval).

OpenClaw против Hermes Agent: звёзды, загрузки и использование в 2026 году

OpenClaw против Hermes Agent: звёзды, загрузки и использование в 2026 году

Звёзды, токены, загрузки — кто на самом деле побеждает?

Фреймворки AI-агентов с открытым исходным кодом стремительно набирают популярность на GitHub. Два проекта, лежащих в основе экосистемы самохостинг-систем ИИOpenClaw и Hermes Agent — настолько опередили остальных, что вся остальная ниша борется за отдаленное третье место.