LLM Hosting

llama.cpp против Ollama в 2026 году: какой рантайм выбрать?

llama.cpp против Ollama в 2026 году: какой рантайм выбрать?

«Когда llama-server превосходит Ollama»

Ollama и llama.cpp часто сравнивают, будто бы это конкурирующие движки вывода. Настоящий выбор — между управляемым сервисом моделей и набором инструментов, которым вы управляете напрямую.
ROCm и Vulkan для локального запуска LLM на GPU AMD: руководство на 2026 год

ROCm и Vulkan для локального запуска LLM на GPU AMD: руководство на 2026 год

Выберите правильный AMD-бэкенд для каждого движка

ROCm и Vulkan обе ускоряют работу GPU AMD для локального размещения LLM, но они не взаимозаменяемы. Правильный выбор зависит от движка, графического процессора и характера нагрузки.

Гравитация данных: реальная цена API-first подходов в ИИ

Гравитация данных: реальная цена API-first подходов в ИИ

Почему ваш стек ИИ становится всё более «липким» каждый месяц.

Каждый вызов API кажется простой транзакцией — пока их количество не накопится настолько, что ваши данные для тонкой настройки, системы оценки и схемы инструментов не окажутся привязаны к одному вендору, и переключение перестанет быть просто изменением маршрутизации.

Ollama и vLLM: когда стоит мигрировать локальный LLM-сервер

Ollama и vLLM: когда стоит мигрировать локальный LLM-сервер

Когда переходить с Ollama на vLLM

Ollama — один из самых простых способов запуска локальной языковой модели, но удобство может скрывать момент, когда локальный эксперимент превращается в общий сервис инференса, требующий лучшего планирования и наблюдаемости.

Выгрузка всех моделей маршрутизатора llama.cpp без перезапуска

Выгрузка всех моделей маршрутизатора llama.cpp без перезапуска

Свободная VRAM без остановки llama-server

Режим маршрутизации llama.cpp — одно из самых полезных изменений в llama-server за последние годы. Наконец-то локальным операторам LLM предоставляется опыт управления моделями, близкий к тому, к которому пользователи привыкли в Ollama, при этом сохраняются высокая производительность и низкоуровневый контроль, которые делают llama.cpp стоящими того, чтобы использовать их в первую очередь.

Быстрый старт с Vane (Perplexica 2.0), Ollama и llama.cpp

Быстрый старт с Vane (Perplexica 2.0), Ollama и llama.cpp

Самохостинг AI-поиска с локальными LLM

Vane — это один из наиболее прагматичных проектов в пространстве «поиска с использованием ИИ и цитированием»: самохостинговое средство ответов, которое сочетает в себе живой поиск в вебе с локальными или облачными LLM, сохраняя при этом полный контроль над всем стеком технологий.

TGI — Text Generation Inference: установка, настройка и устранение неполадок

TGI — Text Generation Inference: установка, настройка и устранение неполадок

Установите TGI, развертывайте быстро, отлаживайте ещё быстрее.

Text Generation Inference (TGI) обладает очень специфической энергетикой. Это не самый новый проект на улице инференса, но это тот, который уже научился, как происходит работа в продакшене, —

Удалённый доступ к Ollama через Tailscale или WireGuard без открытия публичных портов.

Удалённый доступ к Ollama через Tailscale или WireGuard без открытия публичных портов.

Доступ к Ollama удаленно без открытых публичных портов

Ollama чувствует себя наиболее комфортно, когда с ним обращаются как с локальным демоном: CLI и ваши приложения взаимодействуют с локальным HTTP-интерфейсом (loopback), а остальная сеть даже не знает о его существовании.

Ollama в Docker Compose с использованием GPU и постоянным хранилищем моделей

Ollama в Docker Compose с использованием GPU и постоянным хранилищем моделей

Ollama-сервер с приоритетом композинга, поддержкой GPU и сохранением состояния.

Ollama отлично работает на «голом» железе. Но становится еще интереснее, если рассматривать его как сервис: стабильный конечный пункт, зафиксированные версии, постоянное хранилище данных и GPU, который либо доступен, либо нет.

Ollama за обратным прокси-сервером Caddy или Nginx для потоковой передачи через HTTPS

Ollama за обратным прокси-сервером Caddy или Nginx для потоковой передачи через HTTPS

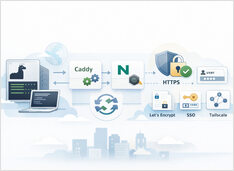
HTTPS для Ollama без нарушения потоковой передачи ответов.

Запуск Ollama через обратный прокси — самый простой способ обеспечить поддержку HTTPS, опциональный контроль доступа и предсказуемое поведение потоковой передачи данных.

Быстрый старт SGLang: установка, настройка и развертывание больших языковых моделей через API OpenAI

Быстрый старт SGLang: установка, настройка и развертывание больших языковых моделей через API OpenAI

Запускайте открытые модели быстро с помощью SGLang.

SGLang — это высокопроизводительный фреймворк для развертывания больших языковых и мультимодальных моделей, созданный для обеспечения низколатентного и высокопроизводительного вывода на устройствах от одной GPU до распределенных кластеров.

Быстрый старт: переключатель моделей llama.swap для локальных LLM, совместимых с OpenAI

Быстрый старт: переключатель моделей llama.swap для локальных LLM, совместимых с OpenAI

Горячая замена локальных LLM без изменения клиентов.

Вскоре вы будете жонглировать vLLM, llama.cpp и другими решениями — каждый стек на своем порту. Все downstream-системы все еще хотят один базовый URL /v1; иначе вы постоянно переставляете порты, профили и одноразовые скрипты. llama-swap — это прокси /v1 перед этими стеками.

Быстрый старт с LocalAI: запуск локальных LLM, совместимых с OpenAI

Быстрый старт с LocalAI: запуск локальных LLM, совместимых с OpenAI

Запустите собственные API, совместимые с OpenAI, с помощью LocalAI за несколько минут.

LocalAI — это самодостаточный сервер вывода с приоритетом на локальное использование, разработанный для работы как прямая замена OpenAI API для запуска ИИ-нагрузок на вашем собственном оборудовании (ноутбук, рабочая станция или сервер в центре обработки данных).

Быстрый старт с llama.cpp: CLI и сервер

Быстрый старт с llama.cpp: CLI и сервер

Как установить, настроить и использовать OpenCode

Я снова и снова возвращаюсь к llama.cpp для локального инференса — он предоставляет уровень контроля, который Ollama и другие инструменты скрывают за фасадом, и он просто работает. Легко запускать модели GGUF в интерактивном режиме через llama-cli или открывать HTTP API, совместимое с OpenAI, с помощью llama-server.

Самостоятельное размещение LLM и суверенитет ИИ

Самостоятельное размещение LLM и суверенитет ИИ

Управляйте данными и моделями с помощью развернутых локально LLM

Хостинг больших языковых моделей (LLM) на собственных серверах обеспечивает контроль над данными, моделями и процессом инференса — это практический путь к суверенному искусственному интеллекту для команд, предприятий и целых стран.