LLM Hosting

Быстрый старт с vLLM: высокопроизводительный инференс LLM — 2026

Быстрый старт с vLLM: высокопроизводительный инференс LLM — 2026

Быстрый вывод LLM с помощью OpenAI API

vLLM — это высокопроизводительный и энергоэффективный движок инференса и сервинга для больших языковых моделей (LLM), разработанный лабораторией Sky Computing Lab при Калифорнийском университете в Беркли (UC Berkeley).

Выбор правильного LLM для Cognee: локальная установка Ollama

Выбор правильного LLM для Cognee: локальная установка Ollama

Размышления об использовании больших языковых моделей для саморазмещаемого Cognee

Выбор лучшей LLM для Cognee требует баланса между качеством построения графов, уровнями галлюцинаций и ограничениями оборудования. Cognee лучше всего работает с крупными моделями с низким уровнем галлюцинаций (32B+) через Ollama, но средние варианты подходят для более легких настроек.

Ollama против vLLM и LM Studio: лучший способ запуска LLM локально в 2026 году?

Ollama против vLLM и LM Studio: лучший способ запуска LLM локально в 2026 году?

Сравнение лучших инструментов для локального развёртывания LLM в 2026 году. Зрелость API, поддержка аппаратного обеспечения, вызов инструментов и реальные сценарии использования.

Локальное запуск LLM-моделей сейчас становится практичным решением для разработчиков, стартапов и даже корпоративных команд. Но выбор правильного инструмента — Ollama, vLLM, LM Studio, LocalAI или других — зависит от ваших целей:

Шпаргалка по Docker Model Runner: команды и примеры

Шпаргалка по Docker Model Runner: команды и примеры

Быстрая справка по командам Docker Model Runner

Docker Model Runner (DMR) — это официальное решение Docker для запуска моделей ИИ локально, представленное в апреле 2025 года. Этот справочник предоставляет быстрый доступ ко всем основным командам, настройкам и лучшим практикам.

Docker Model Runner против Ollama (2026): что лучше для локальных LLMs?

Docker Model Runner против Ollama (2026): что лучше для локальных LLMs?

Сравните Docker Model Runner и Ollama для локальных LLM

Запуск больших языковых моделей (LLM) локально стал все более популярным из-за приватности, контроля затрат и возможностей офлайн-работы. Ландшафт значительно изменился в апреле 2025 года, когда Docker представил Docker Model Runner (DMR), свое официальное решение для развертывания моделей ИИ.

«Оллама-эншитификация — ранние признаки»

«Оллама-эншитификация — ранние признаки»

Моё видение текущего состояния разработки Ollama

Ollama быстро стал одним из самых популярных инструментов для локального запуска LLM. Его простой CLI и упрощённое управление моделями сделали его выбором номер один для разработчиков, которые хотят работать с ИИ-моделями вне облака.

Интерфейсы чатов для локальных экземпляров Ollama

Интерфейсы чатов для локальных экземпляров Ollama

Краткий обзор наиболее заметных интерфейсов для Ollama в 2025 году

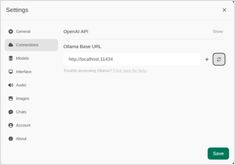
Локально размещённый Ollama позволяет запускать большие языковые модели на вашем собственном устройстве, но использование его через командную строку не очень удобно. Вот несколько открытых проектов, которые предоставляют интерфейсы в стиле ChatGPT, подключающиеся к локальному Ollama.

Тестирование Deepseek-R1 на Ollama

Тестирование Deepseek-R1 на Ollama

Сравнение двух моделей deepseek-r1 с двумя базовыми

DeepSeek’s первая генерация моделей рассуждений с производительностью, сопоставимой с OpenAI-o1, включает шесть плотных моделей, дистиллированных на основе Llama и Qwen.

Шпаргалка по CLI Ollama: команды ls, serve, run, ps и другие (обновление 2026)

Шпаргалка по CLI Ollama: команды ls, serve, run, ps и другие (обновление 2026)

Обновлённый список команд Ollama — ls, ps, run, serve и др.

Этот шпаргалка по Ollama CLI фокусируется на командах, которые вы используете каждый день (ollama ls, ollama serve, ollama run, ollama ps, управление моделями и типовые рабочие процессы), с примерами, которые можно скопировать и вставить.