Gpu

KV Cache на GPU с 16 ГБ: Как действительно уместить длинный контекст

KV Cache на GPU с 16 ГБ: Как действительно уместить длинный контекст

Почему контекст 128K не работает на 16 ГБ

Модель может заявлять о поддержке контекстного окна в 128K, но проваливаться уже на 40K токенах на видеокарте с 16 ГБ. Архитектурный потолок никогда не обещал, что веса, KV-кэш, вычислительные буферы и системный композитор смогут одновременно уместиться на вашем устройстве.
GPU для ИИ в 2026 году: сравнение NVIDIA, AMD и Intel

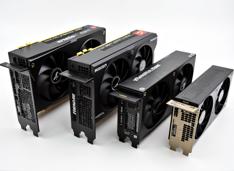
GPU для ИИ в 2026 году: сравнение NVIDIA, AMD и Intel

Сравнение AI-GPU от трёх производителей

Ландшафт аппаратных решений для ИИ значительно изменился в 2026 году: NVIDIA, AMD и Intel соревнуются за разработчиков, которым требуются GPU, способные запускать локальные большие языковые модели (LLM) и выполнять задачи инференса.

TGI — Text Generation Inference: установка, настройка и устранение неполадок

TGI — Text Generation Inference: установка, настройка и устранение неполадок

Установите TGI, развертывайте быстро, отлаживайте ещё быстрее.

Text Generation Inference (TGI) обладает очень специфической энергетикой. Это не самый новый проект на улице инференса, но это тот, который уже научился, как происходит работа в продакшене, —

Ollama в Docker Compose с использованием GPU и постоянным хранилищем моделей

Ollama в Docker Compose с использованием GPU и постоянным хранилищем моделей

Ollama-сервер с приоритетом композинга, поддержкой GPU и сохранением состояния.

Ollama отлично работает на «голом» железе. Но становится еще интереснее, если рассматривать его как сервис: стабильный конечный пункт, зафиксированные версии, постоянное хранилище данных и GPU, который либо доступен, либо нет.