Ai

LLM Guardrails на практике: что действительно работает

LLM Guardrails на практике: что действительно работает

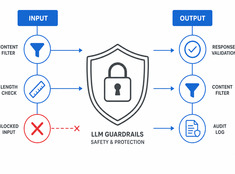
Управляйте риском, а не только моделью.

Языковые модели (LLM) непредсказуемы. Они галлюцинируют, утекают данные, генерируют вредоносный контент или отказывают в выполнению легитимных запросов. Ограничители (guardrails) constraining поведение модели без ущерба для её возможностей.

Оптимизация затрат в системах LLM: куда реально уходят деньги

Оптимизация затрат в системах LLM: куда реально уходят деньги

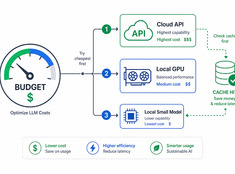
Тратьте токены там, где это действительно важно.

Стоимость LLM растёт линейно в зависимости от объёма использования. Система, обрабатывающая 10 000 запросов в день по цене 0,01 долл. за запрос, обходится в 100 долл. ежедневно — 365 долл. в год. В масштабах предприятия это превышает 10 000 долл.

Проектирование систем с использованием множества моделей: когда одной модели недостаточно

Проектирование систем с использованием множества моделей: когда одной модели недостаточно

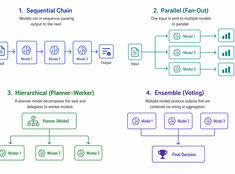
Выбирайте самый простой работающий паттерн.

Системы с одной моделью просты. Системы с множеством моделей мощны. Сложность не в выборе моделей — а в проектировании архитектуры, которая их оркестрирует.

Роутинг моделей: перестаньте использовать одну модель для всего

Роутинг моделей: перестаньте использовать одну модель для всего

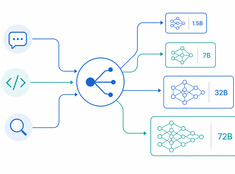
Подходящая модель для нужной задачи.

Запуск модели на 70 млрд параметров для суммирования письма из 200 слов — расточительство. А использование модели на 3 млрд параметров для рецензирования продакшен-кода — безрассудство. Большинство систем находится где-то посередине — и именно здесь на помощь приходит маршрутизация моделей.

Системы памяти в ИИ-ассистентах

Системы памяти в ИИ-ассистентах

Рабочая, структурная и поисковая память для ассистентов.

Память превращает ассистентов из реактивных в персистентные, но именно в ней множество систем тихо деградируют. Исследования утверждают, что разделения на краткосрочную и долгосрочную память больше недостаточно для современных агентных систем памяти; SDK от OpenAI и LangGraph указывают на более простую стек-модель — рабочая память, персистентное состояние и поиск (retrieval).

Архитектура ИИ-ассистента: LLM, память, инструменты, маршрутизация, наблюдаемость

Архитектура ИИ-ассистента: LLM, память, инструменты, маршрутизация, наблюдаемость

«Как на самом деле создаются серьезные ассистенты.»

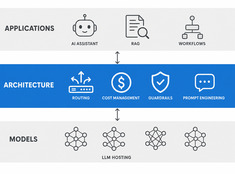
Промышленный ИИ-ассистент — это не «LLM с промптом». Это система, которая принимает намерение, сохраняет состояние, принимает решения о поиске или выполнении действий и предоставляет достаточно информации о времени выполнения для отладки сбоев.

OpenClaw против Hermes Agent: звёзды, загрузки и использование в 2026 году

OpenClaw против Hermes Agent: звёзды, загрузки и использование в 2026 году

Звёзды, токены, загрузки — кто на самом деле побеждает?

Фреймворки AI-агентов с открытым исходным кодом стремительно набирают популярность на GitHub. Два проекта, лежащих в основе экосистемы самохостинг-систем ИИ — OpenClaw и Hermes Agent — настолько опередили остальных, что вся остальная ниша борется за отдаленное третье место.

Qwen 3.6 27B и 35B MTP против Standard на GPU 16 ГБ

Qwen 3.6 27B и 35B MTP против Standard на GPU 16 ГБ

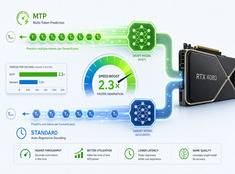
MTP и стандартная декодировка на RTX 4080 — реальные результаты тестов

Я протестировал производительность спекулятивного декодирования (Multi-Token Prediction, MTP) для моделей Qwen 3.6 27B и 35B на видеокарте RTX 4080 с 16 ГБ видеопамяти (VRAM).

Выгрузка всех моделей маршрутизатора llama.cpp без перезапуска

Выгрузка всех моделей маршрутизатора llama.cpp без перезапуска

Свободная VRAM без остановки llama-server

Режим маршрутизации llama.cpp — одно из самых полезных изменений в llama-server за последние годы. Наконец-то локальным операторам LLM предоставляется опыт управления моделями, близкий к тому, к которому пользователи привыкли в Ollama, при этом сохраняются высокая производительность и низкоуровневый контроль, которые делают llama.cpp стоящими того, чтобы использовать их в первую очередь.

LLM Wiki: систематизированные знания, которые невозможно заменить с помощью RAG

LLM Wiki: систематизированные знания, которые невозможно заменить с помощью RAG

Скомпилированные знания для ИИ-систем

Основная идея проста: скомпилированные знания более пригодны для повторного использования, чем извлеченные фрагменты. RAG стал стандартным ответом на простой вопрос — как предоставить LLM доступ к внешним знаниям?

PKM, RAG, Wiki и системы памяти: чёткое объяснение

PKM, RAG, Wiki и системы памяти: чёткое объяснение

«Карта современных систем знаний»

PKM, RAG, вики, системы памяти ИИ и сейчас практические рабочие процессы с помощью ИИ часто обсуждаются так, будто они решают одну и ту же проблему. Это не так. Все они имеют дело с знаниями, но работают на разных уровнях:

Валидация структурированного вывода LLM на Python, которая работает надёжно

Валидация структурированного вывода LLM на Python, которая работает надёжно

Перестаньте полагаться на интуицию. Валидируйте контракты.

Большинство руководств по «структурированному выводу» (structured output) для больших языковых моделей (LLM) не обладают должной серьезностью. Они учат вас вежливо просить модель выдавать JSON и затем надеяться, что она поступит правильно. Это не валидация. Это оптимизм, обернутый в фигурные скобки.

Справочник по параметрам агентного вывода LLM для Qwen и Gemma

Справочник по параметрам агентного вывода LLM для Qwen и Gemma

Справочное руководство по настройке агентов LLM

Эта страница представляет собой практическое руководство по настройке агентов на базе LLM (температура, top_p, top_k, штрафы и их взаимодействие в многоступенчатых рабочих процессах с интенсивным использованием инструментов).

Голосовое управление Hermes с вашего телефона

Голосовое управление Hermes с вашего телефона

Общайтесь с Hermes со своего телефона

Вы уже общаетесь с агентом Hermes через телефон, используя текстовые сообщения. Теперь вы хотите говорить с ним напрямую и получать ответы голосом. Как правило, это правильное решение, особенно если вы уже используете Hermes как постоянно работающего автономного ассистента. Ввод длинных подсказок на маленьком экране медленный и подвержен ошибкам.