Ai

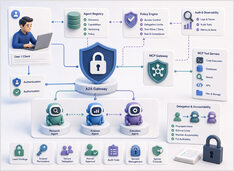
Безопасность агентов A2A и MCP: идентификация, делегирование и журналы аудита

Безопасность агентов A2A и MCP: идентификация, делегирование и журналы аудита

Безопасность протокола определяет, кто может действовать, а не модель.

Инъекция промптов привлекает основное внимание в области безопасности систем на базе больших языковых моделей (LLM), и это заслужено, но это не вся проблема, когда агенты начинают вызывать инструменты и делегировать работу другим агентам.
A2A-стриминг и асинхронные задачи для длительных агентных рабочих процессов

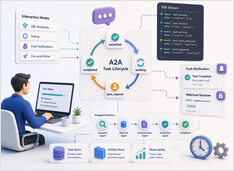
A2A-стриминг и асинхронные задачи для длительных агентных рабочих процессов

Долгоживущие A2A-задачи продолжают существовать после завершения чат-сессий.

Большинство демонстраций AI-агентов по-прежнему ведут себя как чат-завершения с дополнительными шагами: вы отправляете промпт, ждете несколько секунд и получаете ответ в одном сообщении.

Спекулятивное декодирование: ускорение инференса LLM на 20–50%

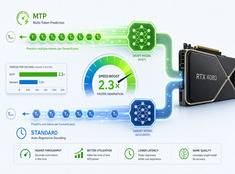
Спекулятивное декодирование: ускорение инференса LLM на 20–50%

Более быстрый инференс LLM без потери качества — практическое руководство

Модель 70B генерирует один токен за один прямой проход (forward pass), и каждый проход перезагружает веса из видеопамяти (VRAM), вычисляет внимание (attention) для всего контекста и синхронизирует память. Между токенами GPU простаивает, ожидая разрешения последовательных зависимостей.

Что такое протокол A2A? Разбираем Agent Cards и Tasks

Что такое протокол A2A? Разбираем Agent Cards и Tasks

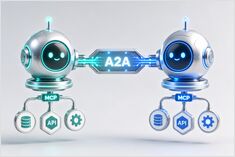
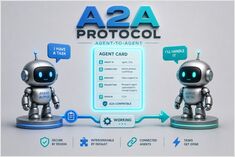
A2A превращает агентов в равноправных участников сети.

Протокол A2A (Agent-to-Agent Protocol), аббревиатура от Agent2Agent Protocol, представляет собой открытый стандарт для взаимодействия между независимыми системами ИИ-агентов.

LLM Guardrails на практике: что действительно работает

LLM Guardrails на практике: что действительно работает

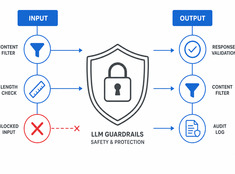
Управляйте риском, а не только моделью.

Языковые модели (LLM) непредсказуемы. Они галлюцинируют, утекают данные, генерируют вредоносный контент или отказывают в выполнению легитимных запросов. Ограничители (guardrails) constraining поведение модели без ущерба для её возможностей.

Маршрутизация моделей: перестаньте использовать одну модель для всего

Маршрутизация моделей: перестаньте использовать одну модель для всего

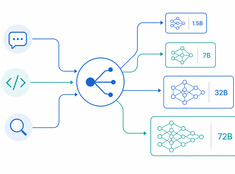
Правильная модель для правильной задачи.

Запуск модели с 70 миллиардами параметров для суммаризации электронного письма из 200 слов — это расточительство. Запуск модели с 3 миллиардами параметров для ревью продакшн-кода — это безрассудство. Большинство систем находятся где-то посередине, и именно здесь в игру вступает роутинг моделей (маршрутизация запросов).

Оптимизация затрат для систем LLM: куда на самом деле уходит деньги

Оптимизация затрат для систем LLM: куда на самом деле уходит деньги

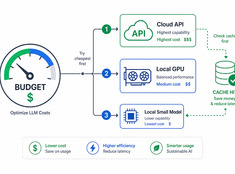
Тратьте токены там, где они действительно важны.

Стоимость использования больших языковых моделей (LLM) растет линейно в зависимости от объема запросов. Система, обрабатывающая 10 000 запросов в день по цене $0,01 за запрос, обходится в $100 ежедневно — это $365 в год. В корпоративном масштабе эта сумма превышает $10 000.

Проектирование многомоделевых систем: когда одной модели недостаточно

Проектирование многомоделевых систем: когда одной модели недостаточно

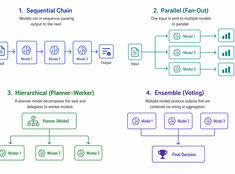
Выберите самый простой работающий паттерн.

Системы с одной моделью просты. Системы с несколькими моделями мощны. Сложность заключается не в выборе моделей, а в проектировании архитектуры, которая ими управляет.

Системы памяти в ИИ-ассистентах

Системы памяти в ИИ-ассистентах

Рабочая, структурная и поисковая память для ассистентов.

Память превращает ассистентов из реактивных в персистентные, но именно в ней множество систем тихо деградируют. Исследования утверждают, что разделения на краткосрочную и долгосрочную память больше недостаточно для современных агентных систем памяти; SDK от OpenAI и LangGraph указывают на более простую стек-модель — рабочая память, персистентное состояние и поиск (retrieval).

Архитектура ИИ-ассистента: LLM, память, инструменты, маршрутизация, наблюдаемость

Архитектура ИИ-ассистента: LLM, память, инструменты, маршрутизация, наблюдаемость

Как на самом деле создаются серьезные ассистенты.

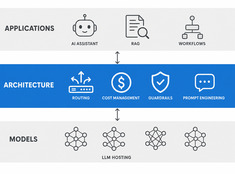
Продолжающий работу ИИ-ассистент — это не «языковая модель с промптом». Это система, которая принимает намерения пользователя, сохраняет состояние, принимает решения о том, когда извлекать данные или выполнять действия, и предоставляет достаточно деталей времени выполнения для отладки сбоев.

OpenClaw против Hermes Agent: звёзды, загрузки и использование в 2026 году

OpenClaw против Hermes Agent: звёзды, загрузки и использование в 2026 году

Звёзды, токены, загрузки — кто на самом деле побеждает?

Фреймворки AI-агентов с открытым исходным кодом стремительно набирают популярность на GitHub. Два проекта, лежащих в основе экосистемы самохостинг-систем ИИOpenClaw и Hermes Agent — настолько опередили остальных, что вся остальная ниша борется за отдаленное третье место.