Быстрый старт и шпаргалка по диаграммам Mermaid для разработчиков

Быстрый старт и шпаргалка по диаграммам Mermaid для разработчиков

Диаграммы как код, без лишних сложностей.

Mermaid — это текстовый инструмент для создания диаграмм, предназначенный для тех, кто предпочитает описывать диаграммы текстом, а не перетаскивать блоки на холсте. Он использует синтаксис, похожий на Markdown, для описания блок-схем, диаграмм последовательностей, диаграмм классов, автоматов состояний, временных шкал, диаграмм Ганта, диаграмм сущностей и связей и многого другого.
Цифровые сады: выращивайте знания, а не просто публикуйте их

Цифровые сады: выращивайте знания, а не просто публикуйте их

Публикуйте знания, которые развиваются, а не просто посты.

Доминирующая модель публикации знаний в Интернете практически не изменилась с начала 2000-х годов: написать что-то, отредактировать, опубликовать и двигаться дальше.

Метод PARA для инженеров: организация знаний по действиям

Метод PARA для инженеров: организация знаний по действиям

Организуйте заметки по действиям, а не по темам.

Организация заметок по темам кажется логичной, пока у вас нет заметок о PostgreSQL в пяти разных папках и вы не можете найти ту, которая важна для решения сегодняшней проблемы.

Заметки, которые не теряют актуальности: составляйте заметки, которые приносят всё большую пользу с течением времени

Заметки, которые не теряют актуальности: составляйте заметки, которые приносят всё большую пользу с течением времени

Заметки, которые улучшаются, а не приходят в негодность.

Большинство инженерных заметок пишутся один раз и забываются. Вы фиксируете что-то во время отладки, вставляете это в какое-то место и находите через два года, не имея контекста, почему это было важно.

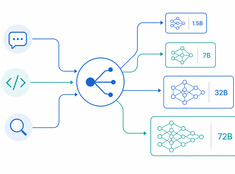
Роутинг моделей: перестаньте использовать одну модель для всего

Роутинг моделей: перестаньте использовать одну модель для всего

Подходящая модель для нужной задачи.

Запуск модели на 70 млрд параметров для суммирования письма из 200 слов — расточительство. А использование модели на 3 млрд параметров для рецензирования продакшен-кода — безрассудство. Большинство систем находится где-то посередине — и именно здесь на помощь приходит маршрутизация моделей.

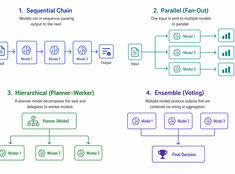
Проектирование систем с использованием множества моделей: когда одной модели недостаточно

Проектирование систем с использованием множества моделей: когда одной модели недостаточно

Выбирайте самый простой работающий паттерн.

Системы с одной моделью просты. Системы с множеством моделей мощны. Сложность не в выборе моделей — а в проектировании архитектуры, которая их оркестрирует.

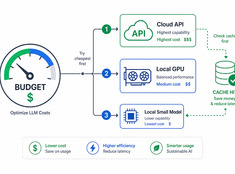
Оптимизация затрат в системах LLM: куда реально уходят деньги

Оптимизация затрат в системах LLM: куда реально уходят деньги

Тратьте токены там, где это действительно важно.

Стоимость LLM растёт линейно в зависимости от объёма использования. Система, обрабатывающая 10 000 запросов в день по цене 0,01 долл. за запрос, обходится в 100 долл. ежедневно — 365 долл. в год. В масштабах предприятия это превышает 10 000 долл.

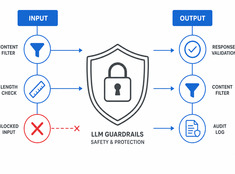
LLM Guardrails на практике: что действительно работает

LLM Guardrails на практике: что действительно работает

Управляйте риском, а не только моделью.

Языковые модели (LLM) непредсказуемы. Они галлюцинируют, утекают данные, генерируют вредоносный контент или отказывают в выполнению легитимных запросов. Ограничители (guardrails) constraining поведение модели без ущерба для её возможностей.

Системы памяти в ИИ-ассистентах

Системы памяти в ИИ-ассистентах

Рабочая, структурная и поисковая память для ассистентов.

Память превращает ассистентов из реактивных в персистентные, но именно в ней множество систем тихо деградируют. Исследования утверждают, что разделения на краткосрочную и долгосрочную память больше недостаточно для современных агентных систем памяти; SDK от OpenAI и LangGraph указывают на более простую стек-модель — рабочая память, персистентное состояние и поиск (retrieval).

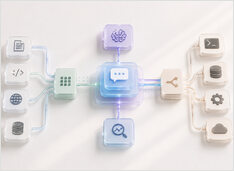
Архитектура ИИ-ассистента: LLM, память, инструменты, маршрутизация, наблюдаемость

Архитектура ИИ-ассистента: LLM, память, инструменты, маршрутизация, наблюдаемость

«Как на самом деле создаются серьезные ассистенты.»

Промышленный ИИ-ассистент — это не «LLM с промптом». Это система, которая принимает намерение, сохраняет состояние, принимает решения о поиске или выполнении действий и предоставляет достаточно информации о времени выполнения для отладки сбоев.

OpenClaw против Hermes Agent: звёзды, загрузки и использование в 2026 году

OpenClaw против Hermes Agent: звёзды, загрузки и использование в 2026 году

Звёзды, токены, загрузки — кто на самом деле побеждает?

Фреймворки AI-агентов с открытым исходным кодом стремительно набирают популярность на GitHub. Два проекта, лежащих в основе экосистемы самохостинг-систем ИИ — OpenClaw и Hermes Agent — настолько опередили остальных, что вся остальная ниша борется за отдаленное третье место.

Qwen 3.6 27B и 35B MTP против Standard на GPU 16 ГБ

Qwen 3.6 27B и 35B MTP против Standard на GPU 16 ГБ

MTP и стандартная декодировка на RTX 4080 — реальные результаты тестов

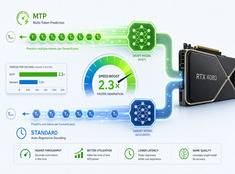
Я протестировал производительность спекулятивного декодирования (Multi-Token Prediction, MTP) для моделей Qwen 3.6 27B и 35B на видеокарте RTX 4080 с 16 ГБ видеопамяти (VRAM).

Выгрузка всех моделей маршрутизатора llama.cpp без перезапуска

Выгрузка всех моделей маршрутизатора llama.cpp без перезапуска

Свободная VRAM без остановки llama-server

Режим маршрутизации llama.cpp — одно из самых полезных изменений в llama-server за последние годы. Наконец-то локальным операторам LLM предоставляется опыт управления моделями, близкий к тому, к которому пользователи привыкли в Ollama, при этом сохраняются высокая производительность и низкоуровневый контроль, которые делают llama.cpp стоящими того, чтобы использовать их в первую очередь.

Получение данных против репрезентации в системах знаний

Получение данных против репрезентации в системах знаний

Поиск — это не структура знаний

Большинство современных систем знаний оптимизируют процесс поиска, и это вполне понятно. Поиск нагляден, его легко продемонстрировать, и он кажется магией, когда работает. Введи вопрос — получи ответ.

Подписаться

Получайте новые материалы про системы, инфраструктуру и AI engineering.