Спекулятивное декодирование: ускорение инференса LLM на 20–50%
Более быстрый инференс LLM без потери качества — практическое руководство
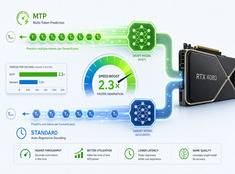
Модель 70B генерирует один токен за один прямой проход (forward pass), и каждый проход перезагружает веса из видеопамяти (VRAM), вычисляет внимание (attention) для всего контекста и синхронизирует память. Между токенами GPU простаивает, ожидая разрешения последовательных зависимостей.