Llm

Системы памяти в ИИ-ассистентах

Системы памяти в ИИ-ассистентах

Рабочая, структурная и поисковая память для ассистентов.

Память превращает ассистентов из реактивных в персистентные, но именно в ней множество систем тихо деградируют. Исследования утверждают, что разделения на краткосрочную и долгосрочную память больше недостаточно для современных агентных систем памяти; SDK от OpenAI и LangGraph указывают на более простую стек-модель — рабочая память, персистентное состояние и поиск (retrieval).
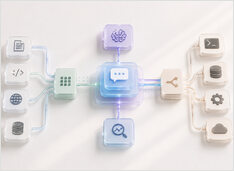
Архитектура ИИ-ассистента: LLM, память, инструменты, маршрутизация, наблюдаемость

Архитектура ИИ-ассистента: LLM, память, инструменты, маршрутизация, наблюдаемость

Как на самом деле создаются серьезные ассистенты.

Продолжающий работу ИИ-ассистент — это не «языковая модель с промптом». Это система, которая принимает намерения пользователя, сохраняет состояние, принимает решения о том, когда извлекать данные или выполнять действия, и предоставляет достаточно деталей времени выполнения для отладки сбоев.

OpenClaw против Hermes Agent: звёзды, загрузки и использование в 2026 году

OpenClaw против Hermes Agent: звёзды, загрузки и использование в 2026 году

Звёзды, токены, загрузки — кто на самом деле побеждает?

Фреймворки AI-агентов с открытым исходным кодом стремительно набирают популярность на GitHub. Два проекта, лежащих в основе экосистемы самохостинг-систем ИИOpenClaw и Hermes Agent — настолько опередили остальных, что вся остальная ниша борется за отдаленное третье место.

Qwen 3.6 27B и 35B MTP по сравнению со стандартными моделями на GPU с 16 ГБ видеопамяти

Qwen 3.6 27B и 35B MTP по сравнению со стандартными моделями на GPU с 16 ГБ видеопамяти

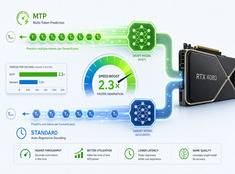
MTP и стандартное декодирование на RTX 4080 — реальные бенчмарки

Я протестировал производительность спекулятивного декодирования (Multi-Token Prediction, MTP) в моделях Qwen 3.6 27B и 35B на видеокарте RTX 4080 с 16 ГБ видеопамяти (VRAM).

Выгрузка всех моделей маршрутизатора llama.cpp без перезапуска

Выгрузка всех моделей маршрутизатора llama.cpp без перезапуска

Свободная VRAM без остановки llama-server

Режим маршрутизации llama.cpp — одно из самых полезных изменений в llama-server за последние годы. Наконец-то локальным операторам LLM предоставляется опыт управления моделями, близкий к тому, к которому пользователи привыкли в Ollama, при этом сохраняются высокая производительность и низкоуровневый контроль, которые делают llama.cpp стоящими того, чтобы использовать их в первую очередь.

LLM Wiki: систематизированные знания, которые невозможно заменить с помощью RAG

LLM Wiki: систематизированные знания, которые невозможно заменить с помощью RAG

Скомпилированные знания для ИИ-систем

Основная идея проста: скомпилированные знания более пригодны для повторного использования, чем извлеченные фрагменты. RAG стал стандартным ответом на простой вопрос — как предоставить LLM доступ к внешним знаниям?

Валидация структурированного вывода LLM на Python, которая работает надёжно

Валидация структурированного вывода LLM на Python, которая работает надёжно

Перестаньте полагаться на интуицию. Валидируйте контракты.

Большинство руководств по «структурированному выводу» (structured output) для больших языковых моделей (LLM) не обладают должной серьезностью. Они учат вас вежливо просить модель выдавать JSON и затем надеяться, что она поступит правильно. Это не валидация. Это оптимизм, обернутый в фигурные скобки.

Справочник по параметрам агентного вывода LLM для Qwen и Gemma

Справочник по параметрам агентного вывода LLM для Qwen и Gemma

Справочное руководство по настройке агентов LLM

Эта страница представляет собой практическое руководство по настройке агентов на базе LLM (температура, top_p, top_k, штрафы и их взаимодействие в многоступенчатых рабочих процессах с интенсивным использованием инструментов).

Голосовое управление Hermes с вашего телефона

Голосовое управление Hermes с вашего телефона

Общайтесь с Hermes со своего телефона

Вы уже общаетесь с агентом Hermes через телефон, используя текстовые сообщения. Теперь вы хотите говорить с ним напрямую и получать ответы голосом. Как правило, это правильное решение, особенно если вы уже используете Hermes как постоянно работающего автономного ассистента. Ввод длинных подсказок на маленьком экране медленный и подвержен ошибкам.

Канбан в Hermes Agent для самохостинга рабочих процессов LLM

Канбан в Hermes Agent для самохостинга рабочих процессов LLM

Управляйте загрузкой Hermes Kanban в вашей собственной LLM

Агент Hermes поставляется с доской в стиле Канбан и шлюзом Hermes Gateway, который может перегрузить вашу локально развернутую модель LLM, если одновременно будет отправлено слишком много задач.

Создание навыков для агента Hermes — структура и лучшие практики файла SKILL.md

Создание навыков для агента Hermes — структура и лучшие практики файла SKILL.md

Авторы Hermes умеют создавать быстрые и надёжные плагины

Hermes Agent рассматривает навыки (skills) как основной способ обучения повторяемым рабочим процессам. Официальная документация описывает их как документы знаний по запросу, соответствующие открытому формату agentskills.io, загружаемые через механизм постепенного раскрытия, при котором модель сначала видит небольшой индекс и загружает полные инструкции только тогда, когда задача действительно этого требует.

Практическое руководство NemoClaw по безопасным операциям с OpenClaw в 2026 году

Практическое руководство NemoClaw по безопасным операциям с OpenClaw в 2026 году

Запускайте OpenClaw безопасно с помощью NemoClaw

Большинство стеков ИИ-агентов по-прежнему рассматривают безопасность как проблему, которую нужно решать после демонстрации. NemoClaw исходит из противоположного предположения и делает изоляцию, политики и маршрутизацию настройками по умолчанию с первого дня.

Память ИИ-систем — постоянные знания и память агента

Память ИИ-систем — постоянные знания и память агента

Персистентные знания, выходящие за рамки одного чат-потока.

Этот раздел собирает руководства по персистентным знаниям и памяти для ИИ-систем — как ассистенты сохраняют факты, предпочтения и выделенный контекст между сессиями, не перегружая каждый токен в одном промпте. Здесь под память понимается целенаправленное хранение (факты о пользователе, резюме, хранилища на основе плагинов), а не видеопамять GPU или веса модели.

Сравнение провайдеров памяти агентов: политика захвата и self-hosting

Сравнение провайдеров памяти агентов: политика захвата и self-hosting

Теперь политика захвата важна не меньше, чем recall.

Обновлено в сентябре 2026: добавлены Mnemosyne и Memori, расширены настройки Honcho и Hindsight, а также добавлено сравнение политик захвата данных (capture policy) параллельно с исходной таблицей инфраструктуры.