
Ретроспективный анализ для агента Hermes: автономная память с локальными LLM
Персистентная память Hermes на вашем собственном оборудовании.
Самохостинговому ИИ-агенту требуется нечто большее, чем длинное контекстное окно. Ему нужен способ сохранять полезные факты, извлекать прежние решения и пересматривать свои знания по мере эволюции проектов.
Hermes Agent поставляется с встроенными файлами памяти, но внешний провайдер может обеспечить гораздо более богатый поиск данных между сессиями. Hindsight — один из наиболее интересных вариантов в этой области. В этом руководстве описывается его установка для Hermes без облачного инференса: сначала как единый Docker-контейнер, а затем в связке с существующим сервером PostgreSQL и отдельными локальными эндпоинтами моделей.
Руководство охватывает развертывание, выбор и настройку локальных моделей эмбеддингов, реранкинга и генерации, управление тем, что функция auto-retain записывает в банк, подключение Hermes и операционный слой: резервное копирование, перенос встроенного банка на отдельный сервер PostgreSQL и ежедневное обслуживание банка. В примерах используется целенаправленная схема портов — 8080 для основного сервера llama.cpp, 8081 для эмбеддингов, 8082 для реранкинга, 11434 для Ollama — поэтому замените их на те порты, которые вы уже используете, и не оставляйте небольшие серверы на порту основной модели.
Что делает Hindsight
Hindsight — это постоянный движок памяти для агентов с тремя основными операциями: retain (сохранение), recall (извлечение) и reflect (рефлексия/синтез). Retain извлекает и хранит информацию; recall объединяет семантический, ключевой, графовый и временной поиск; reflect синтезирует ответ на основе накопленных воспоминаний. Фоновая консолидация может превращать пересекающиеся наблюдения в более полезный слой знаний.
Это не просто база данных векторов. Векторное хранилище может находить похожие отрывки, но система памяти также должна сохранять хронологию, границы проектов, противоречащие друг другу доказательства и изменения в решениях. Эти виды отказов рассматриваются в статье самовоспроизводящиеся циклы памяти.
Для обзора рынка см. сравнение провайдеров памяти для агентов. Встроенные MEMORY.md, USER.md и режимы памяти Hermes описаны в руководстве система памяти Hermes Agent. Таким образом, в этой статье предполагается, что вы знаете, как работает встроенный слой.
Почему стоит перейти за пределы Mnemosyne
Mnemosyne для Hermes предлагает привлекательные идеи с приоритетом локальности, включая хранение в SQLite и гибридный поиск. На практике ограничения установки, совместимость версий, поведение одобрения записи и быстрые изменения вокруг предварительных релизов 4.0 могут затруднить предсказуемую эксплуатацию. Это операционные проблемы, а не доказательство того, что модель памяти Mnemosyne фундаментально дефектна.
У Hindsight тоже есть зависимости: его Docker-образ и локальные модели могут потреблять значительный объем дискового пространства. Запуск его API в качестве независимой службы, с инференсом где-то в другом месте, позволяет изолировать обновления и устранение неполадок от самого агента.
Выбор варианта развертывания
| Компонент | A: Единый контейнер | B: Существующий сервер PostgreSQL |
|---|---|---|
| API и UI Hindsight | Docker-контейнер | Docker-контейнер |
| PostgreSQL | Встроенный pg0 в контейнере |
Существующий сервер PostgreSQL |
| Генеративная LLM | Внешний llama.cpp | Внешний llama.cpp |
| Эмбеддинги | Локальные по умолчанию или внешние | Внешний Ollama или llama.cpp |
| Реранкинг | Локальный по умолчанию или внешний | Внешний сервер реранкинга |
| Лучше всего подходит для | Быстрой оценки | Долгосрочной, изолированной установки |
Здесь «единый» означает, что API, UI и база данных Hindsight находятся в одном контейнере; при этом LLM для инференса по-прежнему размещается в другом месте. Это намеренный выбор: официальный Docker-образ Hindsight не содержит готового к использованию локального генеративного сервера llama.cpp.
Используйте адреса, доступные в локальной сети (LAN), а не localhost, для служб, работающих на другом хосте. Ограничьте доступ к этим портам доверенными клиентами; в примерах используются ключи dummy — это просто заглушки для совместимости, а не аутентификация.
Вариант A: Единый контейнер Hindsight
Это самый простой способ оценить Hindsight, не заполняя ВМ Hermes зависимостями Python, Torch и локальных моделей. Контейнер запускает Hindsight и встроенный PostgreSQL, в то время как ваша основная LLM llama.cpp обрабатывает извлечение памяти и рефлексию.
Здесь важны два тега образа. ghcr.io/vectorize-io/hindsight:latest — это большой образ (примерно 9 ГБ на AMD64), так как он содержит эмбеддер BGE, реранкер MiniLM и встроенный PostgreSQL. latest-slim составляет примерно 500 МБ и ожидает, что эти две модели будут находиться в другом месте, что и требуется, когда вы направляете Hindsight на настройку эмбеддингов и реранкинга в разделе «Запуск и настройка локальных моделей». После успешной проверки состояния зафиксируйте конкретный тег: подвижный тег — плохой выбор для базы данных, которую вы намерены сохранять.
Создайте директорию и файл Compose на хосте Hindsight:
mkdir -p ~/services/hindsight
cd ~/services/hindsight
cat > compose.yaml <<'YAML'
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest
    container_name: hindsight
    restart: unless-stopped
    shm_size: 1gb
    extra_hosts:
      - "host.docker.internal:host-gateway"
    ports:
      - "8888:8888"  # API памяти
      - "9999:9999"  # UI управления
    environment:
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://IP_РАБОЧЕЙ_СТАЦИИ:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
    volumes:
      - hindsight-pg0:/home/hindsight/.pg0
volumes:
  hindsight-pg0:
YAML
Замените IP_РАБОЧЕЙ_СТАЦИИ на адрес хоста, где запущен llama.cpp. На Linux host.docker.internal разрешается только если контейнер declares маппинг host-gateway, показанный выше; без него базовый URL http://host.docker.internal:8080/v1 никуда не ведет. Резервирование общего пространства памяти в 1 ГБ особенно полезно для индексации встроенного PostgreSQL; небольшой по умолчанию /dev/shm в Docker может вызывать сбои. Именованный том сохраняет базу данных при пересоздании контейнера, а альтернатива с bind mount должна принадлежать uid 1000 (пользователь внутри образа).
HINDSIGHT_API_WORKER_ID должен оставаться стабильным между пересозданиями — по умолчанию в Docker это имя хоста контейнера, и задача, которая была в процессе выполнения, когда контейнер умер, останется застрявшей под старым идентификатором воркера.
docker compose up -d
docker compose logs -f --tail=100
curl -f http://localhost:8888/health
Если ваша установленная версия Hindsight открывает health по другому пути, проверьте http://localhost:8888/docs и логи контейнера. Панель управления обычно доступна по адресу http://ХОСТ_HINDSIGHT:9999. Как только базовое развертывание заработает, вы также можете направить провайдеры эмбеддингов и реранкинга на конфигурацию из раздела «Запуск и настройка локальных моделей», вместо загрузки моделей по умолчанию внутри контейнера.
Не открывайте порты 8888 или 9999 непосредственно в Интернет. Используйте частную сеть или аутентифицированный обратный прокси. Встроенный PostgreSQL удобен для тестов, но управляемая извне база данных легче поддается резервному копированию и обслуживанию. Банк, который уже существует в этом томе, перемещается вместе с дампом и восстановлением в разделе Перенос встроенной базы данных на выделенный сервер.
Вариант B: Hindsight с существующим сервером PostgreSQL
Для долгосрочной установки я предпочитаю держать API Hindsight, базу данных и эндпоинты инференса отдельно. ВМ Hindsight может оставаться небольшой, так как она запускает оркестрацию и HTTP-сервисы, а не тяжелые модели. Приведенные ниже шаги начинаются с пустого сервера. Банк, который уже находится в томе Варианта A, перемещается в разделе Перенос встроенной базы данных на выделенный сервер.
Подготовка PostgreSQL и pgvector
Hindsight требует PostgreSQL версии 14 или новее и векторное расширение в базе данных hindsight. Расширение устанавливается отдельно для каждой базы данных: установка пакета на сервере не дает ничего, пока в ней не выполнится CREATE EXTENSION. На сервере PostgreSQL для Debian или Ubuntu установите пакет pgvector, соответствующий фактической основной версии PostgreSQL; например, для PostgreSQL 16:
sudo apt update
sudo apt install postgresql-16-pgvector
Имя пакета и его доступность зависят от настроенных вами apt-репозиториев. Если он недоступен, следуйте инструкциям по установке pgvector или установите совместимый пакет из репозитория PGDG PostgreSQL. Не меняйте основную версию PostgreSQL на общем сервере бездумно. В пакетах PGDG для PostgreSQL 18 pg_trgm и btree_gin входят в состав postgresql-18. В пакетах дистрибутива они находятся в postgresql-contrib для этой основной версии. Встроенная база данных использует оба, плюс vector.
Создайте отдельную роль и базу данных от имени администратора PostgreSQL:
CREATE ROLE hindsight LOGIN PASSWORD 'ЗАМЕНИТЕ_НА_ДОЛГИЙ_ПАРОЛЬ';
CREATE DATABASE hindsight OWNER hindsight;
Подключитесь к новой базе данных и активируйте расширения:
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS vector;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS pg_trgm;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS btree_gin;'
sudo -u postgres psql -d hindsight -c \
  "SELECT extname, extversion FROM pg_extension WHERE extname IN ('vector','pg_trgm','btree_gin');"
Обычно для установки этих расширений требуются повышенные привилегии; роли приложения не обязательно быть суперпользователем. Hindsight по умолчанию использует pgvector и требует версию 0.8.0 или новее для итеративных ANN-сканов; старые серверы отклоняют эту настройку. HINDSIGHT_API_VECTOR_EXTENSION позволяет выбрать pgvectorscale (вариант DiskANN, который Hindsight документирует для очень больших банков) или vchord, обоим из которых требуются дополнительные пакеты для этой точной сборки PostgreSQL. Переключение алгоритмов после того, как воспоминания уже существуют, останавливает запуск и требует миграции, поэтому выберите алгоритм до первого retain. Для личного банка Hermes достаточно установить pgvector и остановиться на нем.
Разрешите доступ только хосту Hindsight через pg_hba.conf, например:
host hindsight hindsight 192.168.1.50/32 scram-sha-256
Настройте listen_addresses PostgreSQL надлежащим образом и используйте TLS или доверенную частную сеть для межхостовых соединений. Резервируйте эту базу данных независимо от Docker-контейнера Hindsight. Если сервер используется совместно с другими приложениями, держите Hindsight в собственной базе данных или установите HINDSIGHT_API_DATABASE_SCHEMA в схему, которой вы владеете; схема по умолчанию — public.
Запуск Hindsight против PostgreSQL
Создайте compose.yaml на ВМ Hindsight. Эта версия намеренно не запускает PostgreSQL локально:
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest-slim
    restart: unless-stopped
    ports:
      - "8888:8888"
      - "9999:9999"
    env_file: .env
    environment:
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://IP_РАБОЧЕЙ_СТАЦИИ:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
      HINDSIGHT_API_DB_POOL_MIN_SIZE: "2"
      HINDSIGHT_API_DB_POOL_MAX_SIZE: "10"
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
Храните URL внешней базы данных в файле с именем .env:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:ВАШ_ПАРОЛЬ@IP_POSTGRES:5432/hindsight
chmod 600 .env
docker compose up -d
docker compose logs -f --tail=100
Если ваш пароль содержит @, :, / или другие зарезервированные URL-символы, URL-кодирование его перед добавлением в строку соединения. Проверьте, что ВМ Hindsight может достичь порта 5432 PostgreSQL и что pg_hba.conf разрешает хосту Hindsight доступ — сервер, привязанный только к 127.0.0.1, отклонит соединение, даже если URL выглядит правильно. Дайте первому запуску время на выполнение миграций базы данных; миграции выполняются при запуске, если вы не установите HINDSIGHT_API_RUN_MIGRATIONS_ON_STARTUP=false. Когда API и база данных запущены, продолжайте с разделами Выбор моделей для Hindsight и Запуск и настройка локальных моделей перед подключением Hermes.
Выбор моделей для Hindsight
Развертывание выводит API и базу данных в сеть. Следующее решение — какие модели выполнять три роли инференса: эмбеддинги для кандидатов на извлечение, реранкер для их переупорядочивания и генеративная LLM для retain, reflect и консолидации. Практичный вариант по умолчанию для CPU-хоста Hindsight, чей GPU уже занят диалогами, — это Qwen/Qwen3-Embedding-0.6B внутри процесса, BAAI/bge-reranker-v2-m3 внутри процесса и общая чат-модель llama.cpp для генеративных задач.
Модели эмбеддингов
Hindsight считывает размерность эмбеддингов при запуске и настраивает банк под нее, поэтому модель, выбранная при первом retain, — это модель, которую банк сохраняет до перестроения. Размерность и поведение инструкций важнее, чем место в лидерборде: более сильный 8B-эмбеддер не стоит миграции, если банк уже имеет размерность 384 или 1024. Строки ниже отсортированы от легких к тяжелым; цифры RAM приблизительны для занятого пространства на CPU (FP16 / типичная локальная загрузка), а не размера файла GGUF.
| Модель | Параметры | Измер. | Контекст | Занято | Платформа | Примечания |
|---|---|---|---|---|---|---|
BAAI/bge-small-en-v1.5 |
33M | 384 | 512 | ~100–130 МБ | CPU | По умолчанию в Hindsight; входит в hindsight:latest. Самый быстрый локальный путь. Распределение скоростей все еще калибрует многие значения recall_min_scores по умолчанию после того, как вы перейдете на него. |
BAAI/bge-base-en-v1.5 |
109M | 768 | 512 | ~400 МБ | CPU | Средний английский BGE; фиксирует банк с размерностью 768. |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
~118M | 384 | 512 | ~200 МБ | CPU | Мультиязычный MiniLM, документированный в Hindsight; 50+ языков при той же ширине банка 384, что и у BGE-small. |
intfloat/multilingual-e5-small |
~118M | 384 | 512 | ~200 МБ | CPU | По умолчанию для провайдера onnx; легкий мультиязычный путь на CPU, если у вас есть экспорт ONNX. |
nomic-ai/nomic-embed-text-v1.5 |
~137M | 768 | 8k | ~500 МБ | CPU | Частый эмбеддер Ollama; более длинный контекст, чем у классического BGE, но все же с приоритетом английского. |
google/embeddinggemma-2 |
270M | 768 | 8k | ~540 МБ | CPU | EmbeddingGemma 2 только для текста (отключите башни vision/audio). 100+ языков + код; MRL обрезает до 512/256/128; префиксы инструкций для поиска и документов. Полная мультимодальная загрузка — 740M. |
BAAI/bge-m3 |
568M | 1024 | 8k | ~1.1 ГБ | CPU или GPU | Мощный мультиязычный dual-encoder; та же ширина, что и у Qwen3-0.6B, поэтому замена с той же размерностью все же требует полного переэмбеддинга. |
Qwen/Qwen3-Embedding-0.6B |
0.6B | 1024 | 32k | ~1.2 ГБ | CPU | По умолчанию в этом руководстве. Чувствителен к инструкциям (инструкция поиска на стороне запроса); комфортно работает на CPU. Локальный провайдер автоматически применяет инструкцию; серверам, совместимым с OpenAI, нужен HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX. |
Qwen/Qwen3-Embedding-4B |
4B | 2560 | 32k | ~8 ГБ FP16 / ~2.5 ГБ квант. | GPU | Уровень качества Qwen3; фиксирует банк с размерностью 2560. Нежизнеспособно, если диалоговый GPU уже насыщен. |
Способ запуска модели — вторая половина выбора. Провайдеры эмбеддингов в Hindsight, от самых простых к наиболее сложным:
| Провайдер | Способ запуска | Лучше всего, когда | Примечания |
|---|---|---|---|
local |
В-процессе SentenceTransformers; без сайдкара | Один хост Hindsight, CPU-эмбеддер | Путь по умолчанию. Установите HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL. Без llama.cpp, Ollama или TEI. |
onnx |
В-процессе ONNX Runtime | Легче Torch на CPU; у вас уже есть экспорт ONNX | Требует hindsight-api-slim[local-onnx] и HINDSIGHT_API_EMBEDDINGS_ONNX_*. |
openai / tei |
Внешний эндпоинт, совместимый с OpenAI, или HF TEI | Эмбеддинги вне процесса API; общий GPU/CPU-хост | То, что настраивает раздел «Запуск и настройка локальных моделей» для Ollama / llama.cpp / TEI. Стоит сайдкара только если вы хотите изоляцию или другой компьютер. |
Qwen3-Embedding-0.6B не требует внешнего сервиса эмбеддингов. На CPU-хосте Hindsight он загружается внутри процесса API с провайдером local — Hugging Face скачивает веса при первом старте, и провайдер сам применяет инструкцию поиска модели:
# Переменные окружения Compose (или эквивалентные ключи .env)
HINDSIGHT_API_EMBEDDINGS_PROVIDER: local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL: Qwen/Qwen3-Embedding-0.6B
Используйте внешний эндпоинт, совместимый с OpenAI, только если вы хотите, чтобы эмбеддер находился на другом компьютере или вне процесса API. Ollama — один из таких хостов:
# Эмбеддинги: Qwen3-Embedding-0.6B на Ollama
HINDSIGHT_API_EMBEDDINGS_PROVIDER: openai
HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL: http://192.168.1.123:11434/v1
HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL: qwen3-embedding:0.6b-q8_0
HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY: dummy
Замените хост, порт и тег на то, что показывает ollama list на вашем машине инференса.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX зависит от провайдера:
| Путь | HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX |
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX |
|---|---|---|
local (Qwen/Qwen3-Embedding-0.6B) |
Оставьте пустым / не задано — в-процесс провайдер применяет инструкцию поиска Qwen сам | Оставьте пустым |
| Внешний Ollama / llama.cpp / совместимый с OpenAI | Официальная инструкция поиска Qwen3 (реальная новая строка перед Query:) |
Оставьте пустым — хранимые воспоминания остаются чистым текстом |
| Сервер уже обертывает входные данные в шаблон Qwen | Оставьте оба пустыми — иначе инструкция применяется дважды | Оставьте пустым |
Для внешнего пути установите:
# Реальная новая строка перед Query:. Bash $'...' — надежный способ передать ее.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=
В файле Compose YAML этой же строке нужен явный \n (или литеральное многострочное значение). Установите префиксы до первого retain: изменение их позже означает, что старые векторы и новые запросы больше не находятся в одном пространстве.
Два свойства решают больше, чем позиция в лидерборде. Чувствительность к инструкциям: эмбеддинги Qwen3 применяют инструкцию поиска на стороне запроса; без соответствующего префикса на сервере, совместимом с OpenAI, хранимая сторона и сторона запроса перестают находиться в одном пространстве. Фиксация размерности: поскольку ширина считывается один раз при запуске, переход с 0.6B на 4B позже — это миграция банка, а не изменение конфигурации — и даже замена с той же размерностью (BGE-M3 ↔ Qwen3-0.6B, или EmbeddingGemma 2 ↔ nomic на 768) меняет векторное пространство, поэтому векторы банка не пересчитываются автоматически. Запланируйте новый банк или ручной переэмбеддинг/реиндексацию; см. Экспорт, импорт и миграция банка памяти. После перехода с BGE-small проверьте recall_min_scores против нового распределения скоростей — пороги, откалиброванные на BGE-small, могут быть слишком жесткими для Qwen3-0.6B и лишать реранкер кандидатов. Для бенчмарков и информации о GGUF/Ollama о семействе Qwen3 см. Модели Qwen3 Embedding и Reranker на Ollama.
Модели реранкинга
Эмбеддинги приносят набор кандидатов; реранкер оценивает каждую пару «запрос/отрывок» и переупорядочивает их перед тем, как Hindsight вставит их в контекст. С провайдером local Hindsight загружает cross-encoder SentenceTransformers (или генеративный реранкер, если поддерживается). С внешним эндпоинтом, совместимым с Cohere, он отправляет полное тело запроса в стиле Cohere на HINDSIGHT_API_RERANKER_COHERE_BASE_URL. Реранкер опционален, но как только эмбеддер зафиксирован, это обычно самый большой рычаг качества recall — и, на CPU, часто большая часть времени работы recall. Строки отсортированы от легких к тяжелым.
| Модель | Параметры | Тип | Контекст | Платформа | Примечания |
|---|---|---|---|---|---|
cross-encoder/ms-marco-MiniLM-L-6-v2 |
23M | Cross-encoder | 128 | CPU | По умолчанию в Hindsight; входит в hindsight:latest. Менее секунды для ~20 кандидатов. Оставьте как именованный фолбэк, если более тяжелая модель BGE слишком медленна. |
cross-encoder/ms-marco-MiniLM-L-12-v2 |
~33M | Cross-encoder | 512 | CPU | То же семейство, выше точность; все еще англоязычный MS MARCO. |
cross-encoder/mmarco-mMiniLMv2-L12-H384-v1 |
~33M | Cross-encoder | 512 | CPU | Мультиязычный реранкер MiniLM, документированный в Hindsight. |
BAAI/bge-reranker-base |
278M | Cross-encoder | 512 | CPU | Умеренное улучшение по сравнению с MiniLM; en/zh. Часто обсуждается; пропускается, если v2-m3 уже укладывается в бюджет задержек. |
BAAI/bge-reranker-v2-m3 |
568M | Cross-encoder | 8k | CPU или GPU | Практичный мультиязычный вариант по умолчанию на CPU. На банке ~500 воспоминаний ~2.6–2.8 с на один recall при пороге 20 кандидатов (~140 мс/кандидат; ~93–99% времени recall). Лимиты кандидатов 20/40/80; снижение порога с 20 → 10 примерно вдвое сокращает стоимость реранкинга. |
Qwen/Qwen3-Reranker-0.6B |
0.6B | Генеративный (yes-token) | 32k | Предпочтителен GPU | Чувствителен к инструкциям, длинный контекст. Не является drop-in cross-encoder: требует поддержки генеративного реранкинга в последних версиях SentenceTransformers, и скрининг /rerank в llama.cpp имеет известные ошибки неверных скорингов (hindsight-benchmarks#11). Проверьте перед внедрением. |
BAAI/bge-reranker-v2-gemma |
2.5B | Cross-encoder | 8k | Предпочтителен GPU | Мощное мультиязычное качество; избыточно для личного банка в несколько сотен воспоминаний, когда GPU уже заполнен. |
Qwen/Qwen3-Reranker-4B |
4B | Генеративный | 32k | GPU | Кандидат Qwen более высокого качества; нежизнеспособен без выделенной VRAM. |
Qwen/Qwen3-Reranker-8B |
8B | Генеративный | 32k | GPU | Верхний уровень семейства; те же оговорки по генеративному скринингу, но еще больше. |
Облачные API-реранкеры (Cohere, ZeroEntropy, Alibaba qwen3-rerank, TypeSafe и подобные) работают в Hindsight, но отправляют текст памяти за пределы устройства. Для полностью локальной конфигурации они вне зоны интереса.
Два операционных ограничения определяют выбор. VRAM: если диалоговая модель уже насыщает GPU (например, Qwen3.8-27B Q5 на карте 16 ГБ без запасов), все строки «Предпочтителен GPU» исключаются, и живой выбор сужается до MiniLM или BGE-v2-m3 на CPU. Количество кандидатов: HINDSIGHT_API_RERANKER_MAX_CANDIDATES (30 в примере внешнего эндпоинта ниже) ограничивает количество отрывков, которые модель пересчитывает; каждый кандидат — это полный прямой проход, поэтому сократите порог перед переходом на более тяжелую модель. Для Qwen3 через llama.cpp GGUF должен сохранять голову ранжирования — старый convert_hf_to_gguf.py, который ее отбрасывает, оценивает каждый отрывок около нуля — и даже правильная конвертация требует теста с известными хорошими/плохими отрывками, пока путь генеративного скрининга не подтвержден.
Уровни генеративных LLM
Модели эмбеддингов и реранкинга не заменяют генеративную LLM, используемую для извлечения и рассуждения о воспоминаниях. Hindsight поддерживает LLM по умолчанию и переопределения для конкретных операций, которые могут указывать на один и тот же сервер llama.cpp или на независимые эндпоинты.
| Операция Hindsight | Назначение | Практический уровень модели | Примеры Qwen |
|---|---|---|---|
| Retain | Извлечение фактов, сущностей, решений и хронологии | Минимум 4B для тестов; предпочтительно 9B | Qwen3.5-4B / Qwen3.5-9B |
| Recall | Семантический, ключевой, графовый и временной поиск | Генеративная LLM не требуется | Qwen3-Embedding-0.6B + реранкер |
| Reflect | Ответ на вопросы путем синтеза извлеченных воспоминаний | 9B до 27B+ | Qwen3.5-9B / Qwen3.8-27B |
| Консолидация | Согласование и сжатие связанных фактов | Предпочтительно 9B | Qwen3.5-9B / Qwen3.8-27B |
| Обновление ментальной модели | Обновление длиннопериодического синтезированного понимания | 9B до 35B | Qwen3.5-9B / Qwen3.6-35B-A3B |
Это операционные рекомендации, а не официальные минимальные параметры Hindsight. Маленькая модель может правильно извлечь номер порта, но упустить, что более раннее архитектурное решение было заменено. Надежность структурированного вывода и верное обращение с отрицаниями важнее, чем просто номинальное количество параметров. Собственные значения температуры по умолчанию в Hindsight стоит оставить как есть — 0.1 для retain, 0.0 для консолидации, 0.9 для reflect — и для retain и консолидации стоит обслуживать alias non-thinking, если ваша сборка llama.cpp его имеет, потому что мелкие чекпоинты Qwen3.5 тратят много токенов в режиме размышлений.
Для развертывания с существующим эндпоинтом Qwen3.8-27B llama.cpp начните с совместного использования его для генеративных задач Hindsight с низкой конкурентностью:
HINDSIGHT_API_LLM_PROVIDER=openai
HINDSIGHT_API_LLM_BASE_URL=http://IP_РАБОЧЕЙ_СТАЦИИ:8080/v1
HINDSIGHT_API_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_LLM_API_KEY=dummy
HINDSIGHT_API_LLM_MAX_CONCURRENT=2
HINDSIGHT_API_RETAIN_LLM_MAX_CONCURRENT=1
HINDSIGHT_API_CONSOLIDATION_LLM_MAX_CONCURRENT=1
Позже направляйте рутинное извлечение на независимую 9B-модель и оставляйте 27B для сложной рефлексии:
HINDSIGHT_API_RETAIN_LLM_PROVIDER=openai
HINDSIGHT_API_RETAIN_LLM_BASE_URL=http://ХОСТ_МЕМ_ЛЛМ:8083/v1
HINDSIGHT_API_RETAIN_LLM_MODEL=MemoryLLM
HINDSIGHT_API_RETAIN_LLM_API_KEY=dummy

HINDSIGHT_API_REFLECT_LLM_PROVIDER=openai
HINDSIGHT_API_REFLECT_LLM_BASE_URL=http://IP_РАБОЧЕЙ_СТАЦИИ:8080/v1
HINDSIGHT_API_REFLECT_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_REFLECT_LLM_API_KEY=dummy
Меньшая 4B-модель экономична, но требует тестов; 9B — разумный компромисс между качеством и производительностью. Если retain и консолидация делят маленькую модель, снизьте HINDSIGHT_API_CONSOLIDATION_LLM_BATCH_SIZE до 2 — пакет по умолчанию в 8 — это длинный промпт для малого контекстного окна. Qwen3.6-35B-A3B привлекательна для отдельного хорошо provision’ированного сервера инференса (это модель mixture-of-experts с примерно 3 миллиардами активных параметров, поэтому рассчитывайте ее как маленькую активную модель), в то время как плотная модель 27B обычно не нужна для каждого рутинного события retain. Ограничение фоновой конкурентности защищает диалоговую модель Hermes от всплесков обслуживания памяти.
Запуск и настройка локальных моделей
Если настроек в-процесс local для эмбеддингов и реранкера, описанных в разделе «Выбор моделей», достаточно, можно пропустить подразделы про внешний Ollama и llama.cpp и перейти к настройке — или оставить Compose на значениях local по умолчанию, показанных там. Внешние эндпоинты важны, когда эмбеддер или реранкер должны находиться на другом хосте.
Внешние эмбеддинги: Ollama или llama.cpp
Внешние эмбеддинги нужны, когда вы хотите, чтобы Qwen3-Embedding-0.6B (или другая модель) находился на отдельном хосте. Два практических варианта — Ollama, который обрабатывает получение моделей и их обслуживание с малой конфигурацией, и llama.cpp, который дает точный контроль над GGUF-квантованием, CPU-потоками, размещением на устройствах и батчингом. Фон по моделям и бенчмарки для обеих моделей Qwen3 находятся в статье Модели Qwen3 Embedding и Reranker на Ollama.
Qwen3-Embedding-0.6B возвращает 1024-мерные векторы, и Hindsight считывает эту ширину при запуске и настраивает базу данных под нее. Банк, созданный со встроенной 384-мерной моделью BGE, не сможет взять эту модель — начинайте с пустой базы данных или тома и решайте модель эмбеддингов до первого retain. Переключение провайдера эмбеддингов позже требует переэмбеддинга хранимых записей, даже если обе модели используют одну размерность.
Вариант 1: Ollama для Qwen3-Embedding-0.6B
Установите Ollama на хосте инференса, используя его официальную документацию по установке для Linux, затем запустите модель эмбеддингов:
ollama pull qwen3-embedding:0.6b
ollama serve
Для удаленного доступа настройте OLLAMA_HOST=0.0.0.0:11434 в переменных окружения службы Ollama, перезапустите службу и ограничьте ее файрволом до ВМ Hindsight — процедура описана в удаленный доступ к Ollama. Демон, привязанный только к 127.0.0.1, невидим для контейнера Hindsight. Сначала проверьте имя модели с помощью ollama list и протестируйте стандартный эндпоинт эмбеддингов:
curl http://ХОСТ_ЕМБЕД:11434/api/embed \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding:0.6b","input":"A test memory"}'
Провайдер эмбеддингов OpenAI в Hindsight вместо этого вызывает OpenAI-совместимый эндпоинт /v1/embeddings Ollama. Убедитесь, что этот эндпоинт работает с вашей версией Ollama, перед конфигурацией Hindsight. Ollama прост для эмбеддингов; не предполагайте, что его API предлагает совместимый эндпоинт реранкинга. Для реранкинга предпочтите путь local BGE внутри процесса, описанный ниже, или отдельный эндпоинт llama.cpp / TEI после того, как вы проверите скоринги.
Вариант 2: llama.cpp для Qwen3-Embedding-0.6B
Скачайте проверенную конвертацию Qwen3-Embedding-0.6B GGUF. Используйте имя файла GGUF, которое вы фактически скачали:
#!/bin/sh
# start-embedding.sh - сервер эмбеддингов только для CPU
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8081 \
  --model "$HOME/ggufs/Qwen3-Embedding-0.6B-Q8_0.gguf" \
  --alias qwen3-embedding-0.6b \
  --embedding --pooling last \
  --ctx-size 4096 --parallel 1 \
  --threads 4 --threads-batch 4 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 0
Эмбеддинги Qwen3 используют пулинг последнего токена, в отличие от CLS-пулинга, используемого некоторыми моделями BGE. Сборка llama.cpp только для CPU предпочтительнее, если вы хотите абсолютно никакой инициализации CUDA на рабочей станции, чей GPU занят большой диалоговой моделью. Не включайте --reranking на этом сервере эмбеддингов: это сочетание — известный способ получить вектор нулей.
curl -s http://ХОСТ_ЕМБЕД:8081/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding-0.6b","input":"A test memory"}' \
  | jq '.data[0].embedding | length'
Полномерный вывод Qwen3-Embedding-0.6B должен содержать 1024 числа с плавающей точкой. Проверьте, что конвертация GGUF и обработка инструкций запроса/документа вашего Hindsight совместимы; модели эмбеддингов, чувствительные к инструкциям, могут терять точность при неправильном промптинге.
Реранкер: локальный BGE или Qwen3 через llama.cpp
Реранкинг отличается от эмбеддингов: модель оценивает каждую пару «запрос/документ» и возвращает оценку релевантности. На CPU-only хосте Hindsight — или всякий раз, когда диалоговый GPU не имеет запасов VRAM, — практичный путь — провайдер local Hindsight с BAAI/bge-reranker-v2-m3 (или более легким MiniLM по умолчанию). Сайдкар не требуется:
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20
Qwen3-Reranker-0.6B — генеративный скрининг yes-token, а не классический cross-encoder. Он может обслуживаться через llama.cpp с GGUF-конвертацией, предназначенной для ранжирования, но рассматривайте этот путь как экспериментальный, пока вы не подтвердите скоринги на известной паре «хорошо/плохо»: старый convert_hf_to_gguf.py, который отбрасывает голову ранжирования, оценивает каждый отрывок около нуля, и нативный путь /rerank в llama.cpp имеет известные отчеты о неверных скорингах для этого семейства.
#!/bin/sh
# start-reranker.sh - GPU или CPU в соответствии с --n-gpu-layers
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8082 \
  --model "$HOME/ggufs/Qwen3-Reranker-0.6B-Q8_0.gguf" \
  --alias qwen3-reranker-0.6b \
  --embedding --reranking --pooling rank \
  --ctx-size 4096 --parallel 1 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 99
Установите --n-gpu-layers 0, чтобы запустить его на CPU. Версии GPU требуют дополнительных VRAM для вычислительных буферов и контекста, а не только весов модели; не предполагайте, что размер файла — это всего лишь общая выделенная память GPU.
curl -s http://ХОСТ_РЕРАНК:8082/v1/rerank \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-reranker-0.6b", "query":"PostgreSQL storage", "documents":["Hindsight stores memories in PostgreSQL.","A recipe for bread."], "top_n":2}' \
  | jq
Документ про PostgreSQL должен ранжироваться выше нерелевантного документа; оценки релевантности, равные нулю, означают, что GGUF — неверная конвертация, и recall будет выглядеть случайным, даже если факты сохранены. Проверьте точную форму results[].index и results[].relevance_score: Hindsight ожидает ответ реранкинга, совместимый с Cohere, а совместимость llama.cpp может варьироваться между сборками.
Настройка эндпоинтов в Hindsight
Добавьте следующие настройки окружения в сервис Compose Hindsight или храните их в его файле .env. Выберите один путь эмбеддингов — в-процесс local, Ollama или llama.cpp — никогда не два одновременно.
# Вариант A: в-процесс Qwen3 на хосте Hindsight (CPU; без сайдкара)
HINDSIGHT_API_EMBEDDINGS_PROVIDER=local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL=Qwen/Qwen3-Embedding-0.6B

# Вариант B: сервис эмбеддингов llama.cpp
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://ХОСТ_ЕМБЕД:8081/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding-0.6b
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BATCH_SIZE=8
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Вариант C: Ollama на другом хосте
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://192.168.1.40:11434/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding:0.6b-q8_0
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Вариант: локальный реранкер BGE (без сайдкара; предпочтителен на CPU)
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20

# Вариант: Cohere-совместимый эндпоинт реранкинга llama.cpp (сначала проверьте скоринги Qwen3)
# HINDSIGHT_API_RERANKER_PROVIDER=cohere
# HINDSIGHT_API_RERANKER_COHERE_BASE_URL=http://ХОСТ_РЕРАНК:8082/v1/rerank
# HINDSIGHT_API_RERANKER_COHERE_MODEL=qwen3-reranker-0.6b
# HINDSIGHT_API_RERANKER_COHERE_API_KEY=dummy
# HINDSIGHT_API_RERANKER_MAX_CANDIDATES=30
Имена переменных специфичны для провайдера, и близкая опечатка остается незамеченной: HINDSIGHT_API_EMBEDDINGS_BASE_URL — это неправильный ключ, и Hindsight тихо нацеливается на собственный эндпоинт эмбеддингов OpenAI, а не на ваш локальный сервер. Используйте HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL. С путем реранкинга, совместимым с Cohere, Hindsight отправляет полное тело запроса в стиле Cohere на HINDSIGHT_API_RERANKER_COHERE_BASE_URL; если в логах контейнера отображается 404 для /v1/rerank/rerank, ваша сборка добавляет /rerank самостоятельно, и значение должно заканчиваться на /v1.
Для вариантов B и C используйте значение HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX из раздела Модели эмбеддингов (в варианте A он остается не заданным). Протестируйте retrieval запроса к отрывку на ваших фактических воспоминаниях после первого retain.
Управление тем, что запоминается
Когда стек запущен, следующим видом отказа обычно является путь записи: по умолчанию в Hermes установлено auto_retain: true, поэтому каждый ход разговора может быть извлечен в банк. Неправильные предположения, отброшенные планы и экспериментальные высказывания становятся searchable фактами, и поздний recall трактует их как доказательства — это цикл, описанный в статье самовоспроизводящиеся циклы памяти. Политика захвата для Hindsight среди других провайдеров обобщена в статье сравнение провайдеров памяти для агентов.
Режимы захвата, существующие сегодня
В Hermes или Hindsight нет переключателя с названием «синтез сессии». Плагин либо автоматически сохраняет сырые ходы разговора (опционально батчами), либо ждет явного вызова инструмента hindsight_retain с тем content, который вы ему дадите.
| Режим | Настройки Hermes / Hindsight | Что вы получаете |
|---|---|---|
| Непрерывный | auto_retain: true, retain_every_n_turns: 1 |
Каждый ход сохраняется и извлекается как текст транскрипта |
| Батчинг по авто | auto_retain: true, увеличение retain_every_n_turns |
Ходы буферизуются в плагине; каждый N-й ход отправляет более крупный payload retain из этих сырых ходов — по-прежнему автоматическое извлечение, а не выверенная сводка |
| Только явный | auto_retain: false + инструмент hindsight_retain |
Ничего не сохраняется, пока агент не вызовет инструмент с content (и опционально context / tags) |
Батчинг по авто — это не сводка сессии. При retain_every_n_turns > 1 плагин Hindsight в Hermes накапливает ходы в памяти и сохраняет их как JSON разговора; при /new, /reset, /branch и подобных переключениях сессий он выгружает оставшийся буфер под документом старой сессии. Специального суммаризатора конца сессии нет, и при N > 1 исторически существовала возможность потерять невыгруженный буфер при пассивном завершении сессии (нет хука on_session_end в плагине). Предпочитайте N: 1, если вы не принимаете этот компромисс.
Вычитка «запомни эту сессию» — это паттерн промпт + инструмент, а не флаг конфигурации. Установите auto_retain: false, затем попросите Hermes обобщить устойчивые решения и вызвать hindsight_retain с этим текстом — или вызовите инструмент сами через путь инструментов агента. Reflect и консолидация банка — это отдельные операции сервера Hindsight, которые синтезируют из того, что уже находится в банке; они не заменяют запись в конце сессии и не включаются ключом в config.json Hermes.
Установка auto_retain в false отключает автоматическое сохранение ходов. Это не добавляет диалог одобрения человеком перед каждой записью. Агент все еще может вызывать hindsight_retain, когда это позволяют его инструменты; относитесь к явном retain как к намеренному захвату, а не к ожидающей очереди.
Проблема отсутствующей очереди одобрений
Общее желание — это очередь кандидатов на память, которые вы проверяете и одобряете перед их попаданием в банк. Hindsight под Hermes не предоставляет такого договора сегодня. Mnemosyne для Hermes реализует поэтапные записи провайдера в некоторых версиях; этот путь не является общим стандартом Hermes и не применяется к плагину Hindsight. Пока не существует upstream потока одобрения, рабочий паттерн — это auto_retain: false, намеренный hindsight_retain и проверка или удаление в UI панели управления Hindsight, прежде чем следующая сессия опирется на плохой факт. Нехватает ключа write_approval для Hindsight, которого нужно искать в config.json.
Управление банком (миссии, метки, директивы, ментальные модели)
Люди часто называют следующий уровень «fine-tuning». В Hindsight это в основном конфигурация банка, а не только config.json Hermes: миссии и настройки извлечения направляют то, что сохраняет retain; метки структурируют сущности; директивы и ментальные модели формируют поздний синтез.
| Управление | Где находится | Как помогает |
|---|---|---|
Миссия retain (retain_mission / bank_retain_mission в Hermes) |
Конфигурация банка | Простой язык «обрати внимание на X, игнорируй Y», внедряемый в извлечение |
Режим извлечения (concise, verbose, custom, …) |
Конфигурация банка | concise (по умолчанию) сохраняет долгосрочно ценные факты; custom заменяет встроенные правила через retain_custom_instructions |
| Метки сущностей | Конфигурация банка | Контролируемый словарь key:value во время retain → графовые связи и опциональные теги; улучшает структуру поиска, но сам по себе не отклоняет неверные утверждения |
| Директивы («жесткие правила») | API директив банка | Явные инструкции, применяемые во время reflect (в рамках тегов); ограничивают синтез, а не являются вратом одобрения записи |
| Ментальные модели | API ментальных моделей банка | Стоящие ответы на повторяющиеся вопросы, обновляемые через reflect из соответствующих воспоминаний; производные, поэтому плохие исходные факты все еще отравляют их |
| Миссия reflect / наблюдений | Конфигурация банка | Направляет синтез и консолидацию, а не сырую лавину retain |
Миссии, краткое извлечение и метки уменьшают шум и улучшают поиск. Они не заменяют отключение auto-retain, когда точность важнее полноты. Предпочитайте короткую миссию retain, которая называет устойчивые решения проекта и игнорирует логистику чата; добавляйте метки сущностей только когда у вас есть настоящая таксономия; добавляйте ментальные модели для двух-трех повторяющихся вопросов после того, как банк уже содержит чистые факты.
Рекомендуемый профиль гигиены
Конкретная отправная точка для личного банка Hermes:
{
  "mode": "local_external",
  "api_url": "http://IP_ВМ_HINDSIGHT:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": false,
  "retain_async": true,
  "recall_prefetch_method": "recall"
}
В банке установите миссию retain и оставьте извлечение в режиме concise (через панель управления или API банков). После явного retain откройте UI, подтвердите наблюдение и удалите ошибки, прежде чем запустится консолидация или обновление ментальных моделей. Оставьте recall_prefetch_method в recall — reflect тратит вызов чат-модели перед каждым ходом и вставляет синтез, а не лежащие в основе факты.
Подключение агента Hermes к Hindsight
На ВМ Hermes установите плагин из каталога, затем запустите мастер настройки. Выберите Hindsight и режим local_external; плагину не нужно запускать встроенный PostgreSQL или обслуживать стек моделей Hindsight локально, а local_embedded запустил бы второй демон Hindsight рядом с контейнером, который вы только что запустили.
hermes plugins install hindsight
hermes memory setup hindsight
Будет интересный набор опций роли агента, использующего hindsight
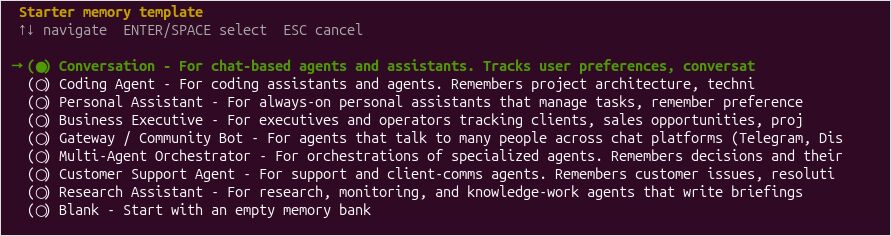
hermes memory status
Внешнее соединение Hindsight находится в ~/.hermes/hindsight/config.json. Иллюстративная конфигурация, сохраняющая непрерывный захват (значения по умолчанию Hermes):
{
  "mode": "local_external",
  "api_url": "http://IP_ВМ_HINDSIGHT:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": true",
  "retain_async": true,
  "retain_every_n_turns": 1
}
Для явного только retain и управления банком используйте профиль гигиены из раздела Управление тем, что запоминается, вместо того чтобы оставлять auto_retain включенным. recall_sync: false приоритизирует интерактивную отзывчивость, но может вставить извлеченный контекст на следующем ходу. Используйте синхронный recall, когда текущий запрос должен включать последние воспоминания до того, как модель начнет отвечать. retain_async: true избегает блокировки обычных ответов, пока воспоминания обрабатываются.
По умолчанию recall в плагине — только наблюдения; сырые факты мира и опыта остаются в банке и вне промпта, пока консолидация не запишет наблюдение, или пока вы не расширите recall_types до observation,world,experience. Расширение этого на первую неделю и наблюдение за панелью управления, затем сужение — разумный порядок.
Встроенная память Hermes остается активной рядом с провайдером; хранение MEMORY.md и USER.md во время изучения того, что добавляет Hindsight, в порядке, и статья о системе памяти — место, где решить, должны ли остаться плоские файлы.
Перезапустите шлюз, если он уже запущен:
hermes gateway restart
hermes memory status
Статус должен идентифицировать Hindsight как активного провайдера. Для более широкой справочной информации о командах, включая TUI и команды плагина Hermes, см. шпаргалку по CLI Hermes Agent.
Проверка памяти, а не только установки
Попросите Hermes запомнить одноразовый факт о тестовом проекте, начните другую сессию и спросите этот факт снова. Сохранение по умолчанию асинхронно, и извлечение ждет чат-модель, поэтому дайте основному серверу llama.cpp немного времени перед оценкой. Затем протестируйте более сложный случай: скажите Hermes, что более раннее решение изменилось, и спросите, какое решение актуально и почему. Проверьте UI Hindsight и хранимые наблюдения, а не предполагайте, что memory status доказывает правильность инджеста и recall.
Если ответ возвращается пустым, проверьте панель управления перед сменой моделей. Retain может завершиться успешно, но все же быть невидимым для recall, пока recall_types ограничен наблюдениями и консолидация не выполнялась — расширение recall_types — первая проверка. Отказ соединения в логах сервера эмбеддингов означает, что контейнер не может достичь порта эмбеддингов, а нулевые скоринги реранкера означают, что GGUF — неверная конвертация.
Выборы пути записи (auto_retain, миссии, проблема одобрения) описаны в разделе Управление тем, что запоминается.
Устранение неполадок и операционные заметки
| Симптом | Вероятная причина | Первая проверка |
|---|---|---|
| Hermes говорит, что провайдер недоступен | Неверный URL local_external или сетевое правило |
curl http://IP_ВМ_HINDSIGHT:8888/health |
| Docker запускается, ошибки PostgreSQL | Отсутствующее расширение, неверные учётные данные или недостаточное общее пространство памяти | Логи контейнера и pg_extension |
| Эмбеддинги возвращают 401 или 404 | Неверный URL, совместимый с OpenAI, неправильное имя ключа окружения или несоответствие alias модели | Прямой тест /v1/embeddings и имена переменных |
| Реранкинг падает | Несоответствие эндпоинта или формата ответа, включая удвоенный путь /rerank |
Прямой тест /v1/rerank и лог контейнера |
| Recall не возвращает ничего полезного | recall_types ограничен наблюдениями или нулевые скоринги реранкера |
Панель управления, затем recall_types, затем конвертация реранкера |
| Существующий банк сообщает о несовпадении размерности | Изменилась модель эмбеддингов | Перестроение векторов/реимпорт с согласованной моделью |
| Ответы Hermes замедляются | Синхронный recall или конкуренция за общую LLM | Отключить синхронный recall; ограничить конкурентность retain |
| Нерелевантные воспоминания повторяются | Слабое извлечение, шумный поиск или недостаточная консолидация | Проверка наблюдений и скорингов релевантности |
| Соединение с PostgreSQL отклоняется | listen_addresses все еще localhost, или клиент использовал порт другого кластера |
ss -lntp на хосте базы данных; перезапустите этот кластер после изменения listen_addresses |
no pg_hba.conf entry для SSL-соединения |
Нет строки host или hostssl для адреса клиента, или в строке нет /32 и она была пропущена |
Добавьте строку, перезагрузите и прочитайте лог PostgreSQL |
pg_restore не может открыть дамп |
Пользователь postgres не может войти в домашнюю директорию, которая хранит файл |
Скопируйте дамп в /tmp и восстанавливайте оттуда |
must be owner of extension btree_gin |
COMMENT ON EXTENSION выполнялось от имени роли приложения |
Пересоздайте пустую базу данных и восстанавливайте с --no-comments |
Установлены пакеты PostgreSQL 18, pg_lsclusters показывает только 14 |
Новая основная версия не создает кластер, если один уже существует | sudo pg_createcluster 18 main |
Практичное небольшое развертывание — 2-4 vCPU и 4-6 ГБ RAM для ВМ API Hindsight при условии, что PostgreSQL и весь инференс находятся снаружи. Выделение диска все еще зависит от выбранного Docker-образа и хранимых слоев образов; выделяйте примерно 30-40 ГБ изначально с запасом для расширения. Размер хоста PostgreSQL основывайте на фактическом объеме памяти, производительности хранения и других базах данных, которые он обслуживает.
Резервное копирование и восстановление банка Hindsight
Банк памяти — это единственное состояние, которое имеет значение, и оно находится в PostgreSQL. В варианте B это база данных, которой вы управляете; в варианте A это именованный том встроенного pg0 внутри контейнера. Копируйте его независимо от контейнера Hindsight — пересоздание контейнера без предварительного захвата тома или базы данных стирает банк, а hermes backup не достигает банка, работающего в отдельной службе.
Вариант B — внешний PostgreSQL. Сделайте дамп базы данных hindsight в кастомном формате, затем восстановите его в тестовую базу данных, чтобы подтвердить архив, прежде чем доверять ему:
pg_dump -h IP_POSTGRES -U hindsight -Fc hindsight > hindsight-bank.dump

# восстановление в тестовую базу данных, чтобы доказать, что дамп пригоден
createdb -h IP_POSTGRES -U postgres hindsight-verify
pg_restore -h IP_POSTGRES -U postgres -d hindsight-verify hindsight-bank.dump
Подтвердите наличие расширения pgvector и примера recall в восстановленной копии перед удалением оригинального цели дампа. Храните дамп на другом хосте, чем ВМ Hindsight, и выполняйте это от имени администратора PostgreSQL (роли, которая может создавать базы данных), а не роли приложения.
Вариант A — единый контейнер. Встроенная база данных — это именованный том, поэтому остановите контейнер и упакуйте том tar через одноразовый образ:
docker stop hindsight
docker run --rm -v hindsight-pg0:/data -v "$PWD":/backup alpine \
  tar czf /backup/hindsight-bank.tgz -C /data .
docker start hindsight
Точка монтирования внутри контейнера tar (/data) произвольна; она просто алиасит именованный том, чтобы tar мог читать его. Для восстановления на тот же том остановите контейнер, очистите том и распакуйте архив обратно в него. Перенос этого банка на управляемый вами сервер — это дамп и восстановление в разделе Перенос встроенной базы данных на выделенный сервер.
Делайте снимки в три момента, а не по календарному расписанию: перед сменой модели эмбеддингов, перед основным обновлением Hindsight или PostgreSQL и перед проходом reflect или консолидации, который переписывает банк. Бэкап, который вы восстановили в тестовый банк, ценнее того, который вы только написали.
Перенос встроенной базы данных на выделенный сервер
Единый банк — это именованный том, примонтированный в /home/hindsight/.pg0. Установка HINDSIGHT_API_DATABASE_URL заставляет этот контейнер открывать базу данных, названную в URL, и выполнять миграции. Том не меняется. Перенесите строки с помощью pg_dump и pg_restore, затем сохраните тот же контейнер и направьте его на новый сервер.
Руководство по установке описывает встроенный pg0 и внешний URL как два способа начать пустой сервер. Бэкап и восстановление hindsight-admin копирует таблицы между базами данных; restore очищает целевую схему и требует, чтобы таблицы существовали сначала. Экспорт, импорт и миграция банка памяти — это смена модели эмбеддингов: этот архив оставляет векторы вне, и назначение пересчитывает их. Перенос, сохраняющий ту же модель эмбеддингов, сохраняет векторы, и pg_dump — файл, который несет их.
Совпадение основной версии внутри контейнера
pg0 слушает на 127.0.0.1:5432 внутри контейнера. Его бинарные файлы находятся под /home/hindsight/.pg0/installation/<version>/bin, а данные кластера — /home/hindsight/.pg0/instances/hindsight/data. Роль, пароль и имя базы данных по умолчанию — hindsight. Прочитайте версию сервера этим клиентом. Если ls /home/hindsight/.pg0/installation показывает другую сборку, используйте эту директорию вместо 18.1.0:
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/psql \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -c 'SHOW server_version;'
Дамп в кастомном формате с этого сервера восстанавливается в ту же основную версию или более новую. Актуальный образ ghcr.io/vectorize-io/hindsight:latest сообщает о PostgreSQL 18.1. Архивный пакет Ubuntu 22.04 — PostgreSQL 14, который не может загрузить архив 18.
Установите 18 из apt-репозитория PostgreSQL рядом с кластером дистрибутива. Когда 14/main уже существует, пакет postgresql-18 не создает кластер:
sudo apt install -y postgresql-common
sudo /usr/share/postgresql-common/pgdg/apt.postgresql.org.sh
sudo apt update
sudo apt install -y postgresql-18 postgresql-18-pgvector
sudo pg_createcluster 18 main
sudo pg_ctlcluster 18 main start
pg_lsclusters
pg_lsclusters должен показывать 18/main на следующем свободном порту, 5433, когда 14 все еще на 5432. SELECT version(); на этом порту должен сообщать о PostgreSQL 18. postgresql-contrib-18 — транзитивное имя пакета: apt выбирает postgresql-18, и этот пакет содержит pg_trgm и btree_gin.
Создайте роль, базу данных и расширения из раздела Подготовка PostgreSQL и pgvector, и передавайте -p 5433 на каждом psql, чтобы команды попадали в кластер 18. Встроенная база данных имеет vector, pg_trgm и btree_gin. Пакет pgvector новее исходного, например 0.8.7 на сервере против 0.8.5 в образе, все еще принимает дамп.
Позвольте контейнеру достичь этого порта
Новый кластер слушает на localhost, пока listen_addresses в /etc/postgresql/18/main/postgresql.conf не включает адрес LAN или *. Эта настройка применяется при запуске кластера 18, поэтому перезапустите его с sudo pg_ctlcluster 18 main restart и проверьте ss -lntp на 0.0.0.0:5433. «Connection refused» с другого хоста означает, что ничего не принимает TCP на этом адресе и порту.
В /etc/postgresql/18/main/pg_hba.conf разрешите хосту Hindsight. Маска — часть строки; без /32 PostgreSQL пропускает строку при запуске.
host hindsight hindsight IP_ХОСТА_HINDSIGHT/32 scram-sha-256
host соответствует SSL-соединениям, которые клиенты открывают по умолчанию. Перезагрузите с sudo pg_ctlcluster 18 main reload. Адрес в следующей ошибке «no pg_hba.conf entry … SSL encryption» — это адрес, который нужно записать в эту строку. Из Docker этот адрес — хост, запускающий контейнер: мост трансформирует исходящее соединение контейнера в адрес LAN хоста.
Дамп, затем восстановление с клиентом 18
Остановите писателей, затем сделайте дамп бинарным pg0. Строки, сохраненные после того, как pg_dump открыл свой снапшот, отсутствуют в архиве.
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/pg_dump \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -Fc --no-owner --no-privileges \
  -f /tmp/hindsight-bank.dump

docker cp hindsight:/tmp/hindsight-bank.dump ./hindsight-bank.dump
На хосте базы данных pg_restore должен быть бинарным 18. Клиент 14 не может прочитать этот архив. Сначала скопируйте файл в /tmp. Системный пользователь postgres не может войти в домашнюю директорию другого пользователя, поэтому pg_restore сообщает «Permission denied» для дампа, который ls -l показывает как читаемый для всех.
sudo -u postgres /usr/lib/postgresql/18/bin/pg_restore \
  -p 5433 -d hindsight \
  --no-owner --role=hindsight --no-comments \
  --single-transaction --exit-on-error \
  /tmp/hindsight-bank.dump
--role=hindsight делает восстановленные таблицы принадлежащими роли приложения. --no-comments пропускает COMMENT ON EXTENSION, который падает с «must be owner of extension btree_gin», когда суперпользователь создал расширение, а роль приложения — нет. --single-transaction отменяет неудачную загрузку, так что следующий запуск начинается с пустой схемы. Частичная загрузка, оставленная более ранней попыткой, требует DROP DATABASE и снова трех утверждений CREATE EXTENSION перед повтором.
Сравните SELECT bank_id FROM banks ORDER BY 1 и SELECT count(*) FROM memory_units с такими же запросами, выполненными внутри контейнера перед переключением.
Переключение контейнера и сохранение тома
Добавьте URL в .env Compose из варианта B, используя порт, который на самом деле привязал кластер 18:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:URL_КОДИРОВАННЫЙ_ПАРОЛЬ@IP_POSTGRES:5433/hindsight
Передайте его в переменные окружения сервиса как HINDSIGHT_API_DATABASE_URL: ${HINDSIGHT_API_DATABASE_URL}. Оставьте HINDSIGHT_API_WORKER_ID без изменений. Оставайтесь на ghcr.io/vectorize-io/hindsight:latest, когда сервис устанавливает HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL или HINDSIGHT_API_RERANKER_LOCAL_MODEL. latest-slim — это образ варианта B для эндпоинтов эмбеддингов и реранкинга, работающих вне контейнера. Оставьте том hindsight-pg0 примонтированным.
docker compose up -d пересоздает контейнер. Лог должен называть IP_POSTGRES в строке «Connecting to database», а curl -f http://localhost:8888/health должен включать "database":"connected". GET /v1/default/banks перечисляет восстановленные банки. Recall фактов, которые вы уже сохранили. Опубликованные API и UI-порты остаются прежними, так что Hermes и конфигурация кодинг-агента сохраняют свои существующие базовые URL.
Запуск снова без HINDSIGHT_API_DATABASE_URL использует том, который не получил записей, пока URL был установлен. Удалите том после того, как этот recall удался. Сузьте pg_hba.conf до строки с одним хостом, когда контейнер соединился, и перезагрузите.
Экспорт, импорт и миграция банка памяти
Перенос встроенного банка на выделенный сервер и сохранение уже хранимых векторов описаны в разделе Перенос встроенной базы данных на выделенный сервер. Приведенные ниже шаги — это смена модели эмбеддингов.
Смена модели эмбеддингов — это не редактирование конфигурации. Векторы в банке были вычислены старой моделью, а другая модель — например, встроенный 384-мерный эмбеддер BGE против 1024-мерного Qwen3-Embedding-0.6B — пишет в другое пространство и обычно другую ширину. Вы не можете перенаправить существующий экземпляр на новый эмбеддер и сохранить старые векторы; размерности должны быть пересчитаны путем переэмбеддинга каждого воспоминания новой моделью эмбеддингов.
Поскольку эмбеддер и его конфигурация задаются на каждый экземпляр Hindsight, чистый путь — поднять новый экземпляр с новой конфигурацией эмбеддингов и мигрировать в него банк, а не перестраивать векторы внутри того, который уже обслуживает recall. API Hindsight может переместить банк, но для одноразового изменения экспорт/импорт — более простой и просматриваемый путь:
# экспорт банка со старого экземпляра
docker exec hindsight \
  hindsight-admin export-bank \
    --bank hermes2 \
    --output /tmp/hermes2.zip

docker cp hindsight:/tmp/hermes2.zip ./hermes2.zip

ls -lh hermes2.zip
unzip -t hermes2.zip

# импорт банка в новый экземпляр
docker cp ./hermes2.zip hindsight-q06:/tmp/hermes2.zip

docker exec hindsight-q06 \
  hindsight-admin import-bank \
    --archive /tmp/hermes2.zip
unzip -t проверяет архив перед отправкой на новый экземпляр. После импорта перенаправьте Hermes на api_url нового экземпляра в ~/.hermes/hindsight/config.json, перезапустите шлюз и запустите проверку памяти из ранее описанного: сохраненный факт должен recall через новый эмбеддер. Оставьте старый банк и его векторы в старом экземпляре, пока новый не заработает, чтобы у вас все еще был работающий фолбэк.
Мониторинг, чистка и поддержание стабильности банка
Когда банк работает, ежедневная задача — следить за тем, что модель извлечения решила сохранить, и поддерживать производное состояние под контролем. Используйте UI панели управления (hindsight-embed -p hermes ui start) для проверки наблюдений, скорингов релевантности и вывода консолидации, а не предполагать, что memory status доказывает правильность инджеста и recall. Дублирующиеся или устаревшие воспоминания обычно являются слабым извлечением или недоработанной консолидацией, поэтому исправляйте уровень извлечения или частоту консолидации перед расширением поиска.
Две ловушки обслуживания стоит протестировать, прежде чем полагаться на банк. Во-первых, удаление наблюдения не гарантирует исчезновение всех производных представлений с ним — факт reflect или графовое ребро, построенные из него, могут пережить удаление, поэтому проверяйте удаление до конца, то же самое беспокойство о происхождении, описанное в статье самовоспроизводящиеся циклы памяти. Во-вторых, поддерживайте HINDSIGHT_API_WORKER_ID стабильным между пересозданиями и фиксируйте конкретный тег образа: задача, которая была в процессе выполнения, когда контейнер умер, останется застрявшей под старым идентификатором воркера, а подвижный тег — плохой выбор для базы данных, которую вы намерены сохранять.
