
Sistema de Memória do Agente Hermes: Como a Memória Persistente de IA Funciona na Prática
A memória é a diferença entre uma ferramenta e um parceiro.
Você já sabe como é. Abre um chat com um agente de IA, explica seu projeto, compartilha suas preferências, faz um pouco de trabalho e fecha a aba. Volte na semana seguinte e é como conversar com um estranho — todo o contexto sumiu, cada preferência foi esquecida, e o projeto precisa ser reexplicado do zero.
Isso não é um bug. É assim que os Grandes Modelos de Linguagem funcionam por design. Eles são sem estado: cada requisição é independente, cada resposta é gerada a partir do prompt que você envia naquele momento, sem memória, sem histórico e sem continuidade além dos tokens na janela de contexto atual.
Para interações de uma única mensagem, isso é aceitável. Faça uma pergunta, obtenha uma resposta, siga em frente. Mas para agentes — sistemas que devem fazer coisas entre sessões, aprender com erros e evoluir com você — a ausência de estado é um limite arquitetural duro. É um dos principais problemas não resolvidos em sistemas de IA auto-hospedados.
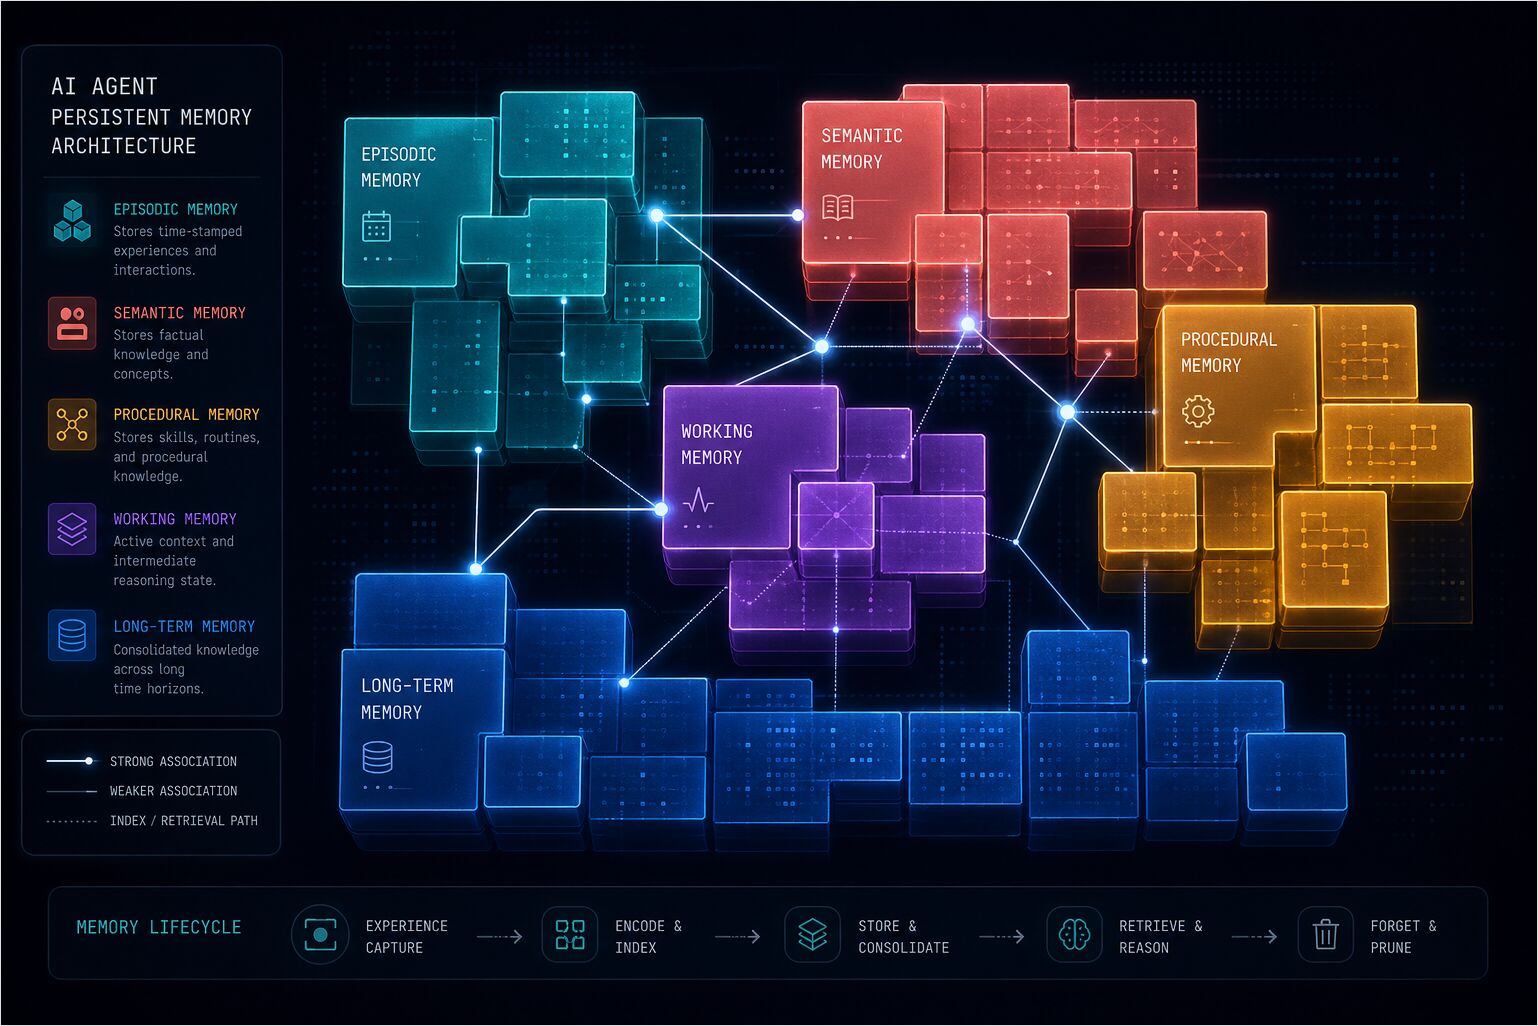
A indústria tentou resolver isso. O LangChain adicionou módulos de memória. A OpenAI introduziu assistentes com threads. Frameworks como Letta, Zep e Cognee construíram arquiteturas inteiras em torno de memória persistente. A Databricks publicou sobre “escala de memória” — a ideia de que o desempenho do agente melhora com a experiência acumulada. Papéis de benchmarks dedicados, revisões de memória episódica e um ecossistema de ferramentas em rápido crescimento surgiram desde 2024 para abordar o que é cada vez mais reconhecido como um dos principais problemas não resolvidos na IA agêntica.
A maioria dessas abordagens compartilha um problema comum: trata a memória como algo secundário — um banco de dados que se consulta, uma janela de contexto que se enche, um sistema de recuperação que adiciona latência e ruído em vez de clareza.
O Hermes Agent adota uma abordagem fundamentalmente diferente. A memória não é algo que o agente recupera quando necessário. É algo que o agente é o tempo todo — integrado ao prompt do sistema, curado, limitado e sempre ativo. É pequeno o suficiente para ser rápido, estruturado o suficiente para ser útil e disciplinado o suficiente para saber o que esquecer.
Este artigo explica exatamente como isso funciona — a camada específica do Hermes dentro do modelo transversal de frameworks em Sistemas de Memória em Assistentes de IA e a pilha mais ampla em Arquitetura de Assistente de IA. Para comandos de ativação e inspeção (hermes memory, hermes dump, acompanhamento de logs), combine com a folha de dicas da CLI do Hermes Agent. Para o lado complementar do Hermes “conhecimento de longo prazo” — procedimentos reutilizáveis em SKILL.md em vez de arquivos de memória curados — veja Criação de Habilidades no Hermes Agent — Estrutura e Boas Práticas de SKILL.md.
Parte 1: O Problema da Memória em Agentes de IA
Por que “Só Adicionar Contexto” Não Escala para Agentes
A solução óbvia para a IA sem estado é adicionar contexto. Anexe a conversa anterior. Inclua a documentação do projeto. Envie todo o histórico.
Por um tempo, isso funciona. Você tem uma janela de contexto de 128K. Você pode caber muito texto nela.
Mas contexto não é memória — existe uma diferença real e importante entre eles. Contexto é tudo o que está sendo mostrado agora; memória é o que você ativamente mantém e leva adiante.
Contexto não tem curadoria. É um despejo: à medida que cresce, o modelo precisa processar milhares de tokens de histórico irrelevante para encontrar o único fato de que precisa. Isso custa tokens e dinheiro, compõe a latência e eventualmente atinge o limite.
Memória é curada. É a destilação da experiência em algo compacto e acionável. Não cresce indefinidamente — consolida, atualiza e esquece.
A memória humana funciona da mesma forma. Você não lembra de todas as conversas que já teve. Lembra das partes que importam: com quem está conversando, o que a pessoa se importa, o que vocês combinaram, o que você aprendeu. O resto é esquecido ou pesquisável quando necessário.
A Paisagem de Pesquisa
O espaço de memória para agentes de IA explodiu desde 2024, com suítes de benchmark dedicadas, uma literatura de pesquisa em crescimento e um lacuna de desempenho mensurável entre diferentes abordagens arquiteturais. Veja como as coisas estão.
Letta (anteriormente MemGPT) foi um dos primeiros frameworks a tratar a memória persistente como uma preocupação de primeira classe, alcançando 21,7 mil estrelas no GitHub. Usa um modelo de três camadas inspirado em sistemas operacionais: memória principal (pequena, sempre no contexto), memória de recall (histórico de conversação pesquisável) e memória arquivada (armazenamento frio de longo prazo). O insight de que nem toda memória é igual estava correto. A implementação, porém, exige que os agentes funcionem inteiramente dentro do runtime Letta — adotá-lo significa adotar toda a plataforma, não apenas uma camada de memória.
Zep / Graphiti foca em memória conversacional com rastreamento temporal de entidades — os fatos carregam janelas de validade para que o grafo saiba quando algo era verdadeiro. É forte para chatbots que precisam de grafos relacionais, menos adequado para agentes autônomos que rastreiam fatos do ambiente e convenções de projeto.
Cognee é construído para extração de conhecimento de documentos e dados estruturados, com mais de 30 conectores de ingestão e um backend de grafo de conhecimento. Excela em conhecimento institucional e pipelines de RAG, mas é menos focado em memória pessoal do agente. Veja auto-hospedagem do Cognee com LLMs locais para um guia de configuração prática.
Hindsight faz recuperação baseada em grafo de conhecimento com relações de entidades e uma ferramenta única de síntese reflect que realiza síntese entre memórias — combinando múltiplas memórias em novos insights. Está entre os principais desempenho em benchmarks de memória de agentes e está disponível como provedor de memória para o Hermes Agent.
Mem0 gerencia a extração de memória no lado do servidor via análise LLM, exigindo configuração mínima. O papel de pesquisa do Mem0, publicado no ECAI 2025 (arXiv:2504.19413), testou dez abordagens distintas para memória de IA e validou a abordagem de extração seletiva — armazenando fatos discretos, desduplicando e recuperando apenas o que é relevante. O Mem0 cresceu para aproximadamente 48 mil estrelas no GitHub e suporta 21 integrações de framework. A compensação é a dependência da nuvem e o custo.
A pesquisa de escala de memória da Databricks introduziu o conceito de que o desempenho do agente melhora com a experiência acumulada. Sua arquitetura mantém prompts do sistema, ativos corporativos e memórias episódicas/semânticas escopadas no nível da organização e do usuário, validando a ideia de que a qualidade da memória importa tanto quanto a capacidade do modelo.
O fio comum entre a maioria dos frameworks é que tratam a memória como um problema de recuperação: guarde em algum lugar, consulte quando necessário, injete no contexto. O Hermes faz o oposto — a memória não é recuperada sob demanda, é injetada no início da sessão e sempre presente. Sempre ativa, sempre disponível, curada o suficiente para permanecer útil.
Parte 2: Arquitetura
Leia esta parte de cima para baixo — camadas e recall/store por turno primeiro, depois o que fica no MEMORY.md e USER.md, e então como conectar um provedor externo.
Duas camadas
O Hermes empilha a memória em duas camadas:
- Integrada —
MEMORY.mdeUSER.md, baseada em arquivos, sempre ativa. Limites rígidos de 2.200 caracteres (notas do agente) e 1.375 caracteres (perfil do usuário). - Um provedor externo (opcional) — Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover, Supermemory e pares que você habilita via configuração. Apenas um backend externo roda por vez. Ele adiciona recuperação e retenção ao lado dos arquivos; não os substitui.
O modelo mental é aditivo — arquivos centrais congelados mais no máximo um plugin. Ganchos de prefetch e sincronização orquestram a camada externa; os dois arquivos permanecem injetados separadamente como parte do prompt do sistema congelado.
Fluxo de tempo de execução (prefetch e sync)
O recall acontece antes do modelo responder; a persistência acontece depois da mensagem do assistente. No gerenciador de memória do Hermes Agent, isso corresponde a prefetch na entrada e sync na saída. Os nomes abaixo correspondem à superfície de implementação (MemoryManager, prefetch / sync_turn / queue_prefetch por provedor).
Mensagem do usuário
    |
    v
MemoryManager.prefetch_all(query)        <-- fase de recall
    |
    +-- provider.prefetch(query)        <-- cada provedor externo busca em seu armazenamento
    |
    v
Contexto injetado no turno do LLM
    |
    v
LLM responde (mensagem do assistente)
    |
    v
MemoryManager.sync_all(user, assistant)  <-- fase de armazenamento
    |
    +-- provider.sync_turn(user, assistant)
    +-- provider.queue_prefetch(user)    <-- busca em segundo plano para o próximo turno
A memória integrada MEMORY.md e USER.md não é buscada através do prefetch_all — elas já fazem parte do prompt do sistema congelado. Backends externos conectam-se ao prefetch_all / sync_all; queue_prefetch permite que um provedor aqueça a recuperação para o turno seguinte sem bloquear a resposta atual.
Três caminhos para a memória de longo prazo
-
Ferramenta integrada
memory. O modelo chamamemorycomadd,replaceouremovequando as instruções indicam que algo deve persistir — fatos duráveis, preferências, correções, notas de ambiente.target='user'mantém o USER.md;target='memory'mantém o MEMORY.md. Formato de exemplo:memory(action='add', target='user', content='…'). -
Retenção passiva em provedores externos. A cada turno, o framework invoca o caminho de sincronização do provedor para que a conversa possa ser dividida, resumida ou extraída sem o modelo nomear cada fato. O comportamento difere pelo backend — por exemplo, o Hindsight agrupa turnos e executa retenção estruturada com entidades e relações; o Honcho envia o diálogo por seu pipeline dialético; pilhas estilo Mem0 e Supermemory extraem fatos passivamente dos turnos.
-
Ferramentas específicas do provedor. Quando o plugin as expõe, gravações explícitas como
honcho_conclude,hindsight_retainouhoncho_profilearmazenam fatias duráveis sob demanda.
Recall automático versus ferramentas do provedor
A memória principal não precisa de uma ferramenta de leitura — ela já está no prompt. Backends externos adicionam injetação automática do prefetch (sem chamada separada de ferramenta de recall para essa fatia de contexto) ou ferramentas explícitas de recuperação (honcho_search, honcho_reasoning, honcho_context, hindsight_recall, hindsight_reflect, e pares) quando o modelo precisa de uma consulta mais afiada do que o prefetch sozinho.
Modos de recall (provedores externos)
Plugins suportam um modo de recall configurável (tipicamente recall_mode ao lado de memory.provider na configuração) que troca tokens por controle.
| Modo | Injeção automática do prefetch | Ferramentas do provedor disponíveis | Ajuste típico |
|---|---|---|---|
| context | Sim | Não | Mão livre, contexto previsível |
| tools | Não | Sim | O modelo escolhe quando recuperar |
| hybrid | Sim | Sim | Contexto mais rico; maior uso de tokens |
Quando nenhum provedor externo é definido (memory.provider vazio ou não definido), apenas os arquivos integrados e a pesquisa de sessão se aplicam — sem prefetch/sync de um plugin.
Caminhos no disco e orçamentos
A memória integrada do Hermes Agent fica em dois arquivos.
~/.hermes/memories/MEMORY.md— Notas pessoais do agente (2.200 caracteres, ~800 tokens)~/.hermes/memories/USER.md— Perfil do usuário (1.375 caracteres, ~500 tokens)
Esta é toda a superfície de memória persistente: dois arquivos, menos de 3.600 caracteres no total, menos de 1.300 tokens. Parece propositalmente pequeno porque é — e essa é exatamente a intenção do design.
MEMORY.md: As Notas do Agente
Este é o lugar onde o agente armazena tudo que aprende sobre seu ambiente, o projeto, ferramentas, convenções e lições aprendidas. Veja como é:
O projeto do usuário é um microsserviço Go em ~/code/gateway usando gRPC + PostgreSQL
Esta máquina roda Ubuntu 22.04, tem Docker e kubectl instalados
O usuário prefere snake_case para nomes de variáveis e evita camelCase
Estes não são logs. São fatos. Densos, declarativos, carregados de informação. Sem carimbos de data, sem recheio, sem “em 5 de janeiro o usuário me pediu para…”.
USER.md: O Perfil do Usuário
Este é o lugar onde o agente armazena tudo que sabe sobre você.
O usuário é um desenvolvedor full-stack confortável com TypeScript, Go e Python.
O usuário prefere snake_case para nomes de variáveis e evita camelCase.
O usuário usa principalmente Linux Ubuntu 22.04.
O usuário faz deploy para AWS usando Terraform.
Identidade, papel, preferências, habilidades técnicas, estilo de comunicação, irritações. As coisas que fazem o agente responder diferentemente para você do que para qualquer outra pessoa.
O Padrão de Snapshot Congelado
No início da sessão, ambos os arquivos são carregados do disco e injetados como um bloco congelado no prompt do sistema. Veja como é:
══════════════════════════════════════════════
MEMORY (suas notas pessoais) [7% — 166/2.200 caracteres]
══════════════════════════════════════════════
O projeto do usuário é um microsserviço Go em ~/code/gateway usando gRPC + PostgreSQL
§
Esta máquina roda Ubuntu 22.04, tem Docker e kubectl instalados
§
O usuário prefere snake_case para nomes de variáveis e evita camelCase
§
══════════════════════════════════════════════
PERFIL DO USUÁRIO (quem é o usuário) [8% — 110/1.375 caracteres]
══════════════════════════════════════════════
O usuário é um desenvolvedor full-stack confortável com TypeScript, Go e Python.
§
O usuário prefere snake_case para nomes de variáveis e evita camelCase.
§
O formato usa cabeçalhos, porcentagens de uso, contagens de caracteres e delimitadores § (sinal de seção). As entradas podem ser multi-linha. É projetado para ser analisável pelo modelo, permanecendo legível para humanos.
Por que congelado? Cache de prefixo. O prompt do sistema é o mesmo em todos os turnos de uma sessão. Mantendo a memória estática após o início da sessão, o modelo pode armazenar em cache o cálculo do prefixo e processar apenas as partes variáveis — a conversa. Esta é uma otimização de desempenho significativa. Você não está recalculando a atenção sobre os mesmos tokens de memória a cada turno.
As alterações feitas durante uma sessão persistem no disco imediatamente, mas só aparecem no prompt do sistema no início da próxima sessão. As respostas das ferramentas sempre mostram o estado ao vivo, mas a “mente” do modelo não muda no meio da sessão. Isso impede que o modelo corra atrás de sua própria cauda — atualizando a memória e depois reagindo à sua própria atualização na mesma conversa.
Limites de Caracteres como Recurso
2.200 caracteres. 1.375 caracteres. Estes não são limites arbitrários. São restrições de design que forçam a curadoria.
Memória ilimitada é um passivo. Incentiva despejar tudo, nunca consolidar e eventualmente se tornar ruído. Memória limitada força o agente a ser seletivo. O que é realmente importante? O que precisarei novamente? O que pode ser comprimido sem perder significado?
Quando a memória está cheia, o agente não falha silenciosamente. Recebe um erro com as entradas atuais e o uso, e então segue um fluxo de trabalho:
- Ler as entradas atuais da resposta de erro
- Identificar entradas removíveis ou consolidáveis
- Usar
replacepara mesclar entradas relacionadas em versões mais curtas - Adicionar a nova entrada
É assim que a memória permanece útil. Não é um banco de dados. É uma coleção curada de fatos que importam.
Segurança: Varredura contra Injeção de Prompt
Cada entrada de memória é varrida antes da aceitação. O sistema bloqueia tentativas de injeção de prompt, exfiltração de credenciais, backdoors de SSH e caracteres Unicode invisíveis.
A memória também é desduplicada. Entradas duplicadas exatas são rejeitadas automaticamente. Isso impede adversários de tentar injetar conteúdo malicioso através de submissões repetidas.
Provedores de memória externos (ativação e links)
Além dos integrados MEMORY.md e USER.md, o Hermes Agent pode conectar um plugin de memória externo por vez — Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover ou Supermemory — para conhecimento persistente entre sessões. Apenas um provedor externo está ativo por vez; os dois arquivos centrais permanecem carregados ao lado dele (aditivo, não substituição).
Ative e inspecione provedores com hermes memory setup, hermes memory status e hermes memory off, ou defina memory.provider e recall_mode em ~/.hermes/config.yaml. Os padrões de credenciais variam (por exemplo HINDSIGHT_API_KEY, chaves do Honcho sob $HERMES_HOME/honcho.json); use hermes memory setup para configuração interativa.
Formato YAML mínimo apenas integrado:
memory:
  provider: ""
  memory_enabled: true
  user_profile_enabled: true
Exemplo de ativação para um backend (substitua hindsight por honcho, mem0, supermemory ou outros que sua instalação suporte):
memory:
  provider: "hindsight"
Para a tabela de comparação completa, notas de dependência de LLM e embedding, análises por provedor e como esses backends se relacionam com o OpenClaw e outras pilhas, veja Provedores de memória para agentes comparados. Para um provedor local, auto-hospedado com controles de escrita inusualmente granulares, veja Mnemosyne para Hermes Agent: Início Rápido de Memória Local — e Laços de Memória Auto-Reforçantes em Agentes de IA para entender por que uma memória limitada e curada como o próprio MEMORY.md do Hermes evita vários modos de falha de laços de feedback por construção.
Para configuração específica de perfil e fluxos de trabalho de produção, veja Configuração de produção do Hermes Agent. O hub de Memória de Sistemas de IA lista este guia além de artigos relacionados do Cognee e da camada de conhecimento.
Parte 3: Quando a Memória Dispara — Gatilhos e Decisões
A pergunta mais comum sobre a memória do Hermes Agent é quando ele realmente salva algo.
A resposta é: constantemente, mas seletivamente. O agente gerencia sua própria memória via ferramenta memory, e a decisão de salvar é dirigida por uma combinação de sinais explícitos e padrões implícitos.
Gatilhos de Escrita: Quando o Agente Decisão Salvar?
O agente salva a memória proativamente. Não espera que você peça. Veja o que o gatilha.
Correções do usuário. Quando você corrige o agente, isso é um sinal para lembrar. “Não faça isso de novo.” “Use isso em vez disso.” “Lembre-se disso.” Estas são instruções explícitas para atualizar a memória.
Exemplo: você pede ao agente para configurar um ambiente Python. Ele sugere pip. Você diz “Eu uso poetry para tudo.” O agente salva: O usuário prefere usar o gerenciador de pacotes 'poetry' para todos os projetos Python.
Preferências descobertas. O agente observa padrões e infere preferências. Se você consistentemente usa uma certa ferramenta, framework ou fluxo de trabalho, isso é salvo.
Exemplo: após ver você usar poetry várias vezes em diferentes projetos, o agente salva como uma preferência.
Fatos do ambiente. Coisas sobre a máquina, o projeto, as ferramentas instaladas. Estas são descobertas através da exploração e salvas como fatos.
Exemplo: o agente verifica o que está instalado e salva: Esta máquina roda Ubuntu 22.04, tem Docker e kubectl instalados.
Convenções do projeto. Como o projeto está estruturado, quais ferramentas usa, quais padrões segue. Estas são descobertas através da inspeção de código e salvas.
Exemplo: O projeto do usuário é um microsserviço Go em ~/code/gateway usando gRPC + PostgreSQL.
Fluxos de trabalho complexos concluídos. Após concluir uma tarefa que exigiu 5+ chamadas de ferramenta, o agente considera salvar a abordagem como uma habilidade ou pelo menos anotar o que funcionou.
Quircks e soluções de ferramentas. Quando o agente descobre algo não óbvio sobre uma ferramenta, API ou sistema — uma limitação, uma solução, uma convenção — ele salva.
O que é pulado:
- Informação trivial ou óbvia
- Coisas facilmente redescobertas
- Despejos de dados brutos
- Efêmeros específicos da sessão
- Informação já em arquivos de contexto (SOUL.md, AGENTS.md)
Gatilhos de Leitura: Quando o Agente Recorda?
A memória não é recuperada — ela está sempre lá. Mas há diferentes níveis de acesso.
Início da sessão (automático). MEMORY.md e USER.md são injetados no prompt do sistema. O agente os tem desde o primeiro token. Nenhuma consulta necessária, sem latência, sem chamada de ferramenta. Esta é a memória principal — sempre ativa.
session_search (sob demanda). Quando o agente precisa encontrar algo de conversas passadas que não está na memória principal, usa a ferramenta session_search. Isso consulta o SQLite (~/.hermes/state.db) com pesquisa full-text FTS5 e sumarização do Gemini Flash. Use isto quando a pergunta soa como “nós conversamos sobre isso antes” em vez de “lembre-se deste fato para sempre.”
Exemplo: você pergunta “Nós discutimos redes Docker na semana passada?” O agente pesquisa o histórico de sessão e retorna um resumo da conversa relevante.
Ferramentas de provedor externo (quando configurado). Quando um provedor externo de memória está ativo, o framework também executa uma etapa automática de prefetch antes de cada resposta (veja a Parte 2). Ferramentas adicionais como honcho_search, hindsight_recall ou mem0_search são para consultas direcionadas quando o agente escolhe a recuperação explícita — dependendo do recall_mode, a injetação automática, as ferramentas ou ambas podem estar ativas.
A Árvore de Decisão
Veja como o agente pondera “isto vale a pena lembrar?”:
Isto é uma correção ou instrução explícita?
  SIM → Salvar na memória
  NÃO → Isto é uma preferência ou padrão?
    SIM → Salvar no perfil do usuário
    NÃO → Isto é um fato do ambiente ou convenção?
      SIM → Salvar na memória
      NÃO → Isto é facilmente redescoberto?
        SIM → Pular
        NÃO → Isto é específico da sessão?
          SIM → Pular
          NÃO → Salvar na memória
O agente não pensa demais nisso. Salva proativamente, consolida quando cheio e confia nos limites de caracteres para manter as coisas concisas.
Parte 4: Memória Interna versus Bancos de Conhecimento Externos
É aqui que a confusão frequentemente acontece. O Hermes Agent tem memória interna (MEMORY.md, USER.md, provedores externos) e bancos de conhecimento externos (LLM Wiki, Obsidian, Notion, ArXiv, sistema de arquivos), e eles servem papéis completamente diferentes. Isso é similar à distinção entre pipelines de geração aumentada por recuperação e memória de trabalho do agente — a recuperação externa é boa para consultas profundas de conhecimento, não para carregar identidade e preferências. A memória interna é o cérebro do agente — sempre ativa, curada, carregada em todas as sessões. Os bancos de conhecimento externos são sua biblioteca — recursos de referência vastos consultados sob demanda.
A Distinção
Memória Interna (o cérebro):
- Pequena, persistente, injetada no prompt do sistema
- Contém: preferências do usuário, convenções do agente, lições imediatas
- Sempre “na mente” durante a conversa
- Curada, limitada, gerida ativamente
- Exemplos: MEMORY.md, USER.md, Honcho, Hindsight, Mem0
Bancos de Conhecimento Externos (a biblioteca):
- Vasto, apenas referência, acessado sob demanda
- Contém: documentos, papéis, código, notas, bancos de dados
- Acessado via ferramentas quando necessário
- Não é “lembrado” — é consultado
- Exemplos: LLM Wiki, Obsidian, Notion, ArXiv, sistema de arquivos, GitHub
Como Se Relacionam
O agente acessa bases externas via ferramentas quando necessário. Não as “lembra” — as consulta.
LLM Wiki (llm-wiki): Base de conhecimento Markdown interligada do Karpathy para construir e consultar conhecimento de domínio. O agente usa a habilidade llm-wiki para ler, buscar e consultar. É um recurso de referência, não memória.
Obsidian: Cofres de notas pessoais com links bidirecionais. O agente usa a habilidade obsidian para ler, buscar e criar notas. O Obsidian faz parte do ecossistema mais amplo de gerenciamento de conhecimento pessoal que o Hermes pode aproveitar como recurso de biblioteca.
Notion/Airtable: Bancos de dados estruturados e wikis acessados via API. O agente os consulta quando necessário.
ArXiv: Repositórios de papéis acadêmicos. O agente busca e extrai papéis ao pesquisar um tópico.
Sistema de Arquivos: Código do projeto, documentação, configurações. O agente lê arquivos ao trabalhar em um projeto.
O Padrão de Destilação
Aqui está o insight chave: insights críticos de bases externas podem ser destilados para a memória interna.
Exemplo: o agente lê um papel do ArXiv sobre escala de memória para agentes de IA. Não salva o papel inteiro na memória. Salva o ponto principal: Escala de memória: o desempenho do agente melhora com a experiência acumulada através da interação do usuário e contexto de negócio armazenados na memória.
O recurso externo é vasto. A memória interna é a destilação.
Quando Usar Cada Um
Memória interna para:
- “Com quem estou ajudando?”
- “O que eles preferem?”
- “O que acabamos de aprender?”
- “Qual é a configuração do projeto?”
- “Quais ferramentas estão disponíveis?”
Bancos de conhecimento externos para:
- “Qual é a pesquisa mais recente sobre X?”
- “O que está na documentação do meu projeto?”
- “O que discutimos no mês passado?”
- “Qual é a API para este serviço?”
- “Qual é a estrutura de código?”
O agente entende a diferença e usa cada um apropriadamente — não confunde a consulta de um documento com o recall de algo que aprendeu sobre você e seu ambiente.
Parte 5: Como Realmente Funciona
Vamos olhar para as mecânicas.
A Ferramenta memory
O agente gerencia a memória através de uma única ferramenta com três ações: add, replace, remove.
Não há ação read — o conteúdo da memória é injetado automaticamente no prompt do sistema. O agente não precisa lê-lo porque está sempre lá.
add — Adiciona uma nova entrada.
memory(action="add", target="memory",
       content="O usuário roda macOS 14 Sonoma, usa Homebrew, tem Docker Desktop instalado.")
replace — Substitui uma entrada existente usando correspondência de substring.
memory(action="replace", target="memory",
       old_text="dark mode",
       content="O usuário prefere modo claro no VS Code, modo escuro no terminal")
remove — Remove uma entrada usando correspondência de substring.
memory(action="remove", target="memory",
       old_text="fato temporário do projeto")
Correspondência de Substring
replace e remove usam substrings únicos curtos via old_text. Você não precisa do texto completo da entrada. Isso permite edições cirúrgicas sem saber o conteúdo exato.
Se um substring corresponder a múltiplas entradas, um erro é retornado solicitando uma correspondência mais específica. O agente então refina sua consulta.
Alvos de Armazenamento: memory vs user
O parâmetro target determina qual arquivo é atualizado.
memory— Notas pessoais do agente. Fatos do ambiente, convenções do projeto, quircks de ferramentas, lições aprendidas.user— Perfil do usuário. Identidade, papel, fuso horário, preferências de comunicação, irritações, hábitos de fluxo de trabalho.
Gerenciamento de Capacidade
Quando a memória está >80% cheia, o agente consolida. Mescla entradas relacionadas, remove fatos desatualizados e comprime informações.
Boas entradas de memória são compactas e densas em informação:
O usuário roda macOS 14 Sonoma, usa Homebrew, tem Docker Desktop instalado. Shell: zsh com oh-my-zsh. Editor: Neovim com plugin Telescope.
Ruins entradas de memória são vagas ou verbosas:
O usuário tem um projeto.
Em 5 de janeiro de 2026, o usuário me pediu para olhar seu projeto que está localizado em ~/code/gateway e usa Go com gRPC e PostgreSQL para a camada de banco de dados.
A primeira é densa e útil. A segunda é ou muito vaga ou muito verbosa.
Pesquisa de Sessão versus Memória Persistente
session_search e memória persistente servem propósitos diferentes.
| Funcionalidade | Memória Persistente | Pesquisa de Sessão |
|---|---|---|
| Capacidade | ~1.300 tokens no total | Ilimitada (todas as sessões) |
| Velocidade | Instantânea (no prompt do sistema) | Requer pesquisa + sumarização LLM |
| Caso de Uso | Fatos-chave sempre disponíveis | Encontrando conversas passadas específicas |
| Gerenciamento | Curadoria manual pelo agente | Automático — todas as sessões armazenadas |
| Custo de Tokens | Fixo por sessão (~1.300 tokens) | Sob demanda (buscado quando necessário) |
Regra geral: use memória para fatos críticos que devem estar sempre no contexto. Use pesquisa de sessão para consultas históricas.
Parte 6: A Filosofia
Por que Memória Limitada Vence Memória Ilimitada
O instinto é tornar a memória o maior possível. Armazenar tudo. Recuperar o que precisa.
Memória limitada funciona melhor. Veja por quê.
Curadoria força qualidade. Quando você tem espaço limitado, só salva o que importa. Comprime, consolida e prioriza. Memória ilimitada incentiva despejar tudo e nunca limpar.
Velocidade importa. 1.300 tokens no prompt do sistema é rápido. 100.000 tokens recuperados de um banco de dados é lento. A memória deve ser instantânea, não uma consulta.
Ruído degrada o desempenho. Mais memória não é memória melhor. É memória mais ruidosa. O modelo precisa distinguir sinal de ruído, e isso exige atenção — atenção que deveria ser gasta na tarefa real.
Esquecer é um recurso. A memória humana esquece. Isso não é um bug — é como priorizamos. Agentes devem esquecer também. Nem tudo merece ser lembrado.
O Problema do “Esquecimento”
Agentes precisam desaprender. Não apenas esquecer, mas ativamente remover informações desatualizadas.
Veja como o Hermes Agent lida com isso:
- Ação
remove: Apagar entradas que não são mais relevantes. - Ação
replace: Atualizar entradas com nova informação. - Pressão de capacidade: Quando a memória está cheia, o agente consolida e remove entradas antigas.
- Varredura de segurança: Bloqueia entradas maliciosas ou corrompidas.
Esquecer não é falha — é manutenção. Um agente que não pode desaprender eventualmente carregará tanto ruído quanto sinal.
Escala de Memória
A Databricks introduziu o conceito de “escala de memória”: um agente com milhares de usuários funciona melhor do que um com um único usuário?
Sua pesquisa sugere que sim, mas com ressalvas. A escala de memória requer:
- Extração de qualidade: Nem todas as interações valem a pena lembrar. O agente deve extrair insights, não logs.
- Recuperação eficaz: As memórias recuperadas devem ser relevantes. Ruído degrada o desempenho.
- Generalização: As memórias devem ser padrões, não especificidades. “O usuário prefere Python” escala. “O usuário executou o comando X no carimbo de tempo Y” não escala.
A memória limitada do Hermes Agent suporta naturalmente a escala de memória. Ao forçar a curadoria, garante que as memórias sejam generalizáveis, compactas e úteis.
O Que Isso Significa para o Futuro
A memória está se tornando o fosso competitivo na IA agêntica — não o modelo em si, mas o que o modelo carrega entre sessões. Dois agentes com modelos subjacentes idênticos podem desempenhar muito diferentemente: um lembra suas preferências, seu ambiente e seus erros passados; o outro começa do zero toda vez.
A pergunta não é mais se os agentes devem ter memória persistente. Está resolvido: devem. A pergunta aberta é como projetar essa memória bem — o que manter, o que descartar, como torná-la instantânea e como impedir que se torne ruído.
A resposta do Hermes Agent é manter a memória pequena, curada e sempre ativa — não um banco de dados que se consulta, mas um modelo funcional do usuário que o agente carrega consigo para todas as conversas.
Conclusão
O sistema de memória do Hermes Agent é propositalmente simples: dois arquivos, limites firmes de caracteres, sem pipeline de recuperação, sem banco de dados vetorial e sem latência por consulta. O que soa como uma restrição é todo o ponto.
Funciona porque trata a memória da forma como um cérebro funciona, e não da forma como um banco de dados funciona — pequeno, curado e sempre ativo. O agente não recupera a memória quando precisa dela; a memória está simplesmente sempre lá, tecida no prompt do sistema desde o primeiro token de cada sessão.
Provedores de memória externos estendem este sistema para usuários que precisam de mais: grafos de conhecimento, suporte multi-agente, armazenamento auto-hospedado, recursos empresariais. Mas o núcleo permanece o mesmo: limitado, curado, sempre disponível.
E bancos de conhecimento externos — LLM Wiki, Obsidian, Notion, ArXiv — servem um papel diferente. São a biblioteca, não o cérebro. O agente os consulta, não os lembra. Insights críticos são destilados para a memória interna; o resto permanece na biblioteca.
É assim que um agente de IA lembra de você. Não armazenando tudo, mas lembrando do que importa.
O Hermes Agent foi lançado pela Nous Research em fevereiro de 2026 e atingiu mais de 64.000 estrelas no GitHub até abril de 2026 (v0.9.0), com mais de 242 colaboradores. É open-source e disponível em github.com/NousResearch/hermes-agent. Para guias de instalação, configuração e fluxo de trabalho, veja a visão geral do Hermes Agent.
