
Kanban no Hermes Agent para Fluxos de Trabalho de LLMs Auto-Hospedados
Controle a carga do Hermes Kanban no seu LLM self-hosted.
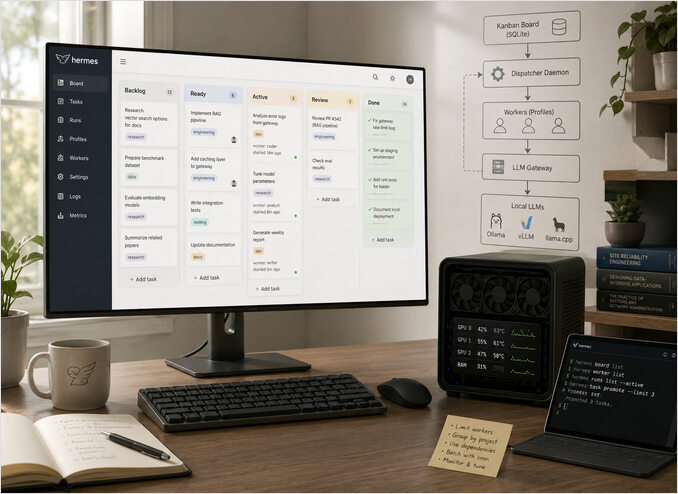
O Hermes Agent é fornecido com um quadro no estilo Kanban e o Hermes Gateway, que podem saturar seu LLM auto-hospedado se muitos tasks forem despachados ao mesmo tempo.
Posso afirmar que você pode facilmente fazer um ddos no seu próprio LLM desta forma.
O Hermes Kanban é um quadro persistente multi-perfil suportado por ~/.hermes/kanban.db.
Cada faixa (lane) representa uma fase de trabalho, e cada cartão (card) é uma tarefa que pode ser assumida por um perfil Hermes específico.
De fábrica, o despachante (dispatcher) pode promover muitos tasks ready em uma única passagem. Isso é aceitável para APIs em nuvem elásticas, mas pode sobrecarregar um pequeno cluster de GPUs auto-hospedado.
Se você é novo neste stack, comece pelo guia de configuração e operações do Hermes e pelo pilar de Sistemas de IA para a arquitetura ao redor.
Este post mostra como:
- Compreender como o despacho do Hermes Kanban interage com seu gateway de LLM.
- Controlar a paralelismo de forma segura para tarefas pesadas.
- Agrupar (batch) promoções com cron para que trabalhos em segundo plano não conflitem com o uso interativo.
- Monitorar e ajustar o sistema para que as GPUs fiquem ocupadas sem sobrecarga.
Como o Hermes Kanban e o despachante funcionam
De alto nível, o sistema tem três camadas:
- Quadro - estado SQLite persistente para tasks, colunas, relações e histórico.
- Trabalhadores - perfis Hermes iniciados em workspaces isolados para processar uma tarefa.
- Despachante - um processo de longa duração que varre cartões despacháveis e inicia execuções.
Tarefas criadas via CLI ou dashboard geralmente começam em backlog ou ready. Os subcomandos hermes kanban usados abaixo são resumidos na folha de dicas da CLI do Hermes Agent.
O despachante varre cartões elegíveis, assume um atomicamente e inicia o perfil atribuído com suas ferramentas e memória.
Cada trabalhador então chama seu gateway de LLM ou runtime local (por exemplo, endpoints compatíveis com OpenAI suportados por Ollama, vLLM ou llama.cpp). Para escolhas de implantação entre esses runtimes, use o Hospedagem de LLM em 2026: Comparativo entre Local, Auto-Hospedado e Nuvem. Se você está ajustando o leque de requisições (request fan-out) no próprio Ollama, isso se combina bem com Como o Ollama Trata Requisições Paralelas.
Se você adicionar muitas tarefas pesadas e não limitar as promoções, seu gateway pode ser inundado com requisições concorrentes. Em um host de GPU única ou limitado por CPU, isso frequentemente significa fila, thrashing e timeouts em vez de melhor throughput.
A limitação prática hoje
Nos builds atuais de Hermes usados por muitas equipes, a configuração do despachante expõe apenas duas chaves de despacho Kanban e não aplica um limite global de tasks ativos a partir da configuração:
kanban:
  dispatch_in_gateway: false
  dispatch_interval_seconds: 10
Para controle de tasks ativos, dependa da cadência explícita de despacho (hermes kanban dispatch --max ...) mais modelagem de dependências.
Problemas conhecidos:
- Não execute despacho embutido no gateway e
hermes kanban daemon --forcecontra o mesmo quadro, ou você pode ter disputas de assunção (claim races). - Se o gateway estiver fora do ar, tasks
readynão são despachados e podem estourar em massa quando o serviço retornar. - Intervalos de despacho mais longos parecem irregulares porque a assunção acontece em ticks.
- O comportamento pode variar entre versões porque casos extremos de estado de execução e reclusão foram corrigidos ao longo do tempo.
Verificação rápida quando o comportamento parece errado:
# 1) confirmar que exatamente um caminho de despachante está ativo
pgrep -af "hermes gateway start|hermes kanban daemon"

# 2) verificar as chaves do despachante Kanban conectadas
rg "dispatch_in_gateway|dispatch_interval_seconds" ~/.hermes/config.yaml

# 3) inspecionar a forma da fila
hermes kanban list --status ready
hermes kanban list --status running
Ideias-chave:
- A configuração do despachante conecta
dispatch_in_gatewayedispatch_interval_seconds. dispatch --maxlimita novos spawns naquela passagem, não o total de tasks em execução.- Para pequenos clusters auto-hospedados, comece conservador e aumente apenas após a latência se manter estável.
Ao implantar o Hermes pela primeira vez próximo ao seu gateway de LLM:
- Mantenha apenas as chaves do despachante Kanban suportadas na configuração.
- Observe a utilização de GPU e CPU sob pressão real de fila.
- Use a Estratégia 1 ou Estratégia 2 para ritmo determinístico.
Achados da investigação e causa raiz
hermes kanban dispatch não lê config.yaml para max_active_tasks.
Em hermes_cli/kanban.py, o comando de despacho expõe --max como um limite de CLI (padrão None) e passa apenas args.max para kb.dispatch_once(...). Não há consulta de configuração max_active_tasks neste caminho. Veja código bruto de hermes_cli/kanban.py.
Então em kanban_db.dispatch_once, o único limite é max_spawn, com lógica equivalente a:
if max_spawn is not None and spawned >= max_spawn:
    break
Não há verificação de tasks já em execução e nenhuma referência a max_active_tasks naquele caminho de despacho. Veja código bruto de hermes_cli/kanban_db.py.
Comportamento efetivo:
hermes kanban dispatch
sem limite para aquela passagem (limitado pelo tamanho da fila ready).
hermes kanban dispatch --max 2
limita apenas novos spawns naquela passagem, não o total de tasks em execução.
Os controles de configuração conectados ao redor do despacho no gateway são kanban.dispatch_in_gateway e kanban.dispatch_interval_seconds.
Portanto, max_active_tasks é ignorado neste caminho de despacho porque não está implementado ali.
Estratégia 1 - Codificar dependências para fluxos estritamente sequenciais
Alguns fluxos de trabalho devem rodar estritamente um após o outro — por exemplo:
- pipelines de dados multi-etapa com artefatos intermediários compartilhados
- migrações ou mudanças de infraestrutura
- trabalhos em lote que escrevem no mesmo object store ou banco de dados
O Hermes Kanban suporta dependências de pai-filho entre tasks, de modo que um cartão filho se torne despachável apenas quando seu pai estiver concluído.
Você pode modelar isso com um pequeno script auxiliar ao redor da CLI Hermes:
#!/usr/bin/env bash

set -euo pipefail

parent_id="$(hermes kanban add \
  --title 'Ingestar logs de clientes de abril' \
  --profile 'etl-worker' \
  --column backlog)"

hermes kanban add \
  --title 'Gerar relatório de anomalias de abril' \
  --profile 'analytics-worker' \
  --column backlog \
  --parent "${parent_id}"

hermes kanban add \
  --title 'Publicar resumo de abril no dashboard' \
  --profile 'reporting-worker' \
  --column backlog \
  --parent "${parent_id}"
Com uma política de quadro adequada e limites baixos do despachante, apenas a tarefa pai roda primeiro. Assim que ela termina, as tarefas filhas gradualmente se tornam prontas, e o despachante as puxa uma a uma sem nunca exceder seus limites de concorrencia.
Estratégia 2 - Usar cron Linux com limite de despacho ciente dos tasks em execução
Se você quiser um ritmo determinístico, use cron do host mais um pequeno script wrapper.
Em vez de sempre chamar dispatch --max 2, primeiro conte os tasks atualmente em execução, então despache apenas os slots restantes.
Crie hermes-kanban-dispatch-capped.sh:
#!/usr/bin/env bash
set -euo pipefail

MAX_PARALLEL="${MAX_PARALLEL:-2}"
BOARD="${BOARD:-}"

board_args=()
if [[ -n "$BOARD" ]]; then
  board_args=(--board "$BOARD")
fi

# ou onde seu hermes está instalado
export PATH="/home/abc/.local/bin:$PATH"

running_out="$(hermes kanban "${board_args[@]}" list --status running)"

if [[ "$running_out" == *"(no matching tasks)"* ]]; then
  running_count=0
else
  running_count="$(printf '%s\n' "$running_out" | wc -l)"
fi

slots=$(( MAX_PARALLEL - running_count ))

if (( slots <= 0 )); then
  echo "Já no limite running=$running_count max=$MAX_PARALLEL despacho pulado"
  exit 0
fi

echo "running=$running_count max=$MAX_PARALLEL slots=$slots despachando até $slots"

hermes kanban "${board_args[@]}" dispatch --max "$slots"
Torne-o executável:
chmod +x ./hermes-kanban-dispatch-capped.sh
Execute com:
MAX_PARALLEL=2 ./hermes-kanban-dispatch-capped.sh
Para um quadro específico:
BOARD=my-board MAX_PARALLEL=2 ./hermes-kanban-dispatch-capped.sh
Agende uma vez por minuto com cron:
* * * * * /opt/hermes/scripts/hermes-kanban-dispatch-capped.sh >> /var/log/hermes/kanban-cron.log 2>&1
Notas operacionais:
- Cron geralmente tem um
PATHmínimo, então sehermesnão for encontrado, use seu caminho completo dentro do script (por exemplo/usr/local/bin/hermes). - Se você fizer log para
/var/log/hermes/..., crie esse diretório primeiro e garanta que o usuário cron tenha acesso de escrita.
Exemplo:
sudo mkdir -p /var/log/hermes
sudo chown "$USER":"$USER" /var/log/hermes
Crie ou edite entradas de cron com:
crontab -e
Então verifique com:
crontab -l
Cadência sub-minuto com uma entrada de cron
Cron dispara uma vez por minuto, mas você ainda pode despachar com mais frequência executando um loop curto dentro do script.
Exemplo hermes-kanban-dispatch-subminute.sh:
#!/usr/bin/env bash
set -euo pipefail

LOCK_FILE="/tmp/hermes-kanban-dispatch.lock"
RUNS_PER_MINUTE="${RUNS_PER_MINUTE:-4}"    # 4 execuções => a cada 15 segundos
CAP_SCRIPT="${CAP_SCRIPT:-/opt/hermes/scripts/hermes-kanban-dispatch-capped.sh}"

exec 9>"$LOCK_FILE"
flock -n 9 || exit 0

sleep_seconds=$(( 60 / RUNS_PER_MINUTE ))

for ((i=1; i<=RUNS_PER_MINUTE; i++)); do
  "$CAP_SCRIPT"

  if (( i < RUNS_PER_MINUTE )); then
    sleep "$sleep_seconds"
  fi
done
Torne-o executável:
chmod +x ./hermes-kanban-dispatch-subminute.sh
Agende uma vez por minuto:
* * * * * /opt/hermes/scripts/hermes-kanban-dispatch-subminute.sh >> /var/log/hermes/kanban-subminute.log 2>&1
Isso dá uma cadência efetiva sub-minuto enquanto flock impede execuções sobrepostas.
Por que isso funciona:
list --status runningdá a carga atual de execução.dispatch --max Nlimita apenas novos spawns para aquela passagem.- Calcular
Ncomo os slots restantes mantém o total de tasks em execução perto do seu limite alvo.
Observação importante: esse limite funciona apenas para despachos feitos através deste script. Desative o despacho embutido no gateway, caso contrário ele ainda pode promover tasks independentemente:
kanban:
  dispatch_in_gateway: false
A documentação oficial descreve ambos os recursos de comando e nota os padrões de despacho no gateway no guia de recursos Kanban: documentação do Hermes Kanban.
Cron Interno do Hermes
Não o use.
Você realmente quer que seu llm processe prompts regulares como Execute in terminal the command /path/hermes-kanban-dispatch-capped.sh, especialmente quando ele está ocupado fazendo algum trabalho útil?
Monitoramento e Ajuste do Hermes Kanban
Qualquer estratégia que você escolha, deve monitorar:
- Métricas do gateway de LLM — taxa de requisições, latência, taxa de erro, throughput de tokens.
- Saúde do nó — utilização de GPU, uso de VRAM, carga de CPU e RAM.
- Métricas do Hermes — quantos tasks estão em backlog, ready, ativo e concluído.
Para baselines de métricas de produção e dashboards, veja Monitorar Inferência de LLM em Produção com Prometheus e Grafana e o mais amplo hub de Desempenho de LLM.
Comece com baixa concorrencia, então aumente gradualmente os limites enquanto observa:
- latência crescente com throughput constante
- aumento de erros de timeout ou limite de taxa
- caudas longas onde alguns tasks permanecem ativos por um tempo muito longo
Assim que você vir esses sintomas, reverta para a configuração anterior estável e mantenha-a como padrão.
Quando o Kanban é a ferramenta certa
O Hermes Kanban brilha quando você tem:
- backlogs de pesquisa ou engenharia de longa duração
- colaboração multi-agente com perfis nomeados
- fluxos de trabalho que devem sobreviver a reinícios e reboot do host
- humanos que querem um dashboard para triagem de trabalho
Se você precisa apenas de uma única execução para criar alguns auxiliares temporários, as ferramentas integradas de delegação de tarefas são geralmente mais simples. Assim que você precisar de histórico, dashboards e controle estrito sobre como seus agentes atingem LLMs auto-hospedados, o quadro Kanban mais despachante é a fundação certa.
Com algumas mudanças de configuração e agrupamento opcional baseado em cron, você pode manter o Hermes Kanban responsivo enquanto protege seu gateway e hardware.
Para uma visão mais ampla de como trabalhadores em segundo plano estilo Hermes se encaixam em arquiteturas de assistentes de IA de produção — incluindo agendadores, polling baseado em fila, protocolos de assunção, fluxos de trabalho duráveis e avaliação semântica — veja Agentes de Polling em Assistentes de IA: 11 Padrões de Implementação. Quando múltiplos perfis nomeados ou agentes especialistas precisam coordenar além do simples despacho de tarefas, Padrões de Orquestração Multi-Agente cobre as topologias de coordenação — hub-and-spoke, fan-out, enxame — que sustentam configurações maiores de multi-agente em infraestrutura auto-hospedada.
