
Otimização de Custos para Sistemas de LLM: Onde o Dinheiro Realmente Gasta
Gaste tokens onde eles realmente importam.
Os custos de LLMs aumentam linearmente com o uso. Um sistema que processa 10.000 requisições por dia a $0,01 por requisição custa $100 por dia — $365 por ano. Em escala empresarial, isso ultrapassa $10.000.
A otimização de custos não se trata de cortar custos às custas da qualidade. Trata-se de gastar tokens onde eles importam.
Cada token que você desperdiça é um token que poderia ter sido gasto em uma melhor resposta.
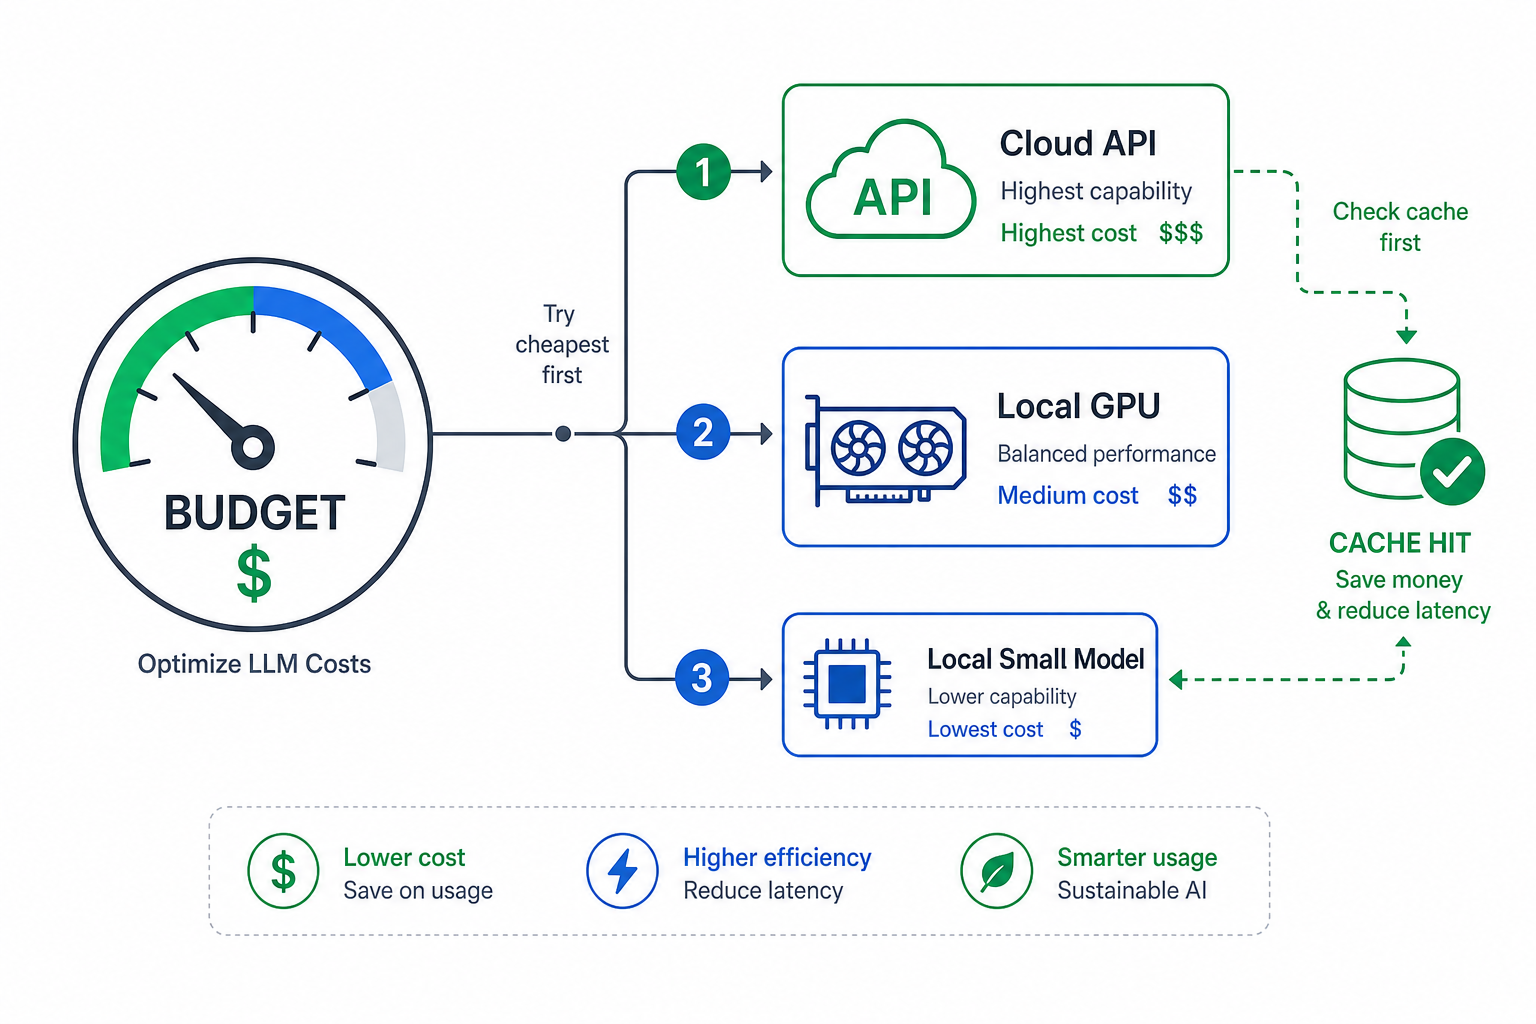
Orçamento de tokens
A maneira mais simples de controlar custos é estabelecer limites. Por sessão, por tarefa ou por dia.
Estratégia 1: Orçamentos por Sessão
Orçamentos por sessão são diretos:
class SessionBudget:
    def __init__(self, budget_tokens: int = 10000):
        self.budget = budget_tokens
        self.used = 0

    def allocate(self, tokens: int) -> bool:
        if self.used + tokens <= self.budget:
            self.used += tokens
            return True
        return False

    def remaining(self) -> int:
        return self.budget - self.used
Estratégia 2: Orçamentos por Tarefa
Orçamentos por tarefa são mais úteis. Diferentes tarefas necessitam de diferentes quantidades de contexto:
task_budgets:
  classify:
    max_tokens: 100
    model: qwen3-1.7b
  summarize:
    max_tokens: 500
    model: qwen3-8b
  code_review:
    max_tokens: 2000
    model: qwen2.5-coder-7b
  reason:
    max_tokens: 4000
    model: qwen3-32b
Estratégia 3: Orçamentos Adaptativos
Orçamentos adaptativos ajustam-se com base no que realmente acontece. Se as tarefas de classificação consistentemente usam 80 tokens, pare de alocar 100:
class AdaptiveBudget:
    def __init__(self):
        self.task_history = {}

    def allocate(self, task_type: str) -> int:
        if task_type in self.task_history:
            return int(self.task_history[task_type] * 1.5)
        return 1000

    def record(self, task_type: str, tokens_used: int):
        if task_type not in self.task_history:
            self.task_history[task_type] = tokens_used
        else:
            self.task_history[task_type] = (
                0.9 * self.task_history[task_type] + 0.1 * tokens_used
            )
A média móvel exponencial (peso 0,9) significa que o uso recente importa mais do que o histórico. Ajuste o peso com base na volatilidade das suas cargas de trabalho.
API vs inferência local
A inferência local é mais barata em escala. O ponto de equilíbrio depende do seu hardware e das taxas da API.
| Modelo | API ($/M tokens) | Custo local/hora | Ponto de equilíbrio |
|---|---|---|---|
| GPT-4o | $2,50 / $10,00 | — | N/A |
| Claude Sonnet 4 | $3,00 / $15,00 | — | N/A |
| Qwen2.5-72B | $0,50 / $2,00 | ~$0,50 | ~4 horas/dia |
| qwen3-32b | $0,30 / $1,20 | ~$0,20 | ~2 horas/dia |
| qwen3-8b | $0,10 / $0,40 | ~$0,05 | ~1 hora/dia |
A matemática do hardware:
| Hardware | Investimento inicial | Eletricidade mensal | Ponto de equilíbrio vs API |
|---|---|---|---|
| RTX 3090 (usada) | $600 | $15 | ~4 meses |
| RTX 4090 | $1.500 | $20 | ~6 meses |
| RTX 5080 | $1.000 | $18 | ~5 meses |
| DGX Spark | $2.000 | $30 | ~8 meses |
Com uso moderado — uma hora ou mais por dia — a inferência local se paga. Com alto uso, as economias são dramáticas. O ponto de atenção é o capital inicial. Uma RTX 5080 custa $1.000. Uma fatura de API pode ser pausada. Hardware, não.
Essa matemática de ponto de equilíbrio assume que você está livre para mudar, o que muitas vezes é a grande incógnita maior do que o custo do hardware. Se seus dados de fine-tuning, seus harnesses de avaliação e seus esquemas de ferramentas já foram construídos em torno da API de um fornecedor, o custo real da migração é o tempo de engenharia para desfazer isso — não o preço de uma GPU. Gravidade de Dados: O Custo Real da IA Centrada em API aborda esse mecanismo de bloqueio do fornecedor e uma lista de verificação para pontuar o quão fundo você já está envolvido nisso, antes de fazer esses cálculos.
Estratégias de fallback
Quando seu modelo preferido é caro demais ou lento demais, recorra a algo mais barato. A chave é saber quando a qualidade é “boa o suficiente”.
Estratégia 1: Fallback Baseado em Qualidade
O fallback baseado em qualidade tenta modelos até que a saída atinja um limite:
class QualityFallback:
    def __init__(self, quality_threshold: float = 0.8):
        self.threshold = quality_threshold
        self.models = [
            {"model": "claude-sonnet-4", "cost": 0.015},
            {"model": "qwen2.5-72b", "cost": 0.002},
            {"model": "qwen3-32b", "cost": 0.001},
            {"model": "qwen3-8b", "cost": 0.0004},
        ]

    def route(self, prompt: str) -> str:
        for model_config in self.models:
            result = self.call_model(model_config["model"], prompt)
            if self.evaluate_quality(result) >= self.threshold:
                return result
        return self.call_model(self.models[0]["model"], prompt)
O problema é a própria avaliação. Como você mede a qualidade sem chamar outro modelo? Alguns sistemas usam um pequeno classificador. Outros usam verificações heurísticas — comprimento, estrutura, presença de palavras-chave. Nenhuma dessas é perfeita.
Estratégia 2: Fallback Baseado em Latência
O fallback baseado em latência é mais simples. Encaminhe para o modelo mais rápido que atinja seu orçamento de tempo:
class LatencyFallback:
    def __init__(self, max_latency: float = 5.0):
        self.max_latency = max_latency
        self.models = [
            {"model": "qwen3-1.7b", "latency": 0.5},
            {"model": "qwen3-8b", "latency": 2.0},
            {"model": "qwen3-32b", "latency": 10.0},
            {"model": "claude-sonnet-4", "latency": 5.0},
        ]

    def route(self, prompt: str) -> str:
        for model_config in sorted(self.models, key=lambda x: x["latency"]):
            if model_config["latency"] <= self.max_latency:
                return self.call_model(model_config["model"], prompt)
        return self.call_model(self.models[0]["model"], prompt)
Cache
O cache é a otimização de custos mais subestimada. Prompts idênticos acontecem mais frequentemente do que você pensa — requisições de classificação, consultas estilo FAQ, chamadas repetidas de ferramentas.
Estratégia 1: Cache de Prompts
O cache de prompts exatos é simples:
import hashlib

class PromptCache:
    def __init__(self, max_size: int = 1000):
        self.cache = {}
        self.max_size = max_size

    def get(self, prompt: str) -> str | None:
        key = hashlib.sha256(prompt.encode()).hexdigest()
        return self.cache.get(key)

    def set(self, prompt: str, response: str):
        key = hashlib.sha256(prompt.encode()).hexdigest()
        if len(self.cache) >= self.max_size:
            self.cache.pop(next(iter(self.cache)))
        self.cache[key] = response
Estratégia 2: Cache Semântico
O cache semântico é mais útil. Ele captura prompts que são diferentes, mas significam a mesma coisa:
from sentence_transformers import SentenceTransformer

class SemanticCache:
    def __init__(self, similarity_threshold: float = 0.95):
        self.model = SentenceTransformer('all-MiniLM-L6-v2')
        self.cache = {}
        self.threshold = similarity_threshold

    def get(self, prompt: str) -> str | None:
        prompt_embedding = self.model.encode([prompt])[0]
        for cached_prompt, cached_response in self.cache.items():
            cached_embedding = self.model.encode([cached_prompt])[0]
            similarity = self.cosine_similarity(
                prompt_embedding, cached_embedding
            )
            if similarity >= self.threshold:
                return cached_response
        return None

    def set(self, prompt: str, response: str):
        self.cache[prompt] = response
O limite importa. 0,95 é agressivo — apenas prompts muito similares correspondem. 0,85 é mais tolerante, mas arrisca retornar respostas erradas. Meça sua taxa de falha e ajuste.
O cache de respostas para consultas comuns também vale a pena. Se os usuários perguntam repetidamente “qual é o clima” ou “que horas são”, cache o padrão, não apenas o prompt exato:
class ResponseCache:
    def __init__(self):
        self.common_queries = {
            "what is the weather": "Check weather API",
            "what is the time": "Check system time",
            "who is the president": "Check current president",
        }

    def get(self, query: str) -> str | None:
        query_lower = query.lower()
        for common_query, response in self.common_queries.items():
            if common_query in query_lower:
                return response
        return None
Isso não é sofisticado, mas funciona. Consultas comuns são comuns por uma razão.
Quando a otimização ajuda
A otimização importa quando você está processando altos volumes, executando cargas de trabalho mistas ou pagando custos de API que se acumulam.
Ela não importa quando você está prototipando, usando um único modelo ou processando baixos volumes. A complexidade do orçamento, fallback e cache não vale a pena para um sistema que faz 100 requisições por dia.
Faça o fluxo básico funcionar primeiro. Adicione otimização quando a fatura chegar.
Compromissos
| Estratégia | Custo | Qualidade | Complexidade |
|---|---|---|---|
| Sem otimização | Mais alto | Consistente | Mais baixa |
| Orçamento de tokens | Moderado | Variável | Média |
| Modelos de fallback | Baixo-Médio | Variável | Média |
| Cache | Mais baixo | Alta (para acertos no cache) | Média |
| Híbrido | Otimizado | Otimizado | Mais alta |
Sistemas de produção geralmente executam híbrido. Orçamento por sessão, fallback por qualidade ou latência, cache do que for possível. A complexidade é real, mas as economias também.
Relacionados
- Gravidade de Dados: O Custo Real da IA Centrada em API — por que a matemática de ponto de equilíbrio acima é apenas metade da decisão de auto-hospedagem
- A Fronteira Eficiente de Modelos Abertos em 2026 — economia de tamanho de modelo por trás do ponto de equilíbrio: um modelo de 27B em um 4090 alugado versus preços de tokens Sonnet atuais
- Estratégias de Roteamento de Modelos — roteamento baseado em capacidade, ciente de custo e ciente de latência
- Guardrails de LLMs na Prática — validação de entrada, filtragem de saída, segurança
- Design de Sistemas Multi-Modelo — arquitetura para múltiplos modelos
- Arquitetura de LLMs — pilar de design de sistema: roteamento, custo, guardrails e orquestração
