Ai

llama.cpp: avvio rapido con CLI e Server

llama.cpp: avvio rapido con CLI e Server

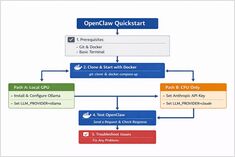
Come installare, configurare e utilizzare OpenCode

Continuo a tornare a llama.cpp per l’inferenza locale: offre un livello di controllo che Ollama e altri strumenti astraggono, e funziona semplicemente. È facile eseguire modelli GGUF in modo interattivo con llama-cli o esporre un’API HTTP compatibile con OpenAI con llama-server.

Airtable per sviluppatori e DevOps - Piani, API, Webhook e esempi in Go/Python

Airtable per sviluppatori e DevOps - Piani, API, Webhook e esempi in Go/Python

Airtable - Limiti del piano gratuito, API, webhooks, Go & Python.

Airtable è meglio considerata come una piattaforma low-code costruita intorno a un’interfaccia collaborativa “simile a un foglio di calcolo” - ideale per creare rapidamente strumenti operativi (tracciatori interni, CRM leggeri, pipeline di contenuti, code di valutazione AI) dove gli sviluppatori non devono un’interfaccia amichevole, ma gli sviluppatori necessitano anche di un’API per l’automazione e l’integrazione.

Osservabilità per sistemi LLM: metriche, tracce, log e testing in produzione

Osservabilità per sistemi LLM: metriche, tracce, log e testing in produzione

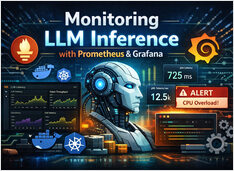
Strategia di osservabilità end-to-end per l'inferenza dei modelli linguistici di grandi dimensioni (LLM) e le applicazioni basate su LLM

I sistemi LLM falliscono in modi che il monitoraggio tradizionale delle API non riesce a rilevare: le code si riempiono in silenzio, la memoria GPU si satura molto prima che la CPU appaia occupata e la latenza esplode a livello di batching anziché a livello dell’applicazione.