Ollama e llama.cpp vengono spesso confrontati come se fossero motori di inferenza rivali. La scelta reale è tra un servizio di modelli gestito e un toolkit che si opera direttamente.
ROCm e Vulkan accelerano entrambe le GPU AMD per l’hosting locale di LLM, ma non sono intercambiabili. La scelta giusta dipende dal motore, dalla GPU e dal carico di lavoro.
Un modello può pubblicizzare una finestra di contesto da 128K eppure fallire a 40K token su una GPU da 16 GB. Il limite architetturale non ha mai promesso che pesi, KV cache, buffer di calcolo e il compositor desktop potessero coesistere sulla stessa scheda.
Perché il tuo stack di AI diventa più ‘appiccicoso’ ogni mese.
Ogni chiamata API sembra una semplice transazione: finché non se ne accumulano abbastanza da plasmare i tuoi dati di fine-tuning, i tuoi sistemi di valutazione e i tuoi schemi degli strumenti attorno a un unico fornitore, momento in cui il passaggio a un altro smette di essere un semplice cambio di instradamento.
Ollama è uno dei modi più semplici per eseguire un modello linguistico locale, ma la praticità può nascondere il momento in cui un esperimento locale diventa un servizio di inferenza condiviso che richiede una migliore pianificazione e osservabilità.
Vane è una delle voci più pragmatiche nel settore della “ricerca AI con citazioni”: un motore di risposta ospitato autonomamente che combina il recupero live sul web con LLM locali o cloud, mantenendo l’intera stack sotto il tuo controllo.
Ollama è al suo meglio quando viene trattato come un demone locale: la CLI e le tue applicazioni comunicano con un’API HTTP su loopback, e il resto della rete non viene a sapere della sua esistenza.
Server Ollama con approccio compose-first, GPU e persistenza.
Ollama funziona egregiamente su hardware nudo (bare metal). Diventa ancora più interessante quando lo si tratta come un servizio: un endpoint stabile, versioni bloccate, archiviazione persistente e una GPU che è disponibile o non lo è.
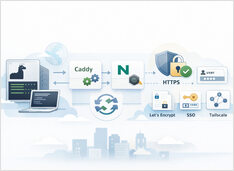
HTTPS per Ollama senza interrompere le risposte in streaming.
Eseguire Ollama dietro un proxy inverso è il modo più semplice per ottenere HTTPS, un controllo degli accessi opzionale e un comportamento di streaming prevedibile.
Se stai approfondendo la generazione potenziata dal recupero (RAG), questa sezione illustra le embeddings testuali in termini semplici: cosa sono, come si integrano nella ricerca e nel recupero, e come invocare due configurazioni locali comuni da Python utilizzando Ollama o un’API HTTP compatibile con OpenAI (come espongono molti server basati su llama.cpp).
Test di OpenCode LLM — statistiche su codifica e accuratezza
Ho testato come funziona OpenCode con diversi LLM ospitati localmente su Ollama e llama.cpp, e per confronto ho aggiunto alcuni modelli gratuiti da OpenCode Zen.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
A performance engineering hub for running LLMs efficiently: runtime behavior, bottlenecks, benchmarks, and the real constraints that shape throughput and latency.
Controlla dati e modelli con LLM ospitati in-house
L’auto-ospedalizzazione degli LLM mantiene dati, modelli e inferenza sotto il tuo controllo: una via pratica per la sovranità dell’IA per team, imprese e nazioni.
Test di velocità LLM su RTX 4080 con 16 GB di VRAM
Esecuzione di modelli linguistici di grandi dimensioni in locale offre riservatezza, funzionalità offline e costi API pari a zero.
Questo benchmark rivela esattamente cosa ci si può aspettare da 14 popolari
LLM su Ollama su una RTX 4080.