Nvidia

KV Cache su GPU da 16 GB: far funzionare davvero i contesti lunghi

KV Cache su GPU da 16 GB: far funzionare davvero i contesti lunghi

Perché un contesto di 128K fallisce con 16 GB

Un modello può pubblicizzare una finestra di contesto da 128K eppure fallire a 40K token su una GPU da 16 GB. Il limite architetturale non ha mai promesso che pesi, KV cache, buffer di calcolo e il compositor desktop potessero coesistere sulla stessa scheda.
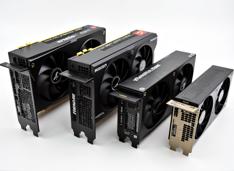
GPU per l'IA nel 2026: NVIDIA, AMD e Intel confrontate

GPU per l'IA nel 2026: NVIDIA, AMD e Intel confrontate

Confronto delle GPU AI tra tre fornitori

Il panorama dell’hardware per l’IA è cambiato significativamente nel 2026, con NVIDIA, AMD e Intel che competono per gli sviluppatori che necessitano di GPU in grado di eseguire localmente modelli linguistici di grandi dimensioni (LLM) e carichi di lavoro di inferenza IA.

Ollama in Docker Compose con GPU e archiviazione persistente dei modelli

Ollama in Docker Compose con GPU e archiviazione persistente dei modelli

Server Ollama con approccio compose-first, GPU e persistenza.

Ollama funziona egregiamente su hardware nudo (bare metal). Diventa ancora più interessante quando lo si tratta come un servizio: un endpoint stabile, versioni bloccate, archiviazione persistente e una GPU che è disponibile o non lo è.