Selfhosting

Cicli di memoria auto-rinforzanti negli agenti IA: cause e soluzioni

Cicli di memoria auto-rinforzanti negli agenti IA: cause e soluzioni

Quando le conclusioni ricordate diventano nuove prove.

La memoria persistente trasforma un agente da uno strumento che va spiegato ogni volta in uno che porta avanti il contesto — ma apre a una modalità di fallimento evitata dalla chat senza stato: un’interpretazione può diventare memoria, essere recuperata come fatto e giustificare una versione più forte di sé stessa.
Mnemosyne per Hermes Agent: Guida rapida alla memoria locale

Mnemosyne per Hermes Agent: Guida rapida alla memoria locale

Memoria locale Hermes con scritture controllate.

Mnemosyne è un provider di memoria locale-first per Hermes Agent, che archivia memoria operativa, fatti strutturati, dati temporali e cronologia episodica in SQLite locale — nessun servizio gestito, nessuna chiamata di rete obbligatoria e un controllo delle scritture insolitamente granulare.

Come migrare da OpenClaw a Hermes Agent in sicurezza

Come migrare da OpenClaw a Hermes Agent in sicurezza

Un passaggio sicuro oltre l’import in una riga

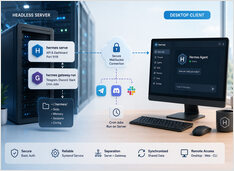
Migrare un assistente AI non è la stessa cosa di copiare la configurazione di un’applicazione. La parte difficile è preservare l’identità, la memoria, il comportamento degli strumenti, i lavori programmati e l’accesso alla messaggistica senza che due gateway agiscano come lo stesso bot.

KV Cache su GPU da 16 GB: far funzionare davvero i contesti lunghi

KV Cache su GPU da 16 GB: far funzionare davvero i contesti lunghi

Perché un contesto di 128K fallisce con 16 GB

Un modello può pubblicizzare una finestra di contesto da 128K eppure fallire a 40K token su una GPU da 16 GB. Il limite architetturale non ha mai promesso che pesi, KV cache, buffer di calcolo e il compositor desktop potessero coesistere sulla stessa scheda.

Gravità dei Dati: il vero costo dell’AI API-First

Gravità dei Dati: il vero costo dell’AI API-First

Perché il tuo stack di AI diventa più ‘appiccicoso’ ogni mese.

Ogni chiamata API sembra una semplice transazione: finché non se ne accumulano abbastanza da plasmare i tuoi dati di fine-tuning, i tuoi sistemi di valutazione e i tuoi schemi degli strumenti attorno a un unico fornitore, momento in cui il passaggio a un altro smette di essere un semplice cambio di instradamento.

GPU per l'IA nel 2026: NVIDIA, AMD e Intel confrontate

GPU per l'IA nel 2026: NVIDIA, AMD e Intel confrontate

Confronto delle GPU AI tra tre fornitori

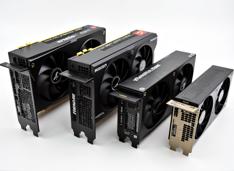
Il panorama dell’hardware per l’IA è cambiato significativamente nel 2026, con NVIDIA, AMD e Intel che competono per gli sviluppatori che necessitano di GPU in grado di eseguire localmente modelli linguistici di grandi dimensioni (LLM) e carichi di lavoro di inferenza IA.

Sistemi di memoria negli assistenti AI

Sistemi di memoria negli assistenti AI

Memoria operativa, strutturata e di recupero per gli assistenti.

La memoria trasforma gli assistenti da sistemi reattivi a sistemi persistenti, ma è anche il luogo in cui molti sistemi degradano silenziosamente. I sondaggi sostengono che la distinzione tra memoria a breve e lungo termine non sia più sufficiente per la memoria dei moderni agenti; OpenAI e gli SDK di LangGraph indicano uno stack più semplice: memoria di lavoro, stato durevole e recupero (retrieval).