Ai

Cicli di memoria auto-rinforzanti negli agenti IA: cause e soluzioni

Cicli di memoria auto-rinforzanti negli agenti IA: cause e soluzioni

Quando le conclusioni ricordate diventano nuove prove.

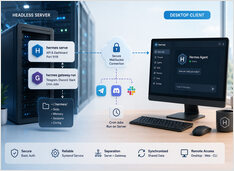
La memoria persistente trasforma un agente da uno strumento che va spiegato ogni volta in uno che porta avanti il contesto — ma apre a una modalità di fallimento evitata dalla chat senza stato: un’interpretazione può diventare memoria, essere recuperata come fatto e giustificare una versione più forte di sé stessa.
Mnemosyne per Hermes Agent: Guida rapida alla memoria locale

Mnemosyne per Hermes Agent: Guida rapida alla memoria locale

Memoria locale Hermes con scritture controllate.

Mnemosyne è un provider di memoria locale-first per Hermes Agent, che archivia memoria operativa, fatti strutturati, dati temporali e cronologia episodica in SQLite locale — nessun servizio gestito, nessuna chiamata di rete obbligatoria e un controllo delle scritture insolitamente granulare.

OpenSpec: Proposte Rifiutate – Una Convenzione per la Memoria Decisionale

OpenSpec: Proposte Rifiutate – Una Convenzione per la Memoria Decisionale

Nessun stato di rifiuto. Ecco il workaround.

Un agente che ha proposto e implementato “spostare la persistenza in una libreria condivisa” sei mesi fa proporrà volentieri di nuovo la stessa idea il prossimo trimestre, a meno che non esista un registro durevole che gli indichi come l’idea sia già stata indagata e rifiutata – e OpenSpec al momento non ha uno stato interno per questo scopo.

OpenSpec Quickstart: Installazione, Workflow e Errori più Comuni

OpenSpec Quickstart: Installazione, Workflow e Errori più Comuni

Specifica le modifiche come incrementi, non in un PRD di 40 pagine.

OpenSpec è una CLI gratuita e open source di Fission AI che consente a te e al tuo agente di coding di concordare una modifica in Markdown semplice prima che venga scritto qualsiasi codice, evitando la cerimoniale fase-gated dei framework spec-driven più pesanti.

Come migrare da OpenClaw a Hermes Agent in sicurezza

Come migrare da OpenClaw a Hermes Agent in sicurezza

Un passaggio sicuro oltre l’import in una riga

Migrare un assistente AI non è la stessa cosa di copiare la configurazione di un’applicazione. La parte difficile è preservare l’identità, la memoria, il comportamento degli strumenti, i lavori programmati e l’accesso alla messaggistica senza che due gateway agiscano come lo stesso bot.

Cosa arriva dopo gli LLM? Mamba, Diffusione e World Models

Cosa arriva dopo gli LLM? Mamba, Diffusione e World Models

Cosa arriva dopo gli LLM? L'era post-transformer.

L’hype sull’IA segue un ritmo: all’incirca ogni tre anni, l’architettura su cui tutti scommettono viene sostituita da qualcosa di più recente. Il prossimo cambiamento è già in fase di formazione nei laboratori di ricerca.

Competenze degli agenti vs server MCP: framework decisionale

Competenze degli agenti vs server MCP: framework decisionale

Abilità, server MCP o entrambi?

Le competenze degli agenti e i server MCP vengono spesso presentati come modi alternativi per estendere un agente AI. Questa inquadratura è errata: una competenza insegna all’agente come lavorare, mentre un server MCP gli fornisce accesso governato a funzionalità live.

Superpowers Quickstart: installazione, flusso di lavoro e prova

Superpowers Quickstart: installazione, flusso di lavoro e prova

Competenze SDD obbligatorie, installabili con un singolo comando.

Superpowers racchiude una metodologia completa basata sulle specifiche (spec-driven) in Claude Skills installabili, imponendo brainstorming, pianificazione, implementazione guidata da subagenti e un rigoroso TDD, anziché lasciare che tale struttura dipenda da te.

Gravità dei Dati: il vero costo dell’AI API-First

Gravità dei Dati: il vero costo dell’AI API-First

Perché il tuo stack di AI diventa più ‘appiccicoso’ ogni mese.

Ogni chiamata API sembra una semplice transazione: finché non se ne accumulano abbastanza da plasmare i tuoi dati di fine-tuning, i tuoi sistemi di valutazione e i tuoi schemi degli strumenti attorno a un unico fornitore, momento in cui il passaggio a un altro smette di essere un semplice cambio di instradamento.

Da Ollama a vLLM: quando migrare il proprio server LLM locale

Da Ollama a vLLM: quando migrare il proprio server LLM locale

Quando passare da Ollama a vLLM

Ollama è uno dei modi più semplici per eseguire un modello linguistico locale, ma la praticità può nascondere il momento in cui un esperimento locale diventa un servizio di inferenza condiviso che richiede una migliore pianificazione e osservabilità.

GPU per l'IA nel 2026: NVIDIA, AMD e Intel confrontate

GPU per l'IA nel 2026: NVIDIA, AMD e Intel confrontate

Confronto delle GPU AI tra tre fornitori

Il panorama dell’hardware per l’IA è cambiato significativamente nel 2026, con NVIDIA, AMD e Intel che competono per gli sviluppatori che necessitano di GPU in grado di eseguire localmente modelli linguistici di grandi dimensioni (LLM) e carichi di lavoro di inferenza IA.