Ai

OpenCode CLI in pratica: workflow, automazione e insidie

OpenCode CLI in pratica: workflow, automazione e insidie

Aprire OpenCode dalla riga di comando, in pratica

L’interfaccia a riga di comando di OpenCode è progettata per la scripting, le pipeline CI e l’esecuzione non supervisionata di agenti. Questo articolo è una guida pratica al suo utilizzo nel lavoro quotidiano.
Superpowers Quickstart: installazione, workflow e prova

Superpowers Quickstart: installazione, workflow e prova

Abilità SDD applicate, installate con un singolo comando.

Superpowers incapsula un’intera metodologia guidata da specifiche in Claude Skills installabili, imponendo il brainstorming, la pianificazione, l’implementazione guidata da subagenti e il TDD rigoroso, invece di lasciare quella struttura a tua discrezione.

Data Gravity: il vero costo della AI API-First

Data Gravity: il vero costo della AI API-First

Perché il vostro stack AI diventa sempre più appiccicoso ogni mese.

Ogni chiamata API sembra una semplice transazione - finché non si accumulano abbastanza da far sì che i dati di fine-tuning, gli harness di valutazione e gli schemi degli strumenti siano tutti modellati attorno a un singolo vendor, e cambiare diventi altro che una modifica al routing.

Da Ollama a vLLM: quando migrare il proprio server LLM locale

Da Ollama a vLLM: quando migrare il proprio server LLM locale

Quando passare da Ollama a vLLM

Ollama è uno dei modi più semplici per eseguire un modello linguistico locale, ma la praticità può nascondere il momento in cui un esperimento locale diventa un servizio di inferenza condiviso che richiede una migliore pianificazione e osservabilità.

GPU per l'IA nel 2026: NVIDIA, AMD e Intel confrontate

GPU per l'IA nel 2026: NVIDIA, AMD e Intel confrontate

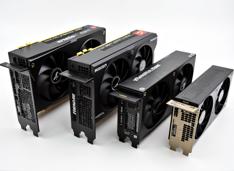
Confronto delle GPU AI tra tre fornitori

Il panorama dell’hardware per l’IA è cambiato significativamente nel 2026, con NVIDIA, AMD e Intel che competono per gli sviluppatori che necessitano di GPU in grado di eseguire localmente modelli linguistici di grandi dimensioni (LLM) e carichi di lavoro di inferenza IA.

Sicurezza degli agenti A2A e MCP: identità, delega e audit trail

Sicurezza degli agenti A2A e MCP: identità, delega e audit trail

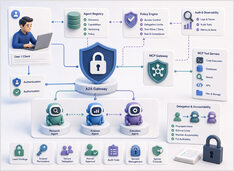
La sicurezza del protocollo riguarda chi può agire, non il modello.

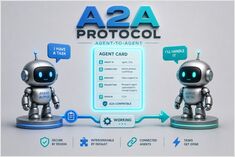
L’iniezione di prompt riceve la maggior parte dell’attenzione in termini di sicurezza nei sistemi LLM e merita attenzione, ma non è l’unico problema una volta che gli agenti iniziano a chiamare strumenti e a delegare il lavoro ad altri agenti.

Speculative Decoding: inferenza degli LLM dal 20% al 50% più veloce

Speculative Decoding: inferenza degli LLM dal 20% al 50% più veloce

Inferenza LLM più veloce senza perdita di qualità: una guida pratica

Un modello da 70B genera un token per passaggio avanti e ogni passaggio ricarica i pesi dalla VRAM, calcola l’attenzione su tutto il contesto e sincronizza la memoria. Tra un token e l’altro, la GPU resta inattiva in attesa che si risolvano le dipendenze sequenziali.