
Система памяти агента Hermes: как действительно работает персистентная память ИИ
Память — это то, что отличает инструмент от партнёра.
Вы знаете этот сценарий. Вы открываете чат с ИИ-агентом, объясняете свой проект, делитесь своими предпочтениями, выполняете часть задач и закрываете вкладку. Возвращаетесь через неделю — и это как разговор с посторонним: весь контекст утерян, все предпочтения забыты, проект нужно объяснять заново с нуля.
Это не баг. Именно так работают большие языковые модели (LLM) по своей архитектуре. Они безымянны (stateless): каждый запрос независим, каждый ответ генерируется на основе того промпта, который вы отправляете прямо сейчас, без памяти, без истории и без непрерывности за пределами токенов в текущем окне контекста.
Для одноразовых взаимодействий это нормально. Задайте вопрос, получите ответ, двигайтесь дальше. Но для агентов — систем, которые должны выполнять действия между сессиями, учиться на ошибках и эволюционировать вместе с вами, — отсутствие памяти является жестким архитектурным ограничением. Это одна из ключевых нерешенных проблем в самохостингуемых ИИ-системах.
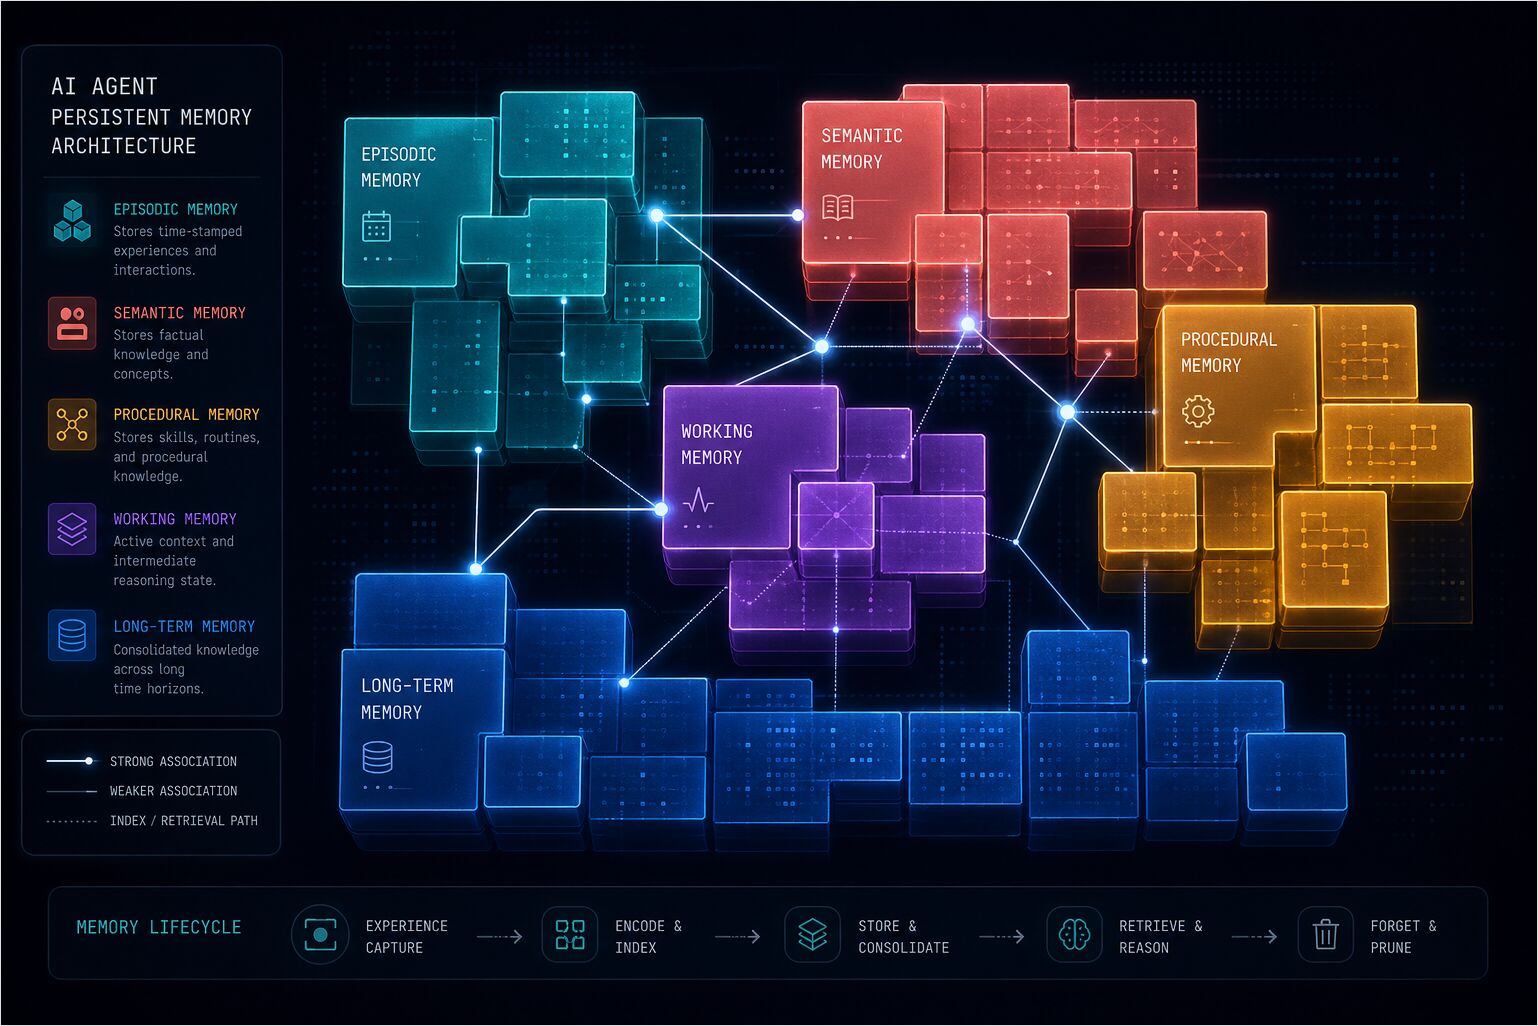
Отрасль пыталась решить эту проблему. LangChain добавила модули памяти. OpenAI представила ассистентов с трдами (потоками). Фреймворки вроде Letta, Zep и Cognee построили целые архитектуры вокруг персистентной памяти. Databricks опубликовали исследование по «масштабированию памяти» — идее о том, что производительность агента улучшается с накопленным опытом. С 2024 года появились специализированные бенчмарки, обзоры эпизодической памяти и быстро растущая экосистема инструментов, чтобы решить то, что все чаще признается одной из центральных нерешенных проблем агентного ИИ.
У большинства этих подходов есть общая проблема: они рассматривают память как добавку — как базу данных, которую нужно опрашивать, как окно контекста, которое нужно заполнять, как систему извлечения, которая добавляет задержки и шум вместо ясности.
Hermes Agent подходит к вопросу принципиально иначе. Память — это не то, что агент извлекает, когда это нужно. Это то, чем агент является постоянно — встроено в системный промпт, курировано, ограничено по объему и всегда активно. Оно достаточно мало для скорости, достаточно структурировано для полезности и достаточно дисциплинировано, чтобы знать, что забывать.
В этой статье подробно объясняется, как именно это работает — специфический для Hermes слой внутри кросс-фреймворковой модели в Системы памяти в ИИ-ассистентах и более широкая стековая архитектура в Архитектура ИИ-ассистента. Для команд активации и инспекции (hermes memory, hermes dump, просмотр логов) используйте в паре со Шпаргалкой по CLI Hermes Agent. Для дополнительной стороны «долгосрочных знаний» Hermes — переиспользуемых процедур в SKILL.md, а не курированных файлов памяти — см. Создание навыков Hermes Agent — структура и лучшие практики SKILL.md.
Часть 1: Проблема памяти ИИ-агентов
Почему «просто добавить контекст» не масштабируется для агентов
Очевидное решение для безымянного ИИ — добавить контекст. Прикрепить предыдущую беседу. Включить документацию проекта. Отправить всю историю.
В какое-то время это работает. У вас есть окно контекста на 128K. Вы можете уместить там много текста.
Но контекст — это не память; между ними есть реальная и важная разница. Контекст — это все, что вы видите прямо сейчас; память — это то, что вы активно сохраняете и несете с собой.
Контекст не курируется. Это свалка: по мере роста модели приходится обрабатывать тысячи токенов нерелевантной истории, чтобы найти один нужный факт. Это стоит токенов и денег, увеличивает задержки и в итоге упирается в потолок.
Память курируется. Это дистилляция опыта в нечто компактное и действие. Она не растет бесконечно — она консолидируется, обновляется и забывает.
Человеческая память работает так же. Вы не помните каждый разговор, который когда-либо вели. Вы помните важные части: с кем вы говорите, что их волнует, о чем вы договорились, чему вы научились. Остальное либо забыто, либо доступно для поиска, когда вам это нужно.
Обзор исследовательской области
Сфера памяти ИИ-агентов пережила взрывной рост с 2024 года: появились специализированные наборы бенчмарков, растущая исследовательская литература и измеримый разрыв в производительности между различными архитектурными подходами. Вот текущее состояние дел.
Letta (ранее MemGPT) была одним из первых фреймворков, рассматривавших персистентную память как первостепенную заботу, достигнув 21,7K звезд на GitHub. Она использует трехуровневую модель, вдохновленную ОС: ядро памяти (малое, всегда в контексте), память призыва (поисковая история разговоров) и архивная память (долгосрочное холодное хранилище). Инсайт о том, что не всякая память одинакова, был верным. Однако реализация требует, чтобы агенты работали полностью внутри рантайма Letta — принятие этого означает принятие всей платформы, а не только слоя памяти.
Zep / Graphiti фокусируется на разговорной памяти с временным отслеживанием сущностей — факты имеют окна валидности, чтобы граф знал, когда что-то было истинно. Он силен для чат-ботов, которым нужны графы отношений, но менее подходит для автономных агентов, отслеживающих факты об окружении и конвенции проекта.
Cognee создан для извлечения знаний из документов и структурированных данных, имеет более 30 коннекторов инжеста и бэкенд графа знаний. Он преуспевает в институциональных знаниях и RAG-пайплайнах, но в меньшей степени сфокусирован на личной памяти агента. Смотрите самохостинг Cognee с локальными LLM для практического руководства по настройке.
Hindsight выполняет призыв на основе графа знаний с отношениями сущностей и уникальным инструментом синтеза reflect, который выполняет перекрестный синтез памяти — объединяет несколько воспоминаний в новые инсайты. Он входит в число лидеров по бенчмаркам памяти агентов и доступен как провайдер памяти для Hermes Agent.
Mem0 обрабатывает извлечение памяти на стороне сервера через анализ LLM, требуя минимальной конфигурации. Исследовательская статья Mem0, опубликованная на ECAI 2025 (arXiv:2504.19413), проверила на стенде десять различных подходов к памяти ИИ и валидировала подход селективного извлечения — хранение дискретных фактов, дедупликация и извлечение только релевантного. Mem0 вырос примерно до 48K звезд на GitHub и поддерживает 21 интеграцию с фреймворками. Компромиссом является зависимость от облака и стоимость.
Исследование Databricks о масштабировании памяти ввело концепцию того, что производительность агента улучшается с накопленным опытом. Их архитектура хранит системные промпты, корпоративные активы и эпизодические/семантические памяти, ограниченные на уровне организации и пользователя, валидируя идею о том, что качество памяти так же важно, как и возможности модели.
Общая черта большинства фреймворков в том, что они рассматривают память как проблему извлечения: храните где-нибудь, опрашивайте при необходимости, инжектите в контекст. Hermes делает наоборот — память не извлекается по требованию, а инжектится в начале сессии и постоянно присутствует. Всегда активно, всегда доступно, достаточно курировано, чтобы оставаться полезным.
Часть 2: Архитектура
Читайте эту часть сверху вниз — сначала слои и призыв/хранение на каждый ход, затем что находится в MEMORY.md и USER.md, затем как подключить внешний провайдер.
Два слоя
Hermes накладывает память в два слоя:
- Встроенная —
MEMORY.mdиUSER.md, файл-бэкэнды, всегда активны. Жесткие лимиты в 2 200 символов (заметки агента) и 1 375 символов (профиль пользователя). - Один внешний провайдер (необязательный) — Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover, Supermemory и другие, которые вы активируете через конфигурацию. Только один внешний бэкенд работает одновременно. Он добавляет извлечение и удержание рядом с файлами; он не заменяет их.
Ментальная модель аддитивна — замороженные файлы ядра плюс максимум один плагин. Хуки предзагрузки и синхронизации оркестрируют внешний слой; два файла остаются инжектированными отдельно как часть замороженного системного промпта.
Поток выполнения (предзагрузка и синхронизация)
Призыв происходит до того, как модель отвечает; персистентность происходит после сообщения ассистента. В менеджере памяти Hermes Agent это отображается как предзагрузка (prefetch) при входе и синхронизация (sync) при выходе. Имена ниже соответствуют поверхности реализации (MemoryManager, prefetch / sync_turn / queue_prefetch для каждого провайдера).
Пользовательское сообщение
    |
    v
MemoryManager.prefetch_all(query)        <-- фаза призыва
    |
    +-- provider.prefetch(query)        <-- каждый внешний провайдер ищет в своем хранилище
    |
    v
Контекст инжектится в ход LLM
    |
    v
LLM отвечает (сообщение ассистента)
    |
    v
MemoryManager.sync_all(user, assistant)  <-- фаза хранения
    |
    +-- provider.sync_turn(user, assistant)
    +-- provider.queue_prefetch(user)    <-- фоновый поиск для следующего хода
Встроенные MEMORY.md и USER.md не извлекаются через prefetch_all — они уже являются частью замороженного системного промпта. Внешние бэкенды подключаются к prefetch_all / sync_all; queue_prefetch позволяет провайдеру прогреваить извлечение для следующего хода без блокировки текущего ответа.
Три пути в долгосрочную память
-
Встроенный инструмент
memory. Модель вызываетmemoryсadd,replaceилиremove, когда инструкции говорят, что что-то должно сохраниться — устойчивые факты, предпочтения, исправления, заметки об окружении.target='user'поддерживает USER.md;target='memory'поддерживает MEMORY.md. Пример формата:memory(action='add', target='user', content='…'). -
Пассивное удержание во внешних провайдерах. Каждый ход фреймворк вызывает путь синхронизации провайдера, чтобы разговор мог быть нарезан на блоки, суммаризирован или извлечен без того, чтобы модель называла каждый факт. Поведение отличается в зависимости от бэкенда — например, Hindsight батчит ходы и запускает структурированное удержание с сущностями и отношениями; Honcho отправляет диалог через свой диалектический пайплайн; стеки в стиле Mem0 и Supermemory пассивно извлекают факты из ходов.
-
Специфичные для провайдера инструменты. Когда плагин предоставляет их, явные записи, такие как
honcho_conclude,hindsight_retainилиhoncho_profile, хранят устойчивые срезы по требованию.
Автоматический призыв против инструментов провайдера
Ядерная память не нуждается в инструменте чтения — она уже есть в промпте. Внешние бэкенды добавляют либо автоматическую инъекцию из предзагрузки (без отдельного вызова инструмента призыва для этого среза контекста), либо явные инструменты извлечения (honcho_search, honcho_reasoning, honcho_context, hindsight_recall, hindsight_reflect и другие), когда модели нужен более точный запрос, чем одна только предзагрузка.
Режимы призыва (внешние провайдеры)
Плагины поддерживают настраиваемый режим призыва (обычно recall_mode рядом с memory.provider в конфигурации), который обменивает токены на контроль.
| Режим | Автоинжекция из предзагрузки | Инструменты провайдера доступны | Типичное применение |
|---|---|---|---|
| context | Да | Нет | Автономный, предсказуемый контекст |
| tools | Нет | Да | Модель выбирает, когда извлекать |
| hybrid | Да | Да | Самый богатый контекст; высокое использование токенов |
Когда внешний провайдер не установлен (memory.provider пустой или не задан), применяются только встроенные файлы и поиск по сессии — нет предзагрузки/синхронизации из плагина.
Пути на диске и бюджеты
Встроенная память Hermes Agent находится в двух файлах.
~/.hermes/memories/MEMORY.md— Личные заметки агента (2 200 символов, ~800 токенов)~/.hermes/memories/USER.md— Профиль пользователя (1 375 символов, ~500 токенов)
Это вся персистентная поверхность памяти: два файла, менее 3 600 символов в сумме, менее 1 300 токенов. Это намеренно выглядит маленьким, потому что это так — и это именно дизайн-намерение.
MEMORY.md: Заметки агента
Вот где агент хранит все, что узнает о своем окружении, проекте, инструментах, конвенциях и извлеченные уроки. Вот как это выглядит:
Проект пользователя — это Go-микросервис в ~/code/gateway, использующий gRPC + PostgreSQL
Эта машина работает на Ubuntu 22.04, установлены Docker и kubectl
Пользователь предпочитает snake_case для имен переменных и избегает camelCase
Это не логи. Это факты. Плотные, декларативные, насыщенные информацией. Без отметок времени, без лишнего, без «5 января пользователь попросил меня…»
USER.md: Профиль пользователя
Вот где агент хранит все, что знает о вас.
Пользователь — фуллстек-разработчик, свободно владеющий TypeScript, Go и Python.
Пользователь предпочитает snake_case для имен переменных и избегает camelCase.
Пользователь преимущественно использует Linux Ubuntu 22.04.
Пользователь развертывает на AWS, используя Terraform.
Идентичность, роль, предпочтения, технические навыки, стиль общения, раздражители. То, что заставляет агента реагировать на вас иначе, чем на любого другого.
Паттерн замороженного снимка
В начале сессии оба файла загружаются с диска и инжектятся как замороженный блок в системный промпт. Вот как это выглядит:
══════════════════════════════════════════════
MEMORY (ваши личные заметки) [7% — 166/2 200 символов]
══════════════════════════════════════════════
Проект пользователя — это Go-микросервис в ~/code/gateway, использующий gRPC + PostgreSQL
§
Эта машина работает на Ubuntu 22.04, установлены Docker и kubectl
§
Пользователь предпочитает snake_case для имен переменных и избегает camelCase
§
══════════════════════════════════════════════
USER PROFILE (кто такой пользователь) [8% — 110/1 375 символов]
══════════════════════════════════════════════
Пользователь — фуллстек-разработчик, свободно владеющий TypeScript, Go и Python.
§
Пользователь предпочитает snake_case для имен переменных и избегает camelCase.
§
Формат использует заголовки, проценты использования, количество символов и разделители § (знак секции). Записи могут быть многострочными. Он разработан так, чтобы быть разборчивым моделью, оставаясь при этом читаемым человеком.
Почему замороженный? Кэширование префикса. Системный промпт одинаков на каждом ходу в сессии. Сохраняя память статичной после начала сессии, модель может кэшировать вычисление префикса и обрабатывать только переменные части — разговор. Это значительная оптимизация производительности. Вы не пересчитываете внимание по одним и тем же токенам памяти на каждом ходу.
Изменения, сделанные в течение сессии, сразу персистятся на диск, но они появляются в системном промпте только при следующем начале сессии. Ответы инструментов всегда показывают живое состояние, но «разум» модели не меняется в середине сессии. Это предотвращает ситуацию, когда модель гонится за собственным хвостом — обновляет память и затем реагирует на собственное обновление в том же разговоре.
Ограничение символов как фича
2 200 символов. 1 375 символов. Это не произвольные лимиты. Это дизайн-ограничения, которые принуждают к курированию.
Бесконечная память — это лишний груз. Она поощряет свалить туда все, никогда не консолидировать и в конечном счете стать шумом. Ограниченная память принуждает агента быть селективным. Что действительно важно? Что мне понадобится снова? Что можно сжать без потери смысла?
Когда память заполнена, агент не просто молча падает. Он получает ошибку с текущими записями и использованием, а затем следует рабочей процедуре:
- Прочитать текущие записи из ответа об ошибке
- Идентифицировать записи, которые можно удалить или консолидировать
- Использовать
replace, чтобы объединить связанные записи в более короткие версии - Добавить новую запись
Вот так память остается полезной. Это не база данных. Это курированная коллекция важных фактов.
Безопасность: сканирование на промпт-инжектинг
Каждая запись памяти сканируется перед принятием. Система блокирует попытки промпт-инжектинга, утечку учредовательных данных, SSH-бэкдоры и невидимые Unicode-символы.
Память также дедуплицируется. Точные дубликаты записей отклоняются автоматически. Это предотвращает попытки злоумышленников внедрять вредоносный контент через повторяющиеся отправки.
Внешние провайдеры памяти (активация и ссылки)
Помимо встроенных MEMORY.md и USER.md, Hermes Agent может подключить один внешний плагин памяти за раз — Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover или Supermemory — для персистентных знаний между сессиями. Только один внешний провайдер активен одновременно; два основных файла остаются загруженными рядом с ним (аддитивно, а не замена).
Активируйте и инспектируйте провайдеров с hermes memory setup, hermes memory status и hermes memory off, или установите memory.provider и recall_mode в ~/.hermes/config.yaml. Паттерны учредовательных данных варьируются (например, HINDSIGHT_API_KEY, ключи Honcho под $HERMES_HOME/honcho.json); используйте hermes memory setup для интерактивной настройки.
Минимальная YAML-форма только со встроенными:
memory:
  provider: ""
  memory_enabled: true
  user_profile_enabled: true
Пример активации для одного бэкенда (замените hindsight на honcho, mem0, supermemory или других, которые поддерживает ваша установка):
memory:
  provider: "hindsight"
Для полной таблицы сравнения, заметок о зависимостях LLM и эмбеддингов, разборов по провайдерам и о том, как эти бэкенды соотносятся с OpenClaw и другими стеками, см. Сравнение провайдеров памяти агентов. Для локального, самохостингуемого провайдера с необычно детализированным контролем записи, см. Mnemosyne для Hermes Agent: быстрое начало локальной памяти — и Самоусиливающиеся циклы памяти в ИИ-агентах, чтобы понять, почему ограниченная, курированная память, такая как собственный MEMORY.md в Hermes, обходит несколько режимов отказа циклов обратной связи по построению.
Для настройки с профилем и производственных рабочих процессов, см. Настройка Hermes Agent для production. Хаб памяти ИИ-систем перечисляет это руководство, а также связанные статьи о Cognee и слое знаний.
Часть 3: Когда память срабатывает — триггеры и решения
Самый частый вопрос о памяти Hermes Agent — когда она действительно что-то сохраняет.
Ответ: постоянно, но селективно. Агент управляет своей памятью через инструмент memory, и решение о сохранении движимой комбинацией явных сигналов и неявных паттернов.
Триггеры записи: когда агент решает сохранить?
Агент сохраняет память проактивно. Он не ждет, пока вы попросите. Вот что его триггерит.
Исправления пользователя. Когда вы исправляете агента, это сигнал запомнить. «Больше так не делай». «Используй это вместо». «Запомни это». Это явные инструкции обновить память.
Пример: вы просите агента настроить окружение Python. Он предлагает pip. Вы говорите: «Я использую poetry для всего». Агент сохраняет: Пользователь предпочитает использовать пакетный менеджер 'poetry' для всех Python-проектов.
Обнаруженные предпочтения. Агент наблюдает паттерны и инферит предпочтения. Если вы последовательно используете определенный инструмент, фреймворк или рабочий процесс, это сохраняется.
Пример: после того, как агент видит, как вы используете poetry несколько раз в разных проектах, он сохраняет это как предпочтение.
Факты об окружении. Вещи о машине, проекте, установленных инструментах. Они обнаруживаются через исследование и сохраняются как факты.
Пример: агент проверяет, что установлено, и сохраняет: Эта машина работает на Ubuntu 22.04, установлены Docker и kubectl.
Конвенции проекта. Как структурирован проект, какие инструменты он использует, какие паттерны следует. Они обнаруживаются через инспекцию кода и сохраняются.
Пример: Проект пользователя — это Go-микросервис в ~/code/gateway, использующий gRPC + PostgreSQL.
Завершенные сложные рабочие процессы. После выполнения задачи, которая заняла 5+ вызовов инструментов, агент рассматривает сохранение подхода как навыка или хотя бы отмечает, что сработало.
Специфичности и обходные пути инструментов. Когда агент обнаруживает что-то неочевидное об инструменте, API или системе — ограничение, обходной путь, конвенцию, — он сохраняет это.
Что пропускается:
- Тривиальная или очевидная информация
- Вещи, легко обнаруженные заново
- Сырые дампы данных
- Эфемерия, специфичная для сессии
- Информация, уже в контекстных файлах (SOUL.md, AGENTS.md)
Триггеры чтения: когда агент припоминает?
Память не извлекается — она всегда есть. Но есть разные уровни доступа.
Начало сессии (автоматически). MEMORY.md и USER.md инжектятся в системный промпт. Агент имеет их с первого токена. Не нужен запрос, нет задержек, нет вызова инструмента. Это ядерная память — всегда активна.
session_search (по требованию). Когда агенту нужно найти что-то из прошлых разговоров, чего нет в ядерной памяти, он использует инструмент session_search. Это опрашивает SQLite (~/.hermes/state.db) с полнотекстовым поиском FTS5 и суммаризацией Gemini Flash. Используйте это, когда вопрос звучит как «мы обсуждали это раньше», а не «запомни этот факт навсегда».
Пример: вы спрашиваете: «Мы обсуждали сетевую настройку Docker на прошлой неделе?» Агент ищет в истории сессий и возвращает резюме соответствующего разговора.
Инструменты внешнего провайдера (когда настроен). Когда внешний провайдер памяти активен, фреймворк также выполняет автоматический шаг предзагрузки перед каждым ответом (см. Часть 2). Дополнительные инструменты, такие как honcho_search, hindsight_recall или mem0_search, предназначены для целенаправленных запросов, когда агент выбирает явное извлечение — в зависимости от recall_mode, активны могут быть автоматическая инъекция, инструменты или оба.
Дерево решений
Вот как агент взвешивает «стоит ли это запоминать?»:
Это исправление или явная инструкция?
  ДА → Сохранить в память
  НЕТ → Это предпочтение или паттерн?
    ДА → Сохранить в профиль пользователя
    НЕТ → Это факт об окружении или конвенция?
      ДА → Сохранить в память
      НЕТ → Это легко обнаружить заново?
        ДА → Пропустить
        НЕТ → Это специфично для сессии?
          ДА → Пропустить
          НЕТ → Сохранить в память
Агент не переусложняет это. Он сохраняет проактивно, консолидирует, когда заполняется, и доверяет лимитам символов, чтобы держать все в тонусе.
Часть 4: Внутренняя память против внешних баз знаний
Здесь часто возникает путаница. У Hermes Agent есть внутренняя память (MEMORY.md, USER.md, внешние провайдеры) и внешние базы знаний (LLM Wiki, Obsidian, Notion, ArXiv, файловая система), и они выполняют совершенно разные роли. Это похоже на различие между RAG-пайплайнами и рабочей памятью агента — внешнее извлечение хорошо для глубоких поисков знаний, но не для несения идентичности и предпочтений. Внутренняя память — это мозг агента — всегда активна, курируется и заносится в каждую сессию. Внешние базы знаний — это его библиотека — обширные референсные ресурсы, к которым обращаются по требованию.
Различение
Внутренняя память (мозг):
- Малая, персистентная, инжектится в системный промпт
- Содержит: предпочтения пользователя, конвенции агента, непосредственные уроки
- Всегда «в уме» во время разговора
- Курированная, ограниченная, активно управляемая
- Примеры: MEMORY.md, USER.md, Honcho, Hindsight, Mem0
Внешние базы знаний (библиотека):
- Обширная, только для референса, доступ по требованию
- Содержит: документы, статьи, код, заметки, базы данных
- Доступляется через инструменты при необходимости
- Не «запоминается» — ищется
- Примеры: LLM Wiki, Obsidian, Notion, ArXiv, файловая система, GitHub
Как они соотносятся
Агент доступляется к внешним базам через инструменты при необходимости. Он не «запоминает» их — он их ищет.
LLM Wiki (llm-wiki): База знаний Karpathy со взаимосвязанным Markdown для построения и опроса доменных знаний. Агент использует навык llm-wiki для чтения, поиска и опроса. Это референсный ресурс, а не память.
Obsidian: Личные хранилища заметок с двунаправленными ссылками. Агент использует навык obsidian для чтения, поиска и создания заметок. Obsidian является частью более широкой экосистемы личного управления знаниями, к которой Hermes может обращаться как к библиотечному ресурсу.
Notion/Airtable: Структурированные базы данных и вики, доступные через API. Агент опрашивает их при необходимости.
ArXiv: Репозитории академических статей. Агент ищет и извлекает статьи при исследовании темы.
Файловая система: Код проекта, документация, конфигурации. Агент читает файлы, работая над проектом.
Паттерн дистилляции
Вот ключевой инсайт: критические инсайты из внешних баз могут быть дистиллированы во внутреннюю память.
Пример: агент читает статью с ArXiv о масштабировании памяти для ИИ-агентов. Он не сохраняет всю статью в память. Он сохраняет ключевой вывод: Масштабирование памяти: производительность агента улучшается с накопленным опытом через взаимодействие с пользователем и бизнес-контекст, сохраненные в памяти.
Внешний ресурс обширен. Внутренняя память — это дистилляция.
Когда использовать что
Внутренняя память для:
- «Кому я помогаю?»
- «Что они предпочитают?»
- «Чему мы только что научились?»
- «Какова настройка проекта?»
- «Какие инструменты доступны?»
Внешние базы знаний для:
- «Какие последние исследования по X?»
- «Что в документации моего проекта?»
- «О чем мы говорили в прошлом месяце?»
- «Какой API у этой службы?»
- «Какова структура кода?»
Агент понимает разницу и использует каждую appropriately — он не путает поиск документа с припоминанием того, что он узнал о вас и вашем окружении.
Часть 5: Как это работает на самом деле
Давайте посмотрим на механику.
Инструмент memory
Агент управляет памятью через единый инструмент с тремя действиями: add, replace, remove.
Нет действия read — содержимое памяти автоматически инжектится в системный промпт. Агенту не нужно читать его, потому что оно всегда есть.
add — Добавляет новую запись.
memory(action="add", target="memory",
       content="Пользователь использует macOS 14 Sonoma, Homebrew, установлен Docker Desktop.")
replace — Заменяет существующую запись, используя совпадение подстроки.
memory(action="replace", target="memory",
       old_text="dark mode",
       content="Пользователь предпочитает светлый режим в VS Code, темный режим в терминале")
remove — Удаляет запись, используя совпадение подстроки.
memory(action="remove", target="memory",
       old_text="temporary project fact")
Совпадение подстроки
replace и remove используют короткие уникальные подстроки через old_text. Вам не нужен полный текст записи. Это позволяет хирургические правки без знания точного содержимого.
Если подстрока совпадает с несколькими записями, возвращается ошибка с запросом более конкретного совпадения. Затем агент уточняет свой запрос.
Целевые хранилища: memory vs user
Параметр target определяет, какой файл обновляется.
memory— Личные заметки агента. Факты об окружении, конвенции проекта, специфичности инструментов, извлеченные уроки.user— Профиль пользователя. Идентичность, роль, часовой пояс, предпочтения в общении, раздражители, привычки в рабочих процессах.
Управление емкостью
Когда память заполнена более чем на 80%, агент консолидирует. Он объединяет связанные записи, удаляет устаревшие факты и сжимает информацию.
Хорошие записи памяти компактные и информационно-плотные:
Пользователь использует macOS 14 Sonoma, Homebrew, установлен Docker Desktop. Оболочка: zsh с oh-my-zsh. Редактор: Neovim с плагином Telescope.
Плохие записи памяти размытые или многословные:
У пользователя есть проект.
5 января 2026 года пользователь попросил меня посмотреть на его проект, который находится в ~/code/gateway и использует Go с gRPC и PostgreSQL для слоя базы данных.
Первая плотная и полезная. Вторая либо слишком размыта, либо слишком многословна.
Поиск по сессии против персистентной памяти
session_search и персистентная память служат разным целям.
| Функция | Персистентная память | Поиск по сессии |
|---|---|---|
| Емкость | ~1 300 токенов всего | Неограниченная (все сессии) |
| Скорость | Мгновенная (в системном промпте) | Требует поиск + суммаризацию LLM |
| Использование | Ключевые факты всегда доступны | Поиск конкретных прошлых разговоров |
| Управление | Ручное курирование агентом | Автоматическое — хранятся все сессии |
| Стоимость токенов | Фиксированная на сессию (~1 300 токенов) | По требованию (ищется при необходимости) |
Правило: используйте память для критических фактов, которые должны всегда быть в контексте. Используйте поиск по сессии для исторических запросов.
Часть 6: Философия
Почему ограниченная память превосходит бесконечную
Инстинкт — сделать память как можно больше. Хранить все. Извлекать то, что нужно.
Ограниченная память работает лучше. Вот почему.
Курирование принуждает к качеству. Когда у вас ограничено пространство, вы сохраняете только то, что важно. Вы сжимаете, консолидируете и приоритизируете. Бесконечная память поощряет свалить туда все и никогда не наводить порядок.
Скорость важна. 1 300 токенов в системном промпте — это быстро. 100 000 токенов, извлеченных из базы данных, — это медленно. Память должна быть мгновенной, а не запросом.
Шум деградирует производительность. Больше памяти — это не лучше память. Это шумнее память. Модели приходится отличать сигнал от шума, и это требует внимания — внимания, которое должно быть потрачено на фактическую задачу.
Забывание — это фича. Человеческая память забывает. Это не баг — это то, как мы приоритизируем. Агенты тоже должны забывать. Не все заслуживает того, чтобы быть запомненным.
Проблема «забывания»
Агентам нужно отказываться от обучения. Не просто забывать, но активно удалять устаревшую информацию.
Вот как Hermes Agent с этим справляется:
- Действие
remove: Удаляет записи, которые больше не релевантны. - Действие
replace: Обновляет записи новой информацией. - Давление емкости: Когда память заполнена, агент консолидирует и удаляет старые записи.
- Безопасное сканирование: Блокирует вредоносные или поврежденные записи.
Забывание — это не отказ — это обслуживание. Агент, который не может отказываться от обучения, в конечном счете будет нести столько же шума, сколько сигнала.
Масштабирование памяти
Databricks ввели концепцию «масштабирования памяти»: работает ли агент с тысячами пользователей лучше, чем один с единственным пользователем?
Их исследование предполагает «да», но с оговорками. Масштабирование памяти требует:
- Качественное извлечение: Не все взаимодействия стоят запоминания. Агент должен извлекать инсайты, а не логи.
- Эффективное извлечение: Извлеченные воспоминания должны быть релевантны. Шум деградирует производительность.
- Обобщение: Воспоминания должны быть паттернами, а не спецификами. «Пользователь предпочитает Python» масштабируется. «Пользователь запустил команду X в метке времени Y» — нет.
Ограниченная память Hermes Agent естественным образом поддерживает масштабирование памяти. Принуждая к курированию, она гарантирует, что воспоминания обобщаемы, компактны и полезны.
Что это значит для будущего
Память становится конкурентным рвом в агентном ИИ — не сама модель, а то, что модель несет между сессиями. Два агента с идентичными базовыми моделями могут работать очень по-разному: один запоминает ваши предпочтения, ваше окружение и ваши прошлые ошибки; другой каждый раз начинает с холодного старта.
Вопрос больше не в том, должны ли агенты иметь персистентную память. Это урегулировано: должны. Открытым вопросом остается, как спроектировать эту память хорошо — что сохранить, что отбросить, как сделать ее мгновенной и как предотвратить, чтобы она не стала шумом.
Ответ Hermes Agent — держать память маленькой, курированной и всегда активной — не базой данных, которую опрашивают, а рабочей моделью пользователя, которую агент носит с собой в каждый разговор.
Заключение
Система памяти Hermes Agent намеренно проста: два файла, жесткие лимиты символов, без пайплайна извлечения, без векторной базы данных, и без задержек на запрос. То, что звучит как ограничение, является сутью.
Она работает, потому что обращается с памятью так, как работает мозг, а не так, как работает база данных — маленькая, курированная и всегда активная. Агент не извлекает память, когда ему это нужно; память просто всегда есть, вплетена в системный промпт с первого токена каждой сессии.
Внешние провайдеры памяти расширяют эту систему для пользователей, которым нужно больше: графы знаний, поддержка мульти-агентов, самохостинг, корпоративные фичи. Но ядро остается тем же: ограниченное, курированное, всегда доступное.
И внешние базы знаний — LLM Wiki, Obsidian, Notion, ArXiv — выполняют другую роль. Это библиотека, а не мозг. Агент ищет в них, не запоминает. Критические инсайты дистиллируются во внутреннюю память; остальное остается в библиотеке.
Вот так ИИ-агент запоминает вас. Не храня все, а помня то, что важно.
Hermes Agent был выпущен Nous Research в феврале 2026 года и достиг более 64 000 звезд на GitHub к апрелю 2026 года (v0.9.0), с 242+ контрибьюторами. Он является открытым исходным кодом и доступен по адресу github.com/NousResearch/hermes-agent. Для инструкций по установке, конфигурации и рабочим процессам, см. Обзор Hermes Agent.
