
GPU および永続的なモデルストレージを使用する Docker Compose での Ollama
GPU および永続性を備えた Compose ファーストの Ollama サーバー。
Ollama は、メタル(物理マシン)上で非常に良好に動作します。それをサービスとして扱うと、さらに興味深くなります。安定したエンドポイント、固定されたバージョン、永続的なストレージ、そして GPU が利用可能か不可かの明確な状態が確保されます。
GPU および永続性を備えた Compose ファーストの Ollama サーバー。
Ollama は、メタル(物理マシン)上で非常に良好に動作します。それをサービスとして扱うと、さらに興味深くなります。安定したエンドポイント、固定されたバージョン、永続的なストレージ、そして GPU が利用可能か不可かの明確な状態が確保されます。
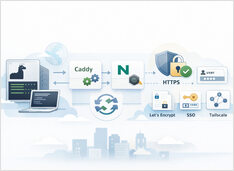
ストリーミング応答を破綻させずに HTTPS で Ollama を利用する。
リバースプロキシの背後で Ollama を実行することは、HTTPS、オプションのアクセス制御、予測可能なストリーミング動作を実現する最も簡単な方法です。
RAG エンベッディング - Python、Ollama、OpenAI API。
検索拡張生成 (RAG) を実装されている方に向けて、このセクションではテキスト埋め込み(text embeddings)について平易な言葉で解説します。埋め込みとは何か、検索や検索(リトリバル)にどのように組み込まれるか、そしてOllamaやllama.cppベースのサーバーが提供するOpenAI 互換の HTTP API を使用して、Pythonから 2 つの一般的なローカル環境を呼び出す方法を説明します。
SGLang を使ってオープンモデルを高速に提供。
SGLang は、大規模言語モデルおよびマルチモーダルモデル向けの高パフォーマンスなサービングフレームワークであり、単一の GPU から分散クラスターに至るまで、低レイテンシかつ高スループットの推論を提供するために設計されています。
クライアントを変更せずにホットスワップ可能なローカル LLM。
まもなく vLLM や llama.cpp など、それぞれのスタックが独自のポートで稼働している状態に陥ります。下流のシステムはすべて**/v1というベース URL を求めるため、ポート、プロファイル、ワンオフスクリプトを頻繁に変更することになります。llama-swapは、これらのスタックの前に配置される/v1**プロキシです。
ほとんどのローカルAIセットアップは、モデルとランタイムから始まります。
Ultrawork を実行した際に実際には何が起こるのでしょうか。
Oh My Opencode は「仮想 AI 開発チーム」を約束しています。Sisyphus が専門家を指揮し、タスクが並列で実行され、ultrawork という魔法のようなキーワードがそのすべてを活性化させます。
Oh My Opencode をインストールして、より高速にリリースしましょう。
Oh My Opencode は、OpenCode をマルチエージェントコーディングハネスへと変えます。オーケストレーターは、並行して実行される専門エージェントに作業を委任します。
OpenCode LLM テスト — コーディングおよび精度の統計
Ollama と llama.cpp でローカルホストされている複数の LLM と、比較のために追加した OpenCode Zen の無料モデルとの組み合わせで、OpenCode がどのように動作するかをテストしました。
シジフォスとその専門エージェントチームをご紹介します。
OpenCode の最大の能力向上は、専門化されたエージェントによるものです:オーケストレーション、計画、実行、調査の意図的な分離です。
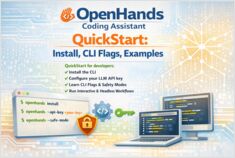
OpenHands CLI を数分でクイックスタート
OpenHands は、AI 駆動のソフトウェア開発エージェントのためのオープンソースでモデル非依存のプラットフォームです。 単なる自動補完ツールではなく、エージェントがコーディングパートナーのように振る舞うことを可能にします。
数分で LocalAI を使用して、OpenAI 互換 API をセルフホストできます。
LocalAI は、ご自身のハードウェア(ノート PC、ワークステーション、オンプレミスサーバー)上で AI ワークロードを実行できるように設計された、自己完結型でローカルファーストの推論サーバーです。これは、OpenAI API と互換性のある「差し替え可能な」APIとして動作します。
OpenCode のインストール、設定、および使用方法
ローカル推論にllama.cppに何度も戻っています。Ollamaなどが抽象化している制御を直接手に入れられる上、動作も安定しています。GGUFモデルをllama-cliで対話的に実行したり、llama-serverでOpenAI互換のHTTP APIを公開したりするのが簡単です。

人工知能(AI)は、ソフトウェアの書き方、レビュー、デプロイ、および保守のあり方を大きく変革しています。AIコーディングアシスタントから、GitOpsの自動化やDevOpsワークフローまで、開発者は現在、ソフトウェアのライフサイクル全体においてAI駆動型ツールに依存しています。
このページは、本サイトでAI開発者ツールに関するすべてのトピックの中央ハブです。チュートリアル、比較、チートシート、そして最新のAI支援開発ワークフローへの深掘り記事へと繋がっています。
AI開発者ツールとは、機械学習や大規模言語モデル(LLM)を利用して、以下のタスクを支援するソフトウェアアプリケーションです。
これらは、以下の環境に統合されます。
OpenCodeのインストール、設定、および使用方法
OpenCodeは、ターミナル(TUI + CLI)で実行できるオープンソースのAIコーディングエージェントです。オプションとしてデスクトップおよびIDE向けのインターフェースも提供されています。これはOpenCode クイックスタートです:インストール、確認、モデル/プロバイダーの接続、そして実際のワークフロー(CLI + API)の実行方法を紹介します。
Prometheus と Grafana を用いた LLM の監視
LLM の推論は「ただの API」のように見えますが、レイテンシが急増し、キューが backlog して、GPU のメモリ使用率が 95% に達しても明確な説明ができない状況に直面した際に、その真の姿が明らかになります。