
Oh My Opencode レビュー:正直な結果、請求リスク、そして投資が worthwhile なタイミング
Ultrawork を実行した際に実際には何が起こるのでしょうか。
Oh My Opencode は「仮想 AI 開発チーム」を約束しています。Sisyphus が専門家を指揮し、タスクが並列で実行され、ultrawork という魔法のようなキーワードがそのすべてを活性化させます。
Ultrawork を実行した際に実際には何が起こるのでしょうか。
Oh My Opencode は「仮想 AI 開発チーム」を約束しています。Sisyphus が専門家を指揮し、タスクが並列で実行され、ultrawork という魔法のようなキーワードがそのすべてを活性化させます。
Oh My Opencode をインストールして、より高速にリリースしましょう。
Oh My Opencode は、OpenCode をマルチエージェントコーディングハネスへと変えます。オーケストレーターは、並行して実行される専門エージェントに作業を委任します。
OpenCode LLM テスト — コーディングおよび精度の統計
Ollama と llama.cpp でローカルホストされている複数の LLM と、比較のために追加した OpenCode Zen の無料モデルとの組み合わせで、OpenCode がどのように動作するかをテストしました。
シジフォスとその専門エージェントチームをご紹介します。
OpenCode の最大の能力向上は、専門化されたエージェントによるものです:オーケストレーション、計画、実行、調査の意図的な分離です。
CLIインストール、フラグ、ヘッドレス、ローカルモデル
OpenHands は、サンドボックス内でファイルを編集し、コマンドを実行するオープンソースのコーディングエージェントです。本CLIのクイックスタートは、2026年10月26日にパッケージバージョン 1.16.0 に対して検証済みです。
数分で LocalAI を使用して、OpenAI 互換 API をセルフホストできます。
LocalAI は、ご自身のハードウェア(ノート PC、ワークステーション、オンプレミスサーバー)上で AI ワークロードを実行できるように設計された、自己完結型でローカルファーストの推論サーバーです。これは、OpenAI API と互換性のある「差し替え可能な」APIとして動作します。
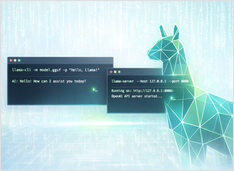
CLIおよびサーバーでGGUFモデルを実行する
llama.cpp は GGUF モデル向け C/C++ 推論エンジンです。対話型チャット用の llama-cli、スクリプトによるプロンプト処理用の llama-completion、OpenAI 互換 HTTP API 用の llama-server が含まれます。

人工知能(AI)は、ソフトウェアの作成、レビュー、デプロイ、保守の方法を根本から変えています。AIコーディングアシスタントからGitOps自動化、DevOpsワークフローに至るまで、開発者は現在、ソフトウェアライフサイクル全体でAI搭載ツールに頼っています。
このページは、当サイトにおけるAI開発ツールに関するすべての情報を収めた中核的なハブです。チュートリアル、比較記事、チートシート、最新のAI支援開発ワークフローに関する詳細な解説を、ここから一箇所で参照できます。
AI開発ツールとは、機械学習や大規模言語モデル(LLM)を用いて、以下のようなタスクを支援するためのソフトウェアアプリケーションです。
これらは、以下の環境に統合されます。
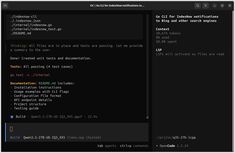
OpenCodeのインストール、設定、および使用方法
OpenCodeは、ターミナル(TUI + CLI)で実行できるオープンソースのAIコーディングエージェントであり、オプションとしてデスクトップ版やIDE対応のインターフェースも提供しています。これはOpenCode クイックスタートです:インストール、検証、モデル/プロバイダーの接続、実際のワークフローの実行(CLI + API)を扱います。
Prometheus と Grafana を用いた LLM の監視
LLM の推論は「ただの API」のように見えますが、レイテンシが急増し、キューが backlog して、GPU のメモリ使用率が 95% に達しても明確な説明ができない状況に直面した際に、その真の姿が明らかになります。
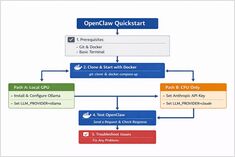
Ollamaを使用してOpenClawをローカルにインストール
OpenClawは、OllamaなどのローカルLLMランタイムや、Claude Sonnetなどのクラウドベースのモデルと併用して実行できる、セルフホスト型のAIアシスタントです。
OpenClaw AI アシスタント ガイド
ほとんどのローカルAI環境の構築は、同じところから始まります。モデル、ランタイム、そしてチャットインターフェースです。
Temporal SDKを使用してGoでワークフローを構築
LLM推論およびLLMアプリケーションのためのエンドツーエンドの可視化戦略
LLM(大規模言語モデル)システムは、従来のAPIモニタリングでは検知できない方法で失敗します。キューが静かに埋め尽くされ、CPUが忙しい状態になる遥か前にGPUメモリが飽和し、レイテンシはアプリケーションレイヤーではなくバッチ処理レイヤーで急増します。
基本的なRAGから本番環境へ:チャンキング、ベクトル検索、リランキング、および評価を1つのガイドで網羅。
本番環境のメトリクス、ダッシュボード、ログ、およびアラート機能 — Prometheus、Grafana、Kubernetes、およびAIワークロード
可観測性は、信頼性の高い本番環境システムの基盤です。
メトリクス、ダッシュボード、アラートがないと、Kubernetesクラスターは状態が不安定になり、AIワークロードはサイレントに失敗し、レイテンシの劣化はユーザーからの苦情があるまで気づかれません。