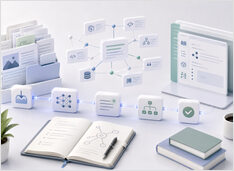
Un Wiki LLM fallisce quando vecchi fatti rimangono plausibili, le contraddizioni diventano lucide e i riassunti generati si allontanano dalle loro fonti.
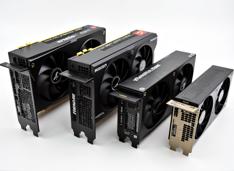
Il panorama dell’hardware per l’IA è cambiato significativamente nel 2026, con NVIDIA, AMD e Intel che competono per gli sviluppatori che necessitano di GPU in grado di eseguire localmente modelli linguistici di grandi dimensioni (LLM) e carichi di lavoro di inferenza IA.
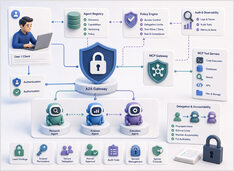
La sicurezza del protocollo riguarda chi può agire, non il modello.
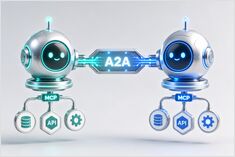
L’iniezione di prompt riceve la maggior parte dell’attenzione in termini di sicurezza nei sistemi LLM e merita attenzione, ma non è l’unico problema una volta che gli agenti iniziano a chiamare strumenti e a delegare il lavoro ad altri agenti.
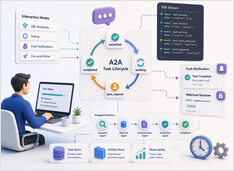
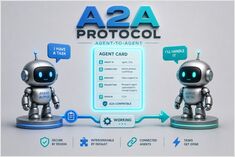
I task A2A di lunga durata superano la durata delle sessioni di chat.
La maggior parte delle demo di agenti AI si comporta ancora come completamenti di chat con passaggi aggiuntivi: invii un prompt, aspetti qualche secondo e ricevi una risposta in un’unica output.
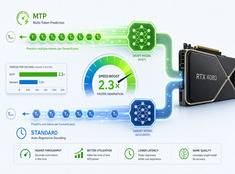
Inferenza LLM più veloce senza perdita di qualità: una guida pratica
Un modello da 70B genera un token per passaggio avanti e ogni passaggio ricarica i pesi dalla VRAM, calcola l’attenzione su tutto il contesto e sincronizza la memoria. Tra un token e l’altro, la GPU resta inattiva in attesa che si risolvano le dipendenze sequenziali.
La specifica come fonte di verità, non come documento secondario.
Lo Spec-Driven Development è uno di quegli approcci a cui gli ingegneri del software hanno fatto ricorso in passato per poi abbandonarlo quando lo sforzo smetteva di dare i suoi frutti.
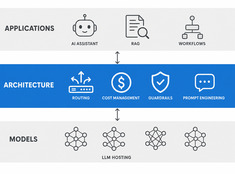
Design decisions for production LLM systems — routing, cost, guardrails, and multi-model orchestration. The layer between running models and building reliable AI applications.
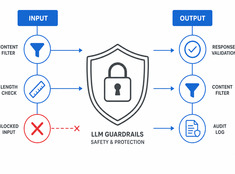
I LLM sono imprevedibili. Hallucinate, perdono dati, generano contenuti dannosi o rifiutano richieste legittime. I guardrails (meccanismi di sicurezza) vincolano il comportamento del modello senza sacrificare le sue capacità.
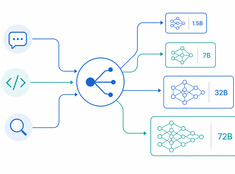
Eseguire un modello con 70 miliardi di parametri per riassumere un’email di 200 parole è uno spreco. Eseguire un modello da 3 miliardi di parametri per revisionare il codice in produzione è imprudente. La maggior parte dei sistemi si colloca da qualche punto intermedio: ed è qui che entra in gioco il routing dei modelli.
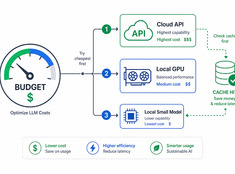
I costi degli LLM scala linearmente con l’utilizzo. Un sistema che elabora 10.000 richieste al giorno a $0,01 per richiesta costa $100 al giorno — 365 dollari l’anno. Su scala enterprise, si superano i $10.000.
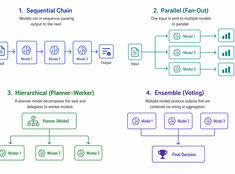
I sistemi single-model sono semplici. I sistemi multi-model sono potenti. La sfida non consiste nel scegliere i modelli, ma nel progettare l’architettura che li orchestra.