
Sviluppo guidato da specifiche vs Vibe Coding: Waterfall?
Specifiche come fonte di verità, o cerimonia lenta?
Lo Spec-Driven Development è entrato nel 2026 come la risposta seria dei sviluppatori alla deriva del vibe coding.
Specifiche come fonte di verità, o cerimonia lenta?
Lo Spec-Driven Development è entrato nel 2026 come la risposta seria dei sviluppatori alla deriva del vibe coding.

A2A non è morto. Semplicemente non è universale.
Il protocollo Agent2Agent di Google, solitamente abbreviato in A2A, ha avuto un primo anno bizzarro.
Pattern di polling affidabili per agenti AI.
Gli agenti di polling sono una delle parti meno glamour dell’architettura degli assistenti AI, ma sono anche tra le più utili.
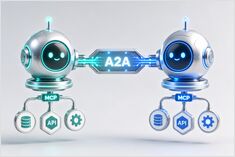
MCP fornisce agli agenti strumenti. A2A fornisce agli agenti pari.
L’architettura degli agenti AI sta iniziando a dividersi in due livelli.
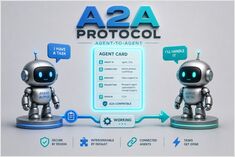
A2A trasforma gli agenti in pari della rete.
Il protocollo A2A, acronimo di Agent2Agent Protocol, è uno standard aperto per la comunicazione tra sistemi di agenti AI indipendenti.
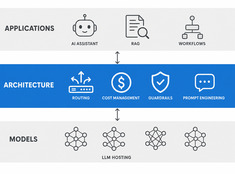
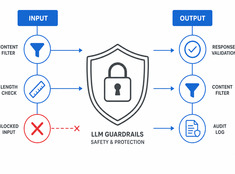
Controlla il rischio, non solo il modello.
I LLM sono imprevedibili. Hallucinate, perdono dati, generano contenuti dannosi o rifiutano richieste legittime. I guardrails (meccanismi di sicurezza) vincolano il comportamento del modello senza sacrificare le sue capacità.
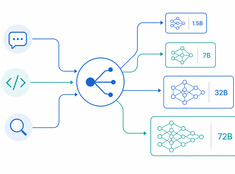
Il modello giusto per il compito giusto.
Eseguire un modello con 70 miliardi di parametri per riassumere un’e-mail di 200 parole è uno spreco. Utilizzare un modello da 3 miliardi di parametri per revisionare codice in produzione è irresponsabile. La maggior parte dei sistemi si colloca in un punto intermedio — ed è proprio qui che entra in gioco il model routing.
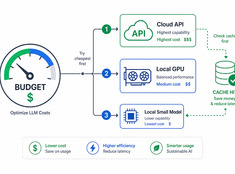
Spendi i token dove contano davvero.
I costi degli LLM scalano linearmente con l’utilizzo. Un sistema che elabora 10.000 richieste al giorno a 0,01 $ per richiesta costa 100 $ al giorno, ovvero 365 $ all’anno. Su scala enterprise, si supera i 10.000 $.
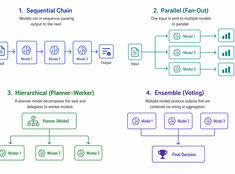
Scegli il pattern più semplice che funziona.
I sistemi a modello singolo sono semplici. I sistemi multi-modello sono potenti. La sfida non è scegliere i modelli: è progettare l’architettura che li orchestra.
Memoria operativa, strutturata e di recupero per gli assistenti.
La memoria trasforma gli assistenti da sistemi reattivi a sistemi persistenti, ma è anche il luogo in cui molti sistemi degradano silenziosamente. I sondaggi sostengono che la distinzione tra memoria a breve e lungo termine non sia più sufficiente per la memoria dei moderni agenti; OpenAI e gli SDK di LangGraph indicano uno stack più semplice: memoria di lavoro, stato durevole e recupero (retrieval).
Come vengono realmente costruiti gli assistenti seri.
Un assistente AI di produzione non è “un LLM con un prompt”. È un sistema che accetta l’intento, mantiene lo stato, decide quando recuperare dati o agire, ed espone abbastanza dettagli runtime per debuggare i fallimenti.
L'IA cambia la gestione della conoscenza, non il suo scopo.
L’intelligenza artificiale non sta sostituendo la gestione della conoscenza; sta cambiando la sua forma sia per gli individui che per i team.
Stelle, token, download: chi vince davvero?
I framework open-source per agenti AI sono in piena esplosione di popolarità su GitHub. Due progetti al cuore dell’ecosistema dei sistemi AI self-hosted — OpenClaw e Hermes Agent — hanno preso un tale vantaggio che il resto del settore combatte per un lontano terzo posto.
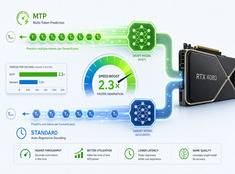
MTP vs decodifica standard su RTX 4080 — benchmark reali
Ho testato le prestazioni del decodifica speculativa (Multi-Token Prediction, MTP) con Qwen 3.6 27B e 35B su una RTX 4080 con 16 GB di VRAM.
Memoria VRAM libera senza arrestare llama-server.
Modalità router di llama.cpp è uno dei cambiamenti più utili a llama-server degli ultimi anni. Fornisce finalmente agli operatori di LLM locali un’esperienza di gestione dei modelli vicina a quella che ci si aspetta da Ollama, mantenendo al contempo le prestazioni grezze e il controllo a basso livello che rendono llama.cpp meritevole di essere utilizzato in primo luogo.