Ai

Spekulacyjne dekodowanie: 20–50% szybsza inferencja modeli LLM

Spekulacyjne dekodowanie: 20–50% szybsza inferencja modeli LLM

Szybsza inferencja LLM bez utraty jakości – praktyczny przewodnik

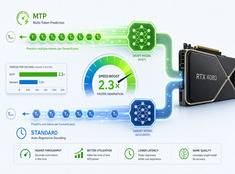
Model o 70 mld parametrów generuje jeden token w jednym przebiegu przodowym (forward pass), przy czym każda taka operacja powoduje ponowne wczytywanie wag z pamięci VRAM, obliczanie mechanizmu uwagi na całym kontekście oraz synchronizację pamięci. W odstępach między tokenami GPU pozostaje nieczynne, czekając na wyznaczenie zależności sekwencyjnych.

Ochronne mechanizmy dla LLM w praktyce: co naprawdę działa

Ochronne mechanizmy dla LLM w praktyce: co naprawdę działa

Kontroluj ryzyko, nie tylko model.

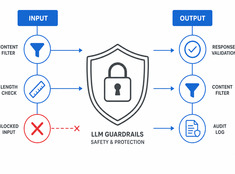
Modele językowe (LLM) są nieprzewidywalne. Mogą halucynować, wyciekać dane, generować szkodliwe treści lub odmawiać spełnienia legalnych żądań. Mechanizmy ochronne (guardrails) ograniczają zachowanie modelu, nie tracąc przy tym jego możliwości.

Routing modeli: przestań używać jednego modelu do wszystkiego

Routing modeli: przestań używać jednego modelu do wszystkiego

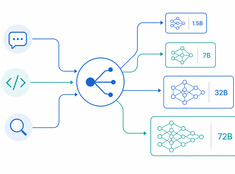
Odpowiedni model dla odpowiedniego zadania.

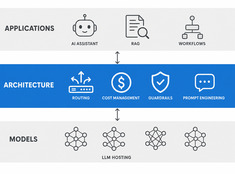
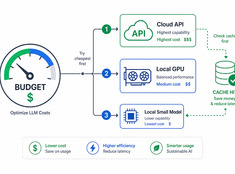
Uruchamianie modelu o 70 miliardach parametrów w celu podsumowania 200-znakowego e-maila jest marnotrawstwem. Zastosowanie modelu o 3 miliardach parametrów do recenzji kodu produkcyjnego jest bezmyślną ryzykownością. Większość systemów funkcjonuje gdzieś w tym spektrum – i tutaj z pomocą przychodzi routing modeli.

Systemy pamięci w asystentach AI

Systemy pamięci w asystentach AI

Pamięć robocza, strukturalna i odzyskiwania dla asystentów.

Pamięć zamienia asystentów w systemy trwałych, a nie tylko reaktywnych, ale to właśnie tam wiele systemów cichnie i podlega degradacji. Ankiety wskazują, że podział na pamięć krótkotrwałą i długotrwałą już nie wystarczy dla pamięci nowoczesnych agentów; SDK OpenAI i LangGraph wskazują na prostszy stos — pamięć roboczą, trwały stan i pobieranie danych (retrieval).