Security

Samowzmacniające pętle pamięci w agentach AI: przyczyny i rozwiązania

Samowzmacniające pętle pamięci w agentach AI: przyczyny i rozwiązania

„Gdy zapamiętane wnioski stają się nowymi dowodami.”

Trwała pamięć zmienia agenta z narzędzia, które wymaga ciągłego wyjaśniania kontekstu, w taki, który przenosi go do kolejnych etapów — ale otwiera tryb awarii, którego chat bezstanowy (stateless) unika: interpretacja może stać się wspomnieniem, zostać odzyskana jako fakt i uzasadnić silniejszą wersję samą siebie.
Grawitacja danych: prawdziwy koszt AI-first

Grawitacja danych: prawdziwy koszt AI-first

Dlaczego Twoje AI stacki stają się coraz trudniejsze do zmiany co miesiąc.

Każde wywołanie API sprawia wrażenie prostej transakcji – dopóki nie zgromadzi się ich wystarczająco dużo, aby Twoje dane do fine-tuning, narzędzia do ewaluacji oraz schematy narzędzi nie zostały ukształtowane wokół jednego dostawcy, a zmiana nie przestała być jedynie zmianą routingu.

Ochronne mechanizmy dla LLM w praktyce: co naprawdę działa

Ochronne mechanizmy dla LLM w praktyce: co naprawdę działa

Kontroluj ryzyko, nie tylko model.

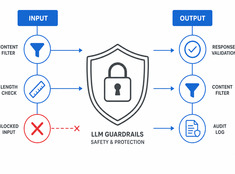
Modele językowe (LLM) są nieprzewidywalne. Mogą halucynować, wyciekać dane, generować szkodliwe treści lub odmawiać spełnienia legalnych żądań. Mechanizmy ochronne (guardrails) ograniczają zachowanie modelu, nie tracąc przy tym jego możliwości.