Ai

Mnemosyne dla agenta Hermesa: szybki start z lokalną pamięcią

Mnemosyne dla agenta Hermesa: szybki start z lokalną pamięcią

Lokalna pamięć Hermesa z kontrolowanym zapisem.

Mnemosyne to lokalny dostawca pamięci dla Hermes Agent, przechowujący pamięć roboczą, strukturę faktów, dane czasowe oraz historię epizodyczną w lokalnym pliku SQLite — bez usługi hostowanej, bez obowiązkowych połączeń z siecią i z niezwykle szczegółową kontrolą nad zapisem.
Samowzmacniające pętle pamięci w agentach AI: przyczyny i rozwiązania

Samowzmacniające pętle pamięci w agentach AI: przyczyny i rozwiązania

„Gdy zapamiętane wnioski stają się nowymi dowodami.”

Trwała pamięć zmienia agenta z narzędzia, które wymaga ciągłego wyjaśniania kontekstu, w taki, który przenosi go do kolejnych etapów — ale otwiera tryb awarii, którego chat bezstanowy (stateless) unika: interpretacja może stać się wspomnieniem, zostać odzyskana jako fakt i uzasadnić silniejszą wersję samą siebie.

OpenSpec: Odrzucone propozycje — konwencja pamięci decyzji

OpenSpec: Odrzucone propozycje — konwencja pamięci decyzji

Brak stanu odrzucenia. Oto obejście.

Agent, który sześć miesięcy temu zaproponował i wdrożył „przeniesienie trwałego przechowywania do wspólnej biblioteki”, z przyjemnością zaproponuje to samo następnego kwartału, chyba że coś trwałego powie mu, iż ten pomysł został już przeanalizowany i odrzucony – a OpenSpec obecnie nie ma wbudowanego mechanizmu do śledzenia takiego stanu.

Jak bezpiecznie przenieść się z OpenClaw na Hermesa Agent

Jak bezpiecznie przenieść się z OpenClaw na Hermesa Agent

Bezpieczne przełączenie wykraczające poza jednostronicowy import

Migracja asystenta AI to nie to samo co kopiowanie konfiguracji aplikacji. Trudnością jest zachowanie tożsamości, pamięci, zachowania narzędzi, zaplanowanych prac oraz dostępu do komunikacji, tak aby dwie bramki (gateways) nie działały jako ta sama botka.

Co po LLM? Mamba, difuzja i modele świata

Co po LLM? Mamba, difuzja i modele świata

Co nadejdzie po LLM-ach? Era post-transformerowa.

Hype wokół AI podąża za pewnym rytmem: mniej więcej co trzy lata architektura, na którą wszyscy stawiają, zostaje wypierana przez coś nowszego. Kolejna zmiana już kształtuje się w laboratoriach badawczych.

Umiejętności agenta a serwery MCP: ramy decyzyjne

Umiejętności agenta a serwery MCP: ramy decyzyjne

Umiejętność, serwer MCP czy jedno i drugie?

Umiejętności agenta i serwery MCP są często przedstawiane jako rywalizujące ze sobą sposoby rozszerzania możliwości agenta AI. To ujęcie jest błędne: umiejętność uczy agenta, jak pracować, podczas gdy serwer MCP daje mu kontrolowany dostęp do żywych funkcjonalności.

Grawitacja danych: prawdziwy koszt AI-first

Grawitacja danych: prawdziwy koszt AI-first

Dlaczego Twoje AI stacki stają się coraz trudniejsze do zmiany co miesiąc.

Każde wywołanie API sprawia wrażenie prostej transakcji – dopóki nie zgromadzi się ich wystarczająco dużo, aby Twoje dane do fine-tuning, narzędzia do ewaluacji oraz schematy narzędzi nie zostały ukształtowane wokół jednego dostawcy, a zmiana nie przestała być jedynie zmianą routingu.

Claude Code Subagenci: konfiguracja, ustawienia i przypadki użycia

Claude Code Subagenci: konfiguracja, ustawienia i przypadki użycia

Deleguj hałaśliwe zadania, utrzymuj czysty kontekst.

Większość sesji w Claude Code spowalnia i staje się nieczytelna z tego samego powodu: każde eksploracyjne użycie grep, każdy zrzut logów oraz każde „sprawdzę jeszcze jeden plik” pozostaje w głównej konwersacji na stałe.

Ollama to vLLM: kiedy migrować serwer lokalnych modeli LLM

Ollama to vLLM: kiedy migrować serwer lokalnych modeli LLM

Kiedy przejść z Ollamy na vLLM

Ollama to jeden z najprostszych sposobów na uruchomienie lokalnego modelu językowego, jednak wygoda może ukrywać moment, w którym lokalny eksperyment staje się współdzieloną usługą inferencyjną wymagającą lepszego planowania zadań i obserwowalności.

GPU dla sztucznej inteligencji w 2026 roku: porównanie NVIDIA, AMD i Intela

GPU dla sztucznej inteligencji w 2026 roku: porównanie NVIDIA, AMD i Intela

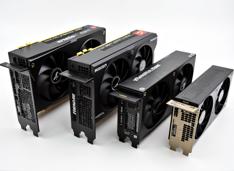
Porównanie GPU AI trzech dostawców

Krajobraz sprzętu do sztucznej inteligencji uległ znaczącej zmianie w 2026 roku, przy czym NVIDIA, AMD i Intel rywalizują o deweloperów potrzebujących kart graficznych (GPU) zdolnych do uruchamiania lokalnie dużych modeli językowych (LLM) oraz obciążeń wnioskowania (inference).

Agent Hermes: konfiguracja bezserwerowa + zdalny pulpit

Agent Hermes: konfiguracja bezserwerowa + zdalny pulpit

Serwer Headless Hermes z dostępem do zdalnego pulpitu

Uruchamianie Hermes Agent na serwerze headless (bez interfejsu graficznego) z jednoczesnym połączeniem klienta desktopowego z innego komputera wymaga uruchomienia dwóch procesów po stronie serwera oraz jednego połączenia klienckiego.