Selfhosting

Mnemosyne dla agenta Hermesa: szybki start z lokalną pamięcią

Mnemosyne dla agenta Hermesa: szybki start z lokalną pamięcią

Lokalna pamięć Hermesa z kontrolowanym zapisem.

Mnemosyne to lokalny dostawca pamięci dla Hermes Agent, przechowujący pamięć roboczą, strukturę faktów, dane czasowe oraz historię epizodyczną w lokalnym pliku SQLite — bez usługi hostowanej, bez obowiązkowych połączeń z siecią i z niezwykle szczegółową kontrolą nad zapisem.
Samowzmacniające pętle pamięci w agentach AI: przyczyny i rozwiązania

Samowzmacniające pętle pamięci w agentach AI: przyczyny i rozwiązania

„Gdy zapamiętane wnioski stają się nowymi dowodami.”

Trwała pamięć zmienia agenta z narzędzia, które wymaga ciągłego wyjaśniania kontekstu, w taki, który przenosi go do kolejnych etapów — ale otwiera tryb awarii, którego chat bezstanowy (stateless) unika: interpretacja może stać się wspomnieniem, zostać odzyskana jako fakt i uzasadnić silniejszą wersję samą siebie.

Jak bezpiecznie przenieść się z OpenClaw na Hermesa Agent

Jak bezpiecznie przenieść się z OpenClaw na Hermesa Agent

Bezpieczne przełączenie wykraczające poza jednostronicowy import

Migracja asystenta AI to nie to samo co kopiowanie konfiguracji aplikacji. Trudnością jest zachowanie tożsamości, pamięci, zachowania narzędzi, zaplanowanych prac oraz dostępu do komunikacji, tak aby dwie bramki (gateways) nie działały jako ta sama botka.

llama.cpp a Ollama w 2026 r.: który runtime powinien wybrać?

llama.cpp a Ollama w 2026 r.: który runtime powinien wybrać?

„Gdy llama-server wyprzedza Ollamę”

Ollama i llama.cpp są często porównywane tak, jakby były rywalizującymi silnikami inferencji. Rzeczywisty wybór polega na decyzji między zarządzaną usługą modeli a zestawem narzędzi, który obsługujesz bezpośrednio.

KV Cache na GPU z 16 GB pamięci: jak realnie zmieścić długi kontekst

KV Cache na GPU z 16 GB pamięci: jak realnie zmieścić długi kontekst

Dlaczego kontekst 128K zawodzi na 16 GB

Model może reklamować okno kontekstowe 128K i mimo to zawiedzie przy 40K tokenach na karcie GPU 16 GB. Architektoniczny limit nigdy nie gwarantował, że wagi, cache KV, bufora obliczeniowe i kompozytor pulpitu zmieszczą się jednocześnie na Twojej karcie.

Grawitacja danych: prawdziwy koszt AI-first

Grawitacja danych: prawdziwy koszt AI-first

Dlaczego Twoje AI stacki stają się coraz trudniejsze do zmiany co miesiąc.

Każde wywołanie API sprawia wrażenie prostej transakcji – dopóki nie zgromadzi się ich wystarczająco dużo, aby Twoje dane do fine-tuning, narzędzia do ewaluacji oraz schematy narzędzi nie zostały ukształtowane wokół jednego dostawcy, a zmiana nie przestała być jedynie zmianą routingu.

Syncthing File Sync dla samodzielnie hostowanych systemów wiedzy

Syncthing File Sync dla samodzielnie hostowanych systemów wiedzy

Przesyłanie danych lokalnych w trybie prywatnym

Syncthing synchronizuje pliki między urządzeniami, które kontrolujesz, co czyni go jednym z najbardziej praktycznych narzędzi w infrastrukturze samohostowanej wiedzy, pozwalającej uniknąć zależności od usług chmurowych.

GPU dla sztucznej inteligencji w 2026 roku: porównanie NVIDIA, AMD i Intela

GPU dla sztucznej inteligencji w 2026 roku: porównanie NVIDIA, AMD i Intela

Porównanie GPU AI trzech dostawców

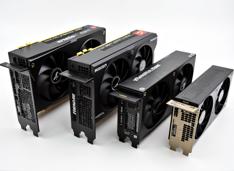
Krajobraz sprzętu do sztucznej inteligencji uległ znaczącej zmianie w 2026 roku, przy czym NVIDIA, AMD i Intel rywalizują o deweloperów potrzebujących kart graficznych (GPU) zdolnych do uruchamiania lokalnie dużych modeli językowych (LLM) oraz obciążeń wnioskowania (inference).

Agent Hermes: konfiguracja bezserwerowa + zdalny pulpit

Agent Hermes: konfiguracja bezserwerowa + zdalny pulpit

Serwer Headless Hermes z dostępem do zdalnego pulpitu

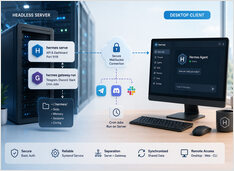
Uruchamianie Hermes Agent na serwerze headless (bez interfejsu graficznego) z jednoczesnym połączeniem klienta desktopowego z innego komputera wymaga uruchomienia dwóch procesów po stronie serwera oraz jednego połączenia klienckiego.

Systemy pamięci w asystentach AI

Systemy pamięci w asystentach AI

Pamięć robocza, strukturalna i odzyskiwania dla asystentów.

Pamięć zamienia asystentów w systemy trwałych, a nie tylko reaktywnych, ale to właśnie tam wiele systemów cichnie i podlega degradacji. Ankiety wskazują, że podział na pamięć krótkotrwałą i długotrwałą już nie wystarczy dla pamięci nowoczesnych agentów; SDK OpenAI i LangGraph wskazują na prostszy stos — pamięć roboczą, trwały stan i pobieranie danych (retrieval).