
System pamięci Hermes Agent: Jak realnie działa trwała pamięć AI
Pamięć to różnica między narzędziem a partnerem.
Znasz ten scenariusz. Otwierasz czat z agentem AI, tłumaczysz mu swój projekt, dzielisz się swoimi preferencjami, wykonujesz część pracy i zamykasz kartę. Wracasz tydzień później i czujesz się, jakbyś rozmawiał z kimś obcym — cały kontekst zniknął, każda preferencja została zapomniana, a projekt trzeba wyjaśnić od nowa.
To nie jest błąd. Takie jest działanie dużych modeli językowych (LLM) z założenia. Są bezstanowe: każde zapytanie jest niezależne, każda odpowiedź generowana jest na podstawie promptu, który wysyłasz w danej chwili, bez pamięci, bez historii i bez ciągłości wykraczającej poza tokeny w bieżącym oknie kontekstu.
W przypadku interakcji jednorundowych to nie problem. Zadajesz pytanie, otrzymujesz odpowiedź i przechodzisz dalej. Ale dla agentów — systemów, które mają wykonywać czynności między sesjami, uczyć się na błędach i ewoluować razem z Tobą — bezstanowość jest twardym ograniczeniem architektonicznym. To jeden z centralnych, nierozwiązanych problemów w systemach AI hostowanych samodzielnie.
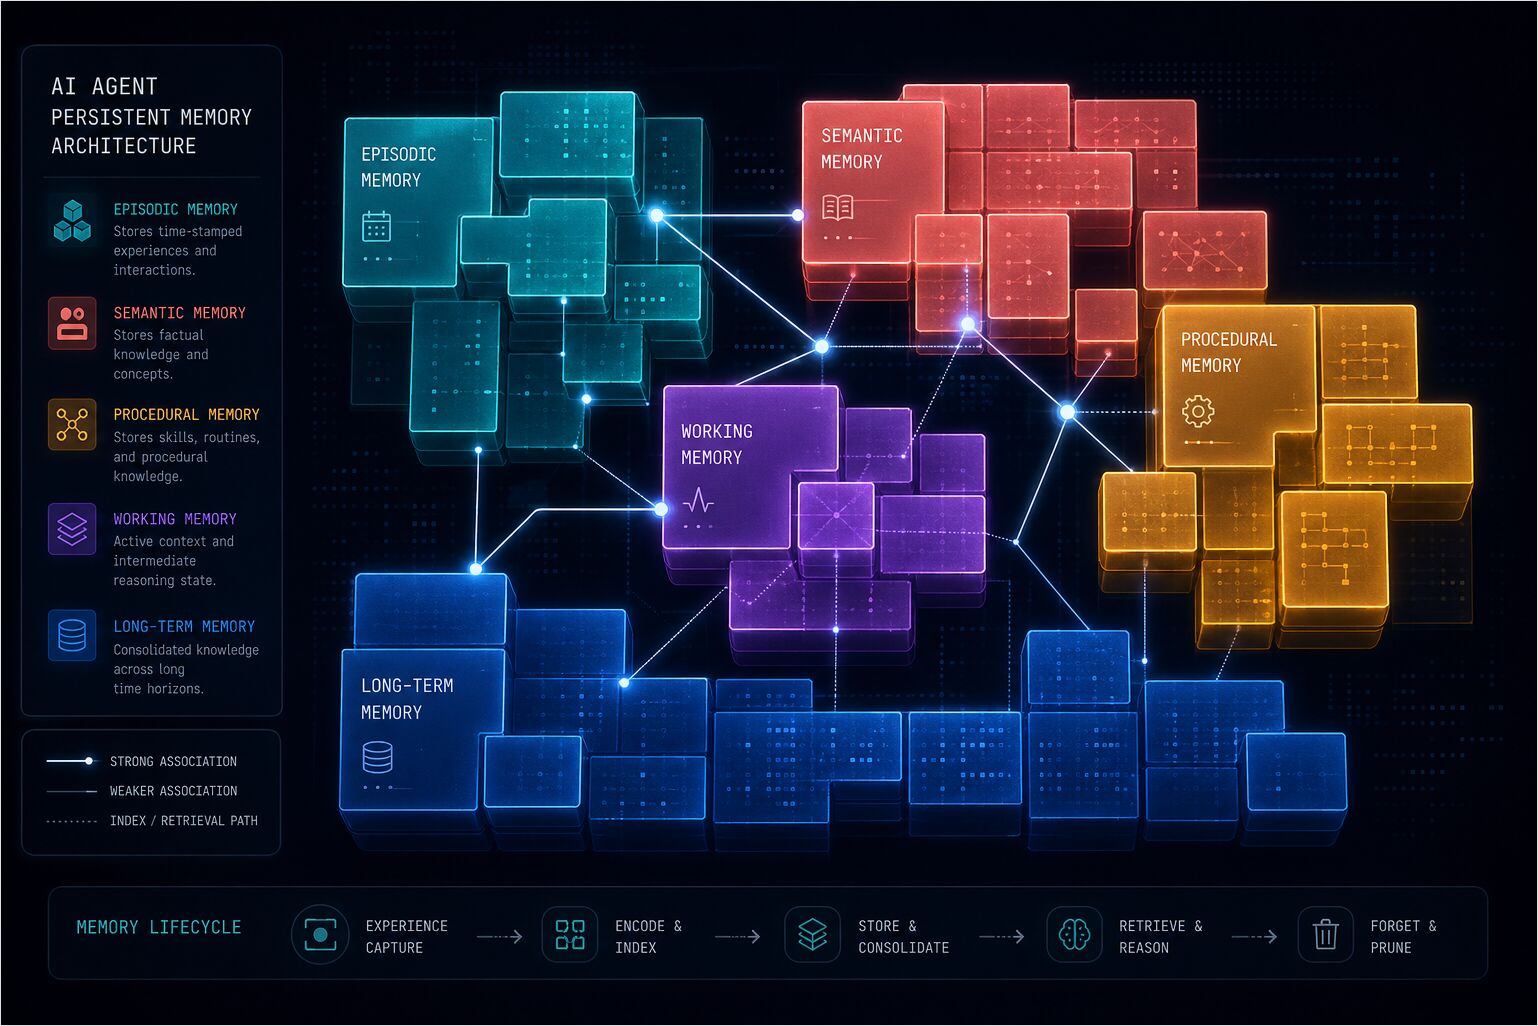
Branża próbowała to rozwiązać. LangChain dodała moduły pamięci. OpenAI wprowadziła asystentów z wątkami (threads). Frameworki takie jak Letta, Zep i Cognee zbudowały całe architektury wokół trwałej pamięci. Databricks opublikowali prace o „skalowaniu pamięci” — idei, że wydajność agentów rośnie wraz z akumulowanym doświadczeniem. Od 2024 roku pojawiły się również dedykowane zestawy benchmarków, przeglądy pamięci epizodycznej oraz szybko rozwijający się ekosystem narzędzi adresujących to, co coraz częściej uznaje się za jeden z centralnych nierozwiązanych problemów w agentic AI.
Większość tych podejść ma wspólny problem: traktują pamięć jako dodatek — bazę danych do zapytań, okno kontekstu do wypełniania, systemem odzyskiwania danych, który dodaje opóźnienia i szum, zamiast jasności.
Hermes Agent podejmuje zasadniczo inne podejście. Pamięć nie jest czymś, co agent odzykuje, gdy jest to potrzebne. To coś, czym agent jest w każdej chwili — wbudowane w prompt systemowy, kurowane, ograniczone i zawsze aktywne. Jest wystarczająco mała, aby była szybka, wystarczająco uporządkowana, aby była przydatna, i wystarczająco dyscyplinowana, aby wiedzieć, co należy zapomnieć.
Ten artykuł wyjaśnia dokładnie, jak to działa — warstwa specyficzna dla Hermes wewnątrz cross-frameworkowego modelu opisanego w Systemy pamięci w asystentach AI oraz szerszy stos opisany w Architektura asystentów AI. W przypadku poleceń aktywacji i inspekcji (hermes memory, hermes dump, przegląd logów), sparuj to ze Ściągawką CLI Hermes Agent. Aby poznać komplementarną stronę „długoterminowej wiedzy" Hermes — ponownie używalne procedury w SKILL.md zamiast kurowanych plików pamięci — zobacz [Tworzenie umiejętności Hermes Agent — struktura SKILL.md i najlepsze praktyki](https://www.glukhov.org/pl/ai-systems/hermes/authoring-hermes-skill/ “Twórz umiejętności Hermes z metadanymi YAML, stopniową ekspozycją, warunkową aktywacją, sekrety vs konfiguracja oraz kłopoty z indeksowaniem.”
Część 1: Problem pamięci agenta AI
Dlaczego „wystarczy dodać kontekst" nie skaluje się dla agentów
Otwarta metoda na rozwiązanie problemu bezstanowej AI to dodanie kontekstu. Załącz poprzednią rozmowę. Uwzględnij dokumentację projektu. Wyślij całą historię.
Przez pewien czas to działa. Masz okno kontekstu 128K. Możesz tam zmieścić dużo tekstu.
Ale kontekst to nie pamięć — istnieje realna i ważna różnica między nimi. Kontekst to wszystko, co widzisz teraz; pamięć to to, co aktywnie zachowujesz i przenosisz dalej.
Kontekst nie jest kuration. To zrzut danych: wraz ze wzrostem, model musi przetwarzać tysiące tokenów nieistotnej historii, aby znaleźć jeden potrzebny fakt. To kosztuje tokeny i pieniądze, mnoży opóźnienia i w końcu uderza w sufit.
Pamięć jest kurowana. To destylacja doświadczenia w coś kompaktowego i działającego. Nie rośnie w nieskończoność — konsoliduje się, aktualizuje i zapomina.
Pamięć ludzka działa w ten sam sposób. Nie pamiętasz każdej rozmowy, jaką kiedykolwiek prowadziłeś. Pamiętasz te części, które mają znaczenie: z kim rozmawiasz, co ich interesuje, na czym się zgodziliście, czego się nauczyłeś. Reszta jest albo zapomniana, albo wyszukiwalna, gdy jej potrzebujesz.
Krajobraz badań
Pole pamięci agentów AI wybuchło od 2024 roku, z dedykowanymi zestawami benchmarków, rosnącą literaturą badawczą i mierzalną luką wydajnościową między różnymi podejściami architektonicznymi. Oto, gdzie jesteśmy.
Letta (dawniej MemGPT) była jednym z wczesnych frameworków, które traktowały trwałą pamięć jako kwestię pierwszorzędową, osiągając 21,7K gwiazdek na GitHubie. Wykorzystuje trójwarstwową model zainspirowany systemem operacyjnym: pamięć rdzeniowa (mała, zawsze w kontekście), pamięć wywoławcza (wyszukiwalna historia rozmów) i pamięć archiwalna (długoterminowe zimne przechowywanie). Wniosek, że nie każda pamięć jest równa, był poprawny. Implementacja jednak wymaga, aby agenci działali całkowicie wewnątrz runtime’u Letta — jej przyjęcie oznacza przyjęcie całej platformy, a nie tylko warstwy pamięci.
Zep / Graphiti koncentruje się na pamięci konwersacyjnej z temporalnym śledzeniem bytów — fakty mają okna ważności, więc graf wie, kiedy coś było prawdziwe. Jest silny dla czatbotów wymagających grafów relacji, mniej nadaje się do autonomicznych agentów śledzących fakty o środowisku i konwencje projektowe.
Cognee jest zbudowany do ekstrakcji wiedzy z dokumentów i danych strukturalnych, z ponad 30 łącznikami importu i backendem grafu wiedzy. Świetnie radzi sobie z wiedzą instytucjonalną i pipeline’ami RAG, ale jest mniej skupiony na pamięci osobistego agenta. Zobacz hostowanie Cognee samodzielnie z lokalnymi LLM w celu praktycznego poradnika konfiguracji.
Hindsight wykonuje odzyskiwanie danych oparte o graf wiedzy z relacjami bytowymi i unikalnym narzędziem syntetyzacji reflect, które wykonuje syntezę pamięci między sobą — łącząc wiele pamięci w nowe wględy. Jest wśród najlepszych wykonawców w benchmarkach pamięci agentów i jest dostępny jako dostawca pamięci dla Hermes Agent.
Mem0 obsługuje ekstrakcję pamięci po stronie serwera przez analizę LLM, wymagając minimalnej konfiguracji. Artykuł badawczy Mem0, opublikowany na ECAI 2025 (arXiv:2504.19413), przebadał dziesięć różnych podejść do pamięci AI i zweryfikował podejście selektywnej ekstrakcji — przechowywanie dyskretnych faktów, deduplikacja i odzyskiwanie tylko tego, co jest istotne. Mem0 wzrósł do około 48K gwiazdek na GitHubie i obsługuje integracje z 21 frameworkami. Kompromisem jest zależność od chmury i koszt.
Badania nad skalowaniem pamięci z Databricks wprowadziły koncepcję, że wydajność agentów rośnie wraz z akumulowanym doświadczeniem. Ich architektura przechowuje prompty systemowe, zasoby firmowe oraz pamięci epizodyczne/semantyczne zakresowane na poziomie organizacji i użytkownika, potwierdzając pomysł, że jakość pamięci jest tak samo ważna jak zdolność modelu.
Wspólnym wątkiem w większości frameworków jest to, że traktują pamięć jako problem odzyskiwania danych: przechowuj gdzieś, zapytuj, gdy jest to potrzebne, wstrzykuj w kontekst. Hermes robi odwrotnie — pamięć nie jest odzyskiwana na żądanie, jest wstrzykiwana na początku sesji i zawsze obecna. Zawsze aktywna, zawsze dostępna, wystarczająco kurationa, aby pozostać użyteczną.
Część 2: Architektura
Czytaj tę część od góry — warstwy i odzyskiwanie/przechowywanie na turę najpierw, potem co znajduje się w MEMORY.md i USER.md, a potem jak dołączyć zewnętrzny dostawca.
Dwie warstwy
Hermes nakłada pamięć w dwóch warstwach:
- Wbudowana —
MEMORY.mdiUSER.md, oparta na plikach, zawsze aktywna. Twarde limity 2,200 znaków (notatki agenta) i 1,375 znaków (profil użytkownika). - Jeden zewnętrzny dostawca (opcjonalnie) — Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover, Supermemory i równe, których aktywujesz przez konfigurację. Tylko jeden zewnętrzny backend działa naraz. Dodaje odzyskiwanie i retencję obok plików; nie zastępuje ich.
Model mentalny jest addytywny — zamrożone pliki rdzeniowe plus co najwyżej jeden plugin. Haczyki prefetch i sync orkiestrują zewnętrzną warstwę; dwa pliki pozostają wstrzykiwane osobno jako część zamrożonego promptu systemowego.
Przepływ czasowo-bieżący (prefetch i sync)
Odzyskiwanie danych ma miejsce przed odpowiedź modelu; trwałość ma miejsce po wiadomości asystenta. W menedżerze pamięci Hermes Agenta odpowiada to prefetch na wejściu i sync na wyjściu. Poniższe nazwy odpowiadają powierzchni implementacji (MemoryManager, per-provider prefetch / sync_turn / queue_prefetch).
Wiadomość użytkownika
    |
    v
MemoryManager.prefetch_all(query)        <-- faza odzyskiwania
    |
    +-- provider.prefetch(query)        <-- każdy zewnętrzny dostawca przeszukuje swój magazyn
    |
    v
Kontekst wstrzyknięty w turę LLM
    |
    v
LLM odpowiada (wiadomość asystenta)
    |
    v
MemoryManager.sync_all(user, assistant)  <-- faza przechowywania
    |
    +-- provider.sync_turn(user, assistant)
    +-- provider.queue_prefetch(user)    <-- wyszukiwanie w tle w stronę następnej tury
Wbudowane MEMORY.md i USER.md nie są pobierane przez prefetch_all — są już częścią zamrożonego promptu systemowego. Zewnętrzne backends podłączają się do prefetch_all / sync_all; queue_prefetch pozwala dostawcy przygotować odzyskiwanie dla następnego tury, nie blokując bieżącej odpowiedzi.
Trzy ścieżki do pamięci długoterminowej
-
Wbudowane narzędzie
memory. Model wywołujememoryzadd,replacelubremove, gdy instrukcje mówią, że coś powinno przetrwać — trwałe fakty, preferencje, korekty, notatki o środowisku.target='user'utrzymuje USER.md;target='memory'utrzymuje MEMORY.md. Przykładowy kształt:memory(action='add', target='user', content='…'). -
Pasywna retencja na zewnętrznych dostawcach. Każdą turę framework wywołuje ścieżkę synchronizacji dostawcy, aby konwersacja mogła być kawałkowana, streszczana lub ekstraktowana, bez potrzeby nazywania przez modelu każdego faktu. Zachowanie różni się w zależności od backendu — na przykład Hindsight grupuje tury i wykonuje strukturalną retencję z bytami i relacjami; Honcho wysyła dialog przez swoją dialektyczną linię produkcyjną; stosy typu Mem0 i Supermemory pasywnie ekstraktują fakty z tur.
-
Narzędzia specyficzne dla dostawcy. Gdy plugin je udostępnia, jawne zapisy takie jak
honcho_conclude,hindsight_retainlubhoncho_profileprzechowują trwałe fragmenty na żądanie.
Automatyczne odzyskiwanie versus narzędzia dostawcy
Pamięć rdzeniowa nie potrzebuje narzędzia odczytu — jest już w promptie. Zewnętrzne backends dodają albo automatyczne wstrzykiwanie z prefetch (bez osobnego wywołania narzędzia odzyskiwania dla tego fragmentu kontekstu), albo jawne narzędzia odzyskiwania (honcho_search, honcho_reasoning, honcho_context, hindsight_recall, hindsight_reflect i równe), gdy model potrzebuje ostrzejszego zapytania niż sam prefetch.
Tryby odzyskiwania (zewnętrzni dostawcy)
Pluginy obsługują konfigurowalny tryb odzyskiwania (typowo recall_mode obok memory.provider w konfiguracji), który wymienia tokeny za kontrolę.
| Tryb | Auto-wstrzykiwanie z prefetch | Dostępne narzędzia dostawcy | Typowe zastosowanie |
|---|---|---|---|
| context | Tak | Nie | Bezobsługowy, przewidywalny kontekst |
| tools | Nie | Tak | Model decyduje, kiedy odzyskać |
| hybrid | Tak | Tak | Najbogatszy kontekst; wyższe zużycie tokenów |
Gdy nie jest ustawiony zewnętrzny dostawca (memory.provider pusty lub nieustawiony), obowiązują tylko wbudowane pliki i wyszukiwanie sesji — brak prefetch/sync z pluginu.
Ścieżki na dysku i budżety
Wbudowana pamięć Hermes Agenta znajduje się w dwóch plikach.
~/.hermes/memories/MEMORY.md— Osobiste notatki agenta (2,200 znaków, ~800 tokenów)~/.hermes/memories/USER.md— Profil użytkownika (1,375 znaków, ~500 tokenów)
To cała powierzchnia pamięci trwałej: dwa pliki, łącznie mniej niż 3,600 znaków, mniej niż 1,300 tokenów. Wygląda to celowo małe, bo takie jest — i to jest dokładnie zamiar projektowy.
MEMORY.md: Notatki agenta
To tutaj agent przechowuje wszystko, czego się dowiaduje o swoim środowisku, projekcie, narzędziach, konwencjach i wyciągniętych lekcjach. Oto jak to wygląda:
Projekt użytkownika to mikrousługa Go w ~/code/gateway używająca gRPC + PostgreSQL
Ten komputer działa na Ubuntu 22.04, ma zainstalowane Docker i kubectl
Użytkownik preferuje snake_case dla nazw zmiennych i unika camelCase
To nie są logi. To są fakty. Gęste, deklaratywne, bogate w informacje. Bez znaczków czasowych, bez zbędnych informacji, bez „5 stycznia użytkownik poprosił mnie o…".
USER.md: Profil użytkownika
To tutaj agent przechowuje wszystko, co wie o Tobie.
Użytkownik jest full-stack developerem komfortowo radzącym sobie z TypeScript, Go i Python.
Użytkownik preferuje snake_case dla nazw zmiennych i unika camelCase.
Użytkownik głównie używa Linux Ubuntu 22.04.
Użytkownik wdraża na AWS używając Terraform.
Tożsamość, rola, preferencje, umiejętności techniczne, styl komunikacji, irytujące kwestie. To, co sprawia, że agent reaguje na Ciebie inaczej niż na kogokolwiek innego.
Wzorzec zamrożonego snapshotu
Na początku sesji oba pliki są wczytywane z dysku i wstrzykiwane jako zamrożony blok w prompt systemowy. Oto jak to wygląda:
══════════════════════════════════════════════
MEMORY (twoje osobiste notatki) [7% — 166/2,200 znaków]
══════════════════════════════════════════════
Projekt użytkownika to mikrousługa Go w ~/code/gateway używająca gRPC + PostgreSQL
§
Ten komputer działa na Ubuntu 22.04, ma zainstalowane Docker i kubectl
§
Użytkownik preferuje snake_case dla nazw zmiennych i unika camelCase
§
══════════════════════════════════════════════
USER PROFILE (kim jest użytkownik) [8% — 110/1,375 znaków]
══════════════════════════════════════════════
Użytkownik jest full-stack developerem komfortowo radzącym sobie z TypeScript, Go i Python.
§
Użytkownik preferuje snake_case dla nazw zmiennych i unika camelCase.
§
Format używa nagłówków, procentów wykorzystania, liczby znaków i delimetrów § (znak sekcji). Wpisów może być wieloliniowy. Zaprojektowany tak, aby był parsowalny przez model, pozostając czytelny dla człowieka.
Dlaczego zamrożony? Cache prefiksu. Prompt systemowy jest taki sam w każdej turze sesji. Zachowując pamięć statyczną po rozpoczęciu sesji, model może zapamiętać obliczenie prefiksu i przetwarzać tylko zmienne części — konwersację. To znacząca optymalizacja wydajności. Nie przeliczasz uwagi nad tymi samymi tokenami pamięci w każdej turze.
Zmiany wprowadzone podczas sesji trwają na dysku natychmiast, ale pojawiają się w prompt systemowym dopiero na początku następnej sesji. Odpowiedzi narzędzi zawsze pokazują bieżący stan, ale „umysł" modelu nie zmienia się w trakcie sesji. Zapobiega to temu, aby model gonił własny ogon — aktualizując pamięć, a następnie reagując na własną aktualizację w tej samej rozmowie.
Limity znaków jako funkcja
2,200 znaków. 1,375 znaków. To nie są arbitralne limity. To są ograniczenia projektowe, które wymuszają kurację.
Nielimitowana pamięć to obciążenie. Zachęca do zrzucania wszystkiego, nigdy nie konsoliduje i w końcu staje się szumem. Ograniczona pamięć wymusza selektywność agenta. Co jest naprawdę ważne? Czego znów będę potrzebować? Co można skompresować bez utraty znaczenia?
Gdy pamięć jest pełna, agent nie tylko cicho zawodzi. Otrzymuje błąd z bieżącymi wpisami i wykorzystaniem, a następnie wykonuje workflow:
- Odczyt bieżących wpisów z odpowiedzi błędu
- Identyfikacja wpisów do usunięcia lub konsolidacji
- Użycie
replacedo połączenia powiązanych wpisów w krótsze wersje - Dodanie nowego wpisu
Tak pamięć pozostaje użyteczna. To nie jest baza danych. To kurationski zbiór istotnych faktów.
Bezpieczeństwo: Skanowanie na podanie promptu
Każdy wpis pamięci jest skanowany przed przyjęciem. System blokuje próby podania promptu (prompt injection), eksfiltracji poświadczeń, tylnych drzwi SSH i niewidzialnych znaków Unicode.
Pamięć jest również deduplikowana. Dokładne duplikaty wpisów są automatycznie odrzucane. Zapobiega to temu, aby przeciwnicy próbowali wstrzykać złośliwą zawartość poprzez powtarzające się wysyłki.
Zewnętrzni dostawcy pamięci (aktywacja i linki)
Poza wbudowanymi MEMORY.md i USER.md, Hermes Agent może dołączyć jeden zewnętrzny plugin pamięci naraz — Honcho, OpenViking, Mem0, Hindsight, Holographic, RetainDB, ByteRover lub Supermemory — dla trwałej, między-sesyjnej wiedzy. Tylko jeden zewnętrzny dostawca jest aktywny naraz; dwa pliki rdzeniowe pozostają wczytane obok niego (addytywnie, nie zastępczo).
Aktywuj i inspekcjonuj dostawców przez hermes memory setup, hermes memory status i hermes memory off, lub ustaw memory.provider i recall_mode w ~/.hermes/config.yaml. Wzorce poświadczeń się różnią (na przykład HINDSIGHT_API_KEY, klucze Honcho pod $HERMES_HOME/honcho.json); użyj hermes memory setup do interaktywnej konfiguracji.
Minimalny kształt YAML tylko wbudowane:
memory:
  provider: ""
  memory_enabled: true
  user_profile_enabled: true
Przykładowa aktywacja dla jednego backendu (zamień hindsight na honcho, mem0, supermemory lub inne, które obsługuje Twoja instalacja):
memory:
  provider: "hindsight"
Dla pełnej tabeli porównawczej, uwag dotyczących zależności LLM i embeddingów, rozbiorów per dostawca i powiązania tych backendów z OpenClaw i innymi stosami, zobacz Porównanie dostawców pamięci agentów. Dla lokalnego, samodzielnie hostowanego dostawcy z niezwykłą granularną kontrolą zapisu, zobacz Mnemosyne dla Hermes Agent: Szybki start lokalnej pamięci oraz [Pętle pamięci samowzmacniającej w agentach AI](https://www.glukhov.org/pl/ai-systems/memory/self-reinforcing-memory-loops/ “Pamięć agenta może przekształcać inferencje modelu w przyszłe dowody.”) dla tego, dlaczego ograniczona, kurationska pamięć, taka jak własny MEMORY.md Hermes, omija kilka trybów awaryjnych pętli sprzężenia zwrotnego przez konstrukcję.
Dla konfiguracji specyficznej dla profilu i workflow produkcyjnych, zobacz Konfiguracja produkcyjna Hermes Agent. Hub pamięci Systemów AI wymienia ten przewodnik oraz powiązane artykuły Cognee i warstwy wiedzy.
Część 3: Gdy pamięć działa — Triggery i decyzje
Najczęstsze pytanie o pamięci Hermes Agenta to, kiedy faktycznie zapisuje coś.
Odpowiedź brzmi: nieustannie, ale selektywnie. Agent zarządza własną pamięcią przez narzędzie memory, a decyzja o zapisie jest sterowana kombinacją jawnych sygnałów i niejawnych wzorców.
Triggery zapisu: Kiedy agent decyduje się zapisać?
Agent zapisuje pamięć proaktywnie. Nie czeka, aż o to poprosisz. Oto co to wywołuje.
Korekty użytkownika. Gdy poprawiasz agenta, to jest sygnał do zapamiętania. „Nie rób tego więcej." „Użyj tego zamiast tego." „Zapamiętaj to." To są jawne instrukcje aktualizacji pamięci.
Przykład: prosisz agenta o skonfigurowanie środowiska Python. Sugeruje pip. Mówisz: „Używam poetry dla wszystkiego." Agent zapisuje: Użytkownik preferuje używanie menedżera pakietów 'poetry' dla wszystkich projektów Python.
Odkryte preferencje. Agent obserwuje wzorce i inferuje preferencje. Jeśli konsekwentnie używasz pewnego narzędzia, frameworka lub workflow, to zostaje zapisane.
Przykład: po zobaczeniu, jak używasz poetry wiele razy w różnych projektach, agent zapisuje to jako preferencję.
Fakty o środowisku. Rzeczy dotyczące maszyny, projektu, zainstalowanych narzędzi. Są odkrywane przez eksplorację i zapisywane jako fakty.
Przykład: agent sprawdza, co jest zainstalowane i zapisuje: Ten komputer działa na Ubuntu 22.04, ma zainstalowane Docker i kubectl.
Konwencje projektowe. Jak projekt jest ustrukturalizowany, jakie narzędzia używa, jakie wzorce obserwuje. Są odkrywane przez inspekcję kodu i zapisywane.
Przykład: Projekt użytkownika to mikrousługa Go w ~/code/gateway używająca gRPC + PostgreSQL.
Ukończone złożone workflow. Po ukończeniu zadania, które zajęło 5+ wywołań narzędzi, agent rozważa zapisanie podejścia jako umiejętności lub co najmniej odnotowanie tego, co zadziałało.
Wady narzędzi i obejścia. Gdy agent odkryje coś nieoczywistego o narzędziu, API lub systemie — ograniczenie, obejście, konwencję — zapisuje to.
Co jest pomijane:
- Trywialne lub oczywiste informacje
- Rzeczy łatwe do ponownego odkrycia
- Surowe zrzuty danych
- Ephemeryczne, specyficzne dla sesji
- Informacje już w plikach kontekstu (SOUL.md, AGENTS.md)
Triggery odczytu: Kiedy agent odzyskuje?
Pamięć nie jest odzyskiwana — jest tam zawsze. Ale są różne poziomy dostępu.
Rozpoczęcie sesji (automatyczne). MEMORY.md i USER.md są wstrzykiwane w prompt systemowy. Agent ma je od pierwszego tokena. Brak zapytania, brak opóźnień, brak wywołania narzędzia. To jest pamięć rdzeniowa — zawsze aktywna.
session_search (na żądanie). Gdy agent musi znaleźć coś z przeszłych konwersacji, co nie znajduje się w pamięci rdzeniowej, używa narzędzia session_search. Wykonuje to zapytanie do SQLite (~/.hermes/state.db) z pełno-tekstowym wyszukiwaniem FTS5 i streszczaniem Gemini Flash. Używaj tego, gdy pytanie brzmi jak „czy rozmawialiśmy o tym wcześniej", a nie „zapamiętaj ten fakt na zawsze."
Przykład: pytasz „Czy omawialiśmy networking Docker w zeszłym tygodniu?" Agent przeszukuje historię sesji i zwraca streszczenie odpowiedniej konwersacji.
Narzędzia zewnętrznego dostawcy (gdy skonfigurowane). Gdy zewnętrzny dostawca pamięci jest aktywny, framework wykonuje również automatyczny krok prefetch przed każdą odpowiedzią (zobacz Część 2). Dodatkowe narzędzia takie jak honcho_search, hindsight_recall lub mem0_search służą do celowych wyszukiwań, gdy agent wybiera jawne odzyskiwanie — w zależności od recall_mode, może być aktywne automatyczne wstrzykiwanie, narzędzia lub oba.
Drzewo decyzyjne
Oto jak agent waży „czy to warte zapamiętania?":
Czy to jest korekta lub jawna instrukcja?
  TAK → Zapisz w pamięci
  NIE → Czy to jest preferencja lub wzorzec?
    TAK → Zapisz w profilu użytkownika
    NIE → Czy to jest fakt o środowisku lub konwencja?
      TAK → Zapisz w pamięci
      NIE → Czy to jest łatwo do ponownego odkrycia?
        TAK → Pomnij
        NIE → Czy to jest specyficzne dla sesji?
          TAK → Pomnij
          NIE → Zapisz w pamięci
Agent nie przemyśla tego nadmiernie. Zapisuje proaktywnie, konsoliduje, gdy jest pełno, i ufa limitom znaków, aby utrzymać rzeczy zwięzłe.
Część 4: Pamięć wewnętrzna versus bazy wiedzy zewnętrzne
Tu często pojawia się zamieszanie. Hermes Agent ma wewnętrzną pamięć (MEMORY.md, USER.md, zewnętrzni dostawcy) i zewnętrzne bazy wiedzy (LLM Wiki, Obsidian, Notion, ArXiv, system plików), a służą one zupełnie różnym rolom. To jest podobne do rozróżnienia między pipeline’ami generowania z wzmocnieniem odzyskiwania a pamięcią roboczą agenta — zewnętrzne odzyskiwanie jest dobre do głębokich wyszukiwań wiedzy, nie do przenoszenia tożsamości i preferencji. Wewnętrzna pamięć to mózg agenta — zawsze aktywna, kurationska, przenoszona do każdej sesji. Zewnętrzne bazy wiedzy to jego biblioteka — olbrzymie zasoby referencyjne konsultowane na żądanie.
Rozróżnienie
Wewnętrzna Pamięć (mózg):
- Mała, trwała, wstrzykiwana w prompt systemowy
- Zawiera: preferencje użytkownika, konwencje agenta, natychmiastowe lekcje
- Zawsze „w umyśle" podczas konwersacji
- Kurationska, ograniczona, aktywnie zarządzana
- Przykłady: MEMORY.md, USER.md, Honcho, Hindsight, Mem0
Zewnętrzne Bazy Wiedzy (biblioteka):
- Olbrzymie, tylko referencyjne, dostępne na żądanie
- Zawiera: dokumenty, prace, kod, notatki, bazy danych
- Dostępne przez narzędzia, gdy jest to potrzebne
- Nie są „zapamiętywane" — są wyszukiwane
- Przykłady: LLM Wiki, Obsidian, Notion, ArXiv, system plików, GitHub
Jak się wzajemnie wiążą
Agent dostaje się do zewnętrznych baz przez narzędzia, gdy jest to potrzebne. Nie „zapamiętuje" ich — je przeszukuje.
LLM Wiki (llm-wiki): Interlinkowana baza wiedzy Markdown od Karpathy’ego do budowania i zapytywania wiedzy domenowej. Agent używa umiejętności llm-wiki do odczytu, wyszukiwania i zapytania. To jest zasób referencyjny, nie pamięć.
Obsidian: Osobiste kopalnie notatek z dwustronnymi linkami. Agent używa umiejętności obsidian do odczytu, wyszukiwania i tworzenia notatek. Obsidian jest częścią szerszego ekosystemu zarządzania osobistą wiedzą, z którego Hermes może korzystać jako zasob biblioteczny.
Notion/Airtable: Strukturalne bazy danych i wikia dostępne przez API. Agent zapytuje je, gdy jest to potrzebne.
ArXiv: Repozytoria prac akademickich. Agent przeszukuje i ekstraktuje prace przy badaniu tematu.
System plików: Kod projektu, dokumentacja, konfiguracje. Agent odczytuje pliki przy pracy nad projektem.
Wzorzec destylacji
Oto kluczowy wgląd: kluczowe wględy z zewnętrznych baz mogą być destylowane do wewnętrznej pamięci.
Przykład: agent czyta pracę z ArXiv o skalowaniu pamięci dla agentów AI. Nie zapisuje całej pracy w pamięci. Zapisuje kluczowy wniosek: Skalowanie pamięci: wydajność agentów rośnie wraz z akumulowanym doświadczeniem poprzez interakcję z użytkownikiem i kontekst biznesowy przechowywany w pamięci.
Zewnętrzny zasób jest olbrzymi. Wewnętrzna pamięć to destylacja.
Kiedy używać którego
Wewnętrzna pamięć dla:
- „Kogo wspieram?"
- „Czego preferują?"
- „Czego właśnie się nauczyliśmy?"
- „Jaka jest konfiguracja projektu?"
- „Jakie narzędzia są dostępne?"
Zewnętrzne bazy wiedzy dla:
- „Jaka jest najnowsza wiedza o X?"
- „Co jest w dokumentacji mojego projektu?"
- „Co omawialiśmy w zeszłym miesiącu?"
- „Jaki jest API tej usługi?"
- „Jaka jest struktura kodu?"
Agent rozumie różnicę i używa każdego odpowiednio — nie myli szukania dokumentu z wzbudzenia czegoś, czego się nauczył o Tobie i Twoim środowisku.
Część 5: Jak to faktycznie działa
Spójrzmy na mechanikę.
Narzędzie memory
Agent zarządza pamięcią przez jedno narzędzie z trzema akcjami: add, replace, remove.
Nie ma akcji read — zawartość pamięci jest automatycznie wstrzykiwana w prompt systemowy. Agent nie musi jej odczytać, ponieważ jest tam zawsze.
add — Dodaje nowy wpis.
memory(action="add", target="memory",
       content="Użytkownik działa na macOS 14 Sonoma, używa Homebrew, ma zainstalowane Docker Desktop.")
replace — Zastępuje istniejący wpis używając dopasowania podciągów.
memory(action="replace", target="memory",
       old_text="dark mode",
       content="Użytkownik preferuje jasny tryb w VS Code, ciemny tryb w terminalu")
remove — Usuwa wpis używając dopasowania podciągów.
memory(action="remove", target="memory",
       old_text="tymczasowy fakt o projekcie")
Dopasowanie podciągów
replace i remove używają krótkich, unikalnych podciągów przez old_text. Nie potrzebujesz pełnego tekstu wpisu. To umożliwia chirurgiczne edycje bez znajomości dokładnej zawartości.
Jeśli podciąg pasuje do wielu wpisów, zwracany jest błąd żądający bardziej specyficznego dopasowania. Agent wtedy dopracowuje swoje zapytanie.
Magazyny docelowe: memory vs user
Parametr target określa, który plik zostanie zaktualizowany.
memory— Osobiste notatki agenta. Fakty o środowisku, konwencje projektowe, wady narzędzi, wyciągnięte lekcje.user— Profil użytkownika. Tożsamość, rola, strefa czasowa, preferencje komunikacyjne, irytujące kwestie, nawyki workflow.
Zarządzanie pojemnością
Gdy pamięć jest >80% pełna, agent konsoliduje. Łączy powiązane wpisy, usuwa przestarzałe fakty i kompresuje informacje.
Dobre wpisy pamięci są kompaktowe i gęste informacyjnie:
Użytkownik działa na macOS 14 Sonoma, używa Homebrew, ma zainstalowane Docker Desktop. Shell: zsh z oh-my-zsh. Edytor: Neovim z pluginem Telescope.
Złe wpisy pamięci są niejasne lub zbeletrializowane:
Użytkownik ma projekt.
5 stycznia 2026, użytkownik poprosił mnie o obejrzenie jego projektu, który znajduje się w ~/code/gateway i używa Go z gRPC oraz PostgreSQL jako warstwy bazy danych.
Pierwszy jest gęsty i użyteczny. Drugi jest albo zbyt niejasny, albo zbyt zbeletrializowany.
Wyszukiwanie sesji versus pamięć trwała
session_search i pamięć trwała służą różnym celom.
| Cecha | Pamięć trwała | Wyszukiwanie sesji |
|---|---|---|
| Pojemność | ~1,300 tokenów łącznie | Nielimitowane (wszystkie sesje) |
| Szybkość | Natychmiastowe (w prompt systemowy) | Wymaga wyszukiwania + streszczania LLM |
| Zastosowanie | Kluczowe fakty zawsze dostępne | Znajdowanie konkretnych przeszłych konwersacji |
| Zarządzanie | Manualnie kurationa przez agenta | Automatyczne — wszystkie sesje przechowywane |
| Koszt tokenów | Stały na sesję (~1,300 tokenów) | Na żądanie (szukane, gdy jest to potrzebne) |
Zasada kciuka: używaj pamięci dla kluczowych faktów, które powinny zawsze być w kontekście. Używaj wyszukiwania sesji dla przeszłych wyszukiwań.
Część 6: Filozofia
Dlaczego pamięć ograniczona wygrywa z pamięcią nielimitowaną
Instynkt sprawia, aby uczynić pamięć jak największą. Przechowuj wszystko. Odzyskaj, czego potrzebujesz.
Pamięć ograniczona działa lepiej. Oto dlaczego.
Kurations wymusza jakość. Gdy masz ograniczoną przestrzeń, zapisujesz tylko to, co ma znaczenie. Kompresujesz, konsolidujesz i priorytetyzujesz. Nielimitowana pamięć zachęca do zrzucania wszystkiego i nigdy nie sprzątania.
Szybkość ma znaczenie. 1,300 tokenów w prompt systemowym to szybko. 100,000 tokenów odzyskanych z bazy danych to powoli. Pamięć powinna być natychmiastowa, nie zapytanie.
Szum obniża wydajność. Więcej pamięci nie jest lepszą pamięcią. To pamięć szersza szumem. Model musi odróżnić sygnał od szumu, a to wymaga uwagi — uwagi, która powinna być przeznaczona na właściwe zadanie.
Zapominanie to funkcja. Pamięć ludzka zapomina. To nie jest błąd — to tak priorytetyzujemy. Agenci też powinni zapominać. Nie wszystko zasługuje na zapamiętanie.
Problem „zapominania"
Agenci muszą przestawać wiedzieć. Nie tylko zapominać, ale aktywnie usuwać przestarzałe informacje.
Oto jak Hermes Agent to obsługuje:
- Akcja
remove: Usuwa wpisy, które nie są już istotne. - Akcja
replace: Aktualizuje wpisy nowymi informacjami. - Ciśnienie pojemności: Gdy pamięć jest pełna, agent konsoliduje i usuwa stare wpisy.
- Skanowanie bezpieczeństwa: Blokuje złośliwe lub uszkodzone wpisy.
Zapominanie to nie porażka — to konserwacja. Agent, który nie może przestać wiedzieć, w końcu będzie niósł tyle szumu co sygnału.
Skalowanie pamięci
Databricks wprowadzili koncepcję „skalowania pamięci": czy agent z tysiącami użytkowników działa lepiej niż ten z jednym użytkownikiem?
Ich badania sugerują, że tak, ale z zastrzeżeniami. Skalowanie pamięci wymaga:
- Jakościowej ekstrakcji: Nie wszystkie interakcje są warte zapamiętania. Agent musi ekstraktować wględy, nie logi.
- Skutecznego odzyskiwania: Odzyskane pamięci muszą być istotne. Szum obniża wydajność.
- Generalizacji: Pamięci powinny być wzorcami, nie szczegółami. „Użytkownik preferuje Python" skaluje się. „Użytkownik uruchomił komendę X o znaczeniu czasowym Y" nie.
Ograniczona pamięć Hermes Agenta naturalnie wspiera skalowanie pamięci. Wymuszając kurations, zapewnia, że pamięci są uogólnialne, kompaktowe i użyteczne.
Co to oznacza dla przyszłości
Pamięć staje się fosą konkurencyjną w agentic AI — nie sam model, ale to, co model niesie między sesjami. Dwa agenci z identycznymi podstawowymi modelami mogą działać bardzo różnie: jeden pamięta Twoje preferencje, Twoje środowisko i Twoje przeszłe błędy; drugi zaczyna na zimno za każdym razem.
Pytanie nie brzmi już, czy agenci powinni mieć trwałą pamięć. Jest rozstrzygnięte: muszą. Otwarte pytanie to jak dobrze zaprojektować tę pamięć — co zachować, co odrzucić, jak ją uczynić natychmiastową i jak zapobiec, aby stała się szumem.
Odpowiedź Hermes Agenta to zachowanie pamięci małej, kurationskiej i zawsze aktywnej — nie baza danych do zapytań, ale działający model użytkownika, który agent niesie ze sobą do każdej rozmowy.
Wniosek
System pamięci Hermes Agent jest celowo prosty: dwa pliki, twarde limity znaków, brak pipeline’u odzyskiwania, brak bazy wektorowej i brak opóźnień per zapytanie. To, co brzmi jak ograniczenie, jest całym celem.
Działa, ponieważ traktuje pamięć tak, jak działa mózg, a nie tak, jak działa baza danych — mała, kurationska i zawsze aktywna. Agent nie odzyskuje pamięci, gdy jej potrzebuje; pamięć jest po prostu tam zawsze, wpleciona w prompt systemowy od pierwszego tokena każdej sesji.
Zewnętrzni dostawcy pamięci rozszerzają ten system dla użytkowników, którzy potrzebują więcej: grafy wiedzy, wsparcie multi-agent, samodzielne hostowanie, funkcje enterprise. Ale rdzeń pozostaje ten sam: ograniczony, kurationski, zawsze dostępny.
A zewnętrzne bazy wiedzy — LLM Wiki, Obsidian, Notion, ArXiv — pełnią inną rolę. To jest biblioteka, nie mózg. Agent je przeszukuje, nie zapamiętuje. Kluczowe wględy są destylowane do wewnętrznej pamięci; reszta pozostaje w bibliotece.
Tak agent AI pamięta Ciebie. Nie przez przechowywanie wszystkiego, ale przez pamiętanie tego, co ma znaczenie.
Hermes Agent został wydany przez Nous Research w lutym 2026 i osiągnął ponad 64,000 gwiazdek na GitHubie do kwietnia 2026 (v0.9.0), z 242+ współtwórcami. Jest open-source i dostępny na github.com/NousResearch/hermes-agent. Dla przewodników instalacji, konfiguracji i workflow, zobacz Przegląd Hermes Agent.
