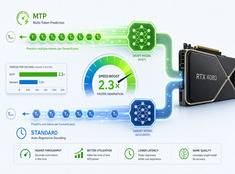
Spekulacyjne dekodowanie: 20–50% szybsza inferencja modeli LLM
Szybsza inferencja LLM bez utraty jakości – praktyczny przewodnik
Model o 70 mld parametrów generuje jeden token w jednym przebiegu przodowym (forward pass), przy czym każda taka operacja powoduje ponowne wczytywanie wag z pamięci VRAM, obliczanie mechanizmu uwagi na całym kontekście oraz synchronizację pamięci. W odstępach między tokenami GPU pozostaje nieczynne, czekając na wyznaczenie zależności sekwencyjnych.