Ollama to vLLM: kiedy migrować serwer lokalnych modeli LLM

Ollama to vLLM: kiedy migrować serwer lokalnych modeli LLM

Kiedy przejść z Ollamy na vLLM

Ollama to jeden z najprostszych sposobów na uruchomienie lokalnego modelu językowego, jednak wygoda może ukrywać moment, w którym lokalny eksperyment staje się współdzieloną usługą inferencyjną wymagającą lepszego planowania zadań i obserwowalności.
Utrzymywanie spójności specyfikacji, testów i kodu w procesie rozwoju AI

Utrzymywanie spójności specyfikacji, testów i kodu w procesie rozwoju AI

Zapobiegaj odchyleniom agentów AI od specyfikacji, testów i kodu.

Agenci kodujący z wykorzystaniem sztucznej inteligencji (AI) szybkodostarczają funkcje, ale specyfikacje, testy i kod cicho się od siebie oddalają. Ten przewodnik omawia model śledzenia (traceability), mapowanie specyfikacji na testy oraz kodu, a także sprawdzenia CI, które wychwytują rozbieżności przed scaleniem (merge).

Syncthing File Sync dla samodzielnie hostowanych systemów wiedzy

Syncthing File Sync dla samodzielnie hostowanych systemów wiedzy

Przesyłanie danych lokalnych w trybie prywatnym

Syncthing synchronizuje pliki między urządzeniami, które kontrolujesz, co czyni go jednym z najbardziej praktycznych narzędzi w infrastrukturze samohostowanej wiedzy, pozwalającej uniknąć zależności od usług chmurowych.

Wzorzec Circuit Breaker w Go: Zatrzymanie lawiny awarii

Wzorzec Circuit Breaker w Go: Zatrzymanie lawiny awarii

Zapobiegaj kaskadowym awariom w mikroserwisach Go.

Breaker obwodowy (circuit breaker) zapobiega Twojej usłudze Go w wywieraniu presji na awaryjną zależność, co zapobiega kaskadowym awariom, które pochłaniają gorutyny, gniazda i pamięć, aż do całkowitego załamania całego systemu.

Podman Quadlet vs. Docker Compose w usługach Linuksa

Podman Quadlet vs. Docker Compose w usługach Linuksa

Wybierz odpowiedni przepływ pracy dla kontenerów.

Docker Compose i Podman Quadlet rozwiązują częściowo nakładające się problemy, ale pochodzą z różnych ośrodków projektowych. Wybór między nimi zależy od tego, czy myślisz w kategoriach stosów aplikacji, czy usług Linuxa.

GPU dla sztucznej inteligencji w 2026 roku: porównanie NVIDIA, AMD i Intela

GPU dla sztucznej inteligencji w 2026 roku: porównanie NVIDIA, AMD i Intela

Porównanie GPU AI trzech dostawców

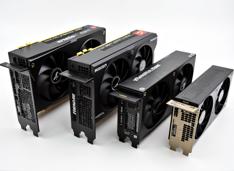
Krajobraz sprzętu do sztucznej inteligencji uległ znaczącej zmianie w 2026 roku, przy czym NVIDIA, AMD i Intel rywalizują o deweloperów potrzebujących kart graficznych (GPU) zdolnych do uruchamiania lokalnie dużych modeli językowych (LLM) oraz obciążeń wnioskowania (inference).

Agent Hermes: konfiguracja bezserwerowa + zdalny pulpit

Agent Hermes: konfiguracja bezserwerowa + zdalny pulpit

Serwer Headless Hermes z dostępem do zdalnego pulpitu

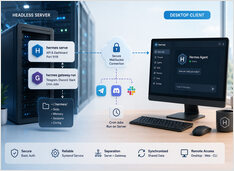
Uruchamianie Hermes Agent na serwerze headless (bez interfejsu graficznego) z jednoczesnym połączeniem klienta desktopowego z innego komputera wymaga uruchomienia dwóch procesów po stronie serwera oraz jednego połączenia klienckiego.

Workflow rozwoju oparty na specyfikacjach: od wymagań do kodu

Workflow rozwoju oparty na specyfikacjach: od wymagań do kodu

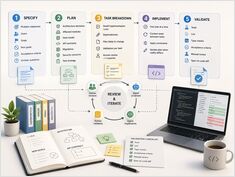
Pięć faz od intencji po zweryfikowany kod.

Rozwój oparty na specyfikacjach (Spec-Driven Development, SDD) działa, gdy specyfikacja jest procesem, a nie dokumentem, który archiwizujemy po spotkaniu kick-off. Chodzi nie o to, aby wyprodukować obszerny dokument wymagań produktu.

GitHub Spec Kit, Kiro i Claude Code: porównanie procesów SDD

GitHub Spec Kit, Kiro i Claude Code: porównanie procesów SDD

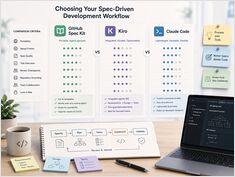
Głębokość procesu, a nie najlepsze narzędzie, wobec przenośności.

Programiści porównujący wdrożenia Spec-Driven Development (SDD) w 2026 roku zwykle nie pytają, który model jest najbystrzejszy. Pytają, który przepływ pracy utrzyma agenta AI na właściwych torach, nie obciążając ich nadmierną biurokracją.

Subskrybuj

Otrzymuj nowe wpisy o systemach, infrastrukturze i inżynierii AI.