Evergreen Notes: Pisząc notatki, które z czasem rosną w siłę

Evergreen Notes: Pisząc notatki, które z czasem rosną w siłę

Notatki, które się rozwijają, a nie ulegają zanikowi.

Większość notatek inżynierskich jest pisana raz i zapominana. Zapisujesz coś podczas sesji debugowania, wklejasz to gdzieś i znajdujesz ponownie dwa lata później, nie mając pojęcia, dlaczego to kiedykolwiek miało znaczenie.
Routing modeli: przestań używać jednego modelu do wszystkiego

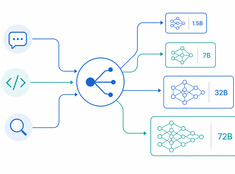
Routing modeli: przestań używać jednego modelu do wszystkiego

Odpowiedni model dla odpowiedniego zadania.

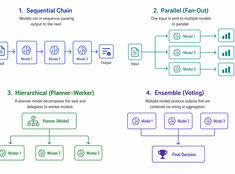
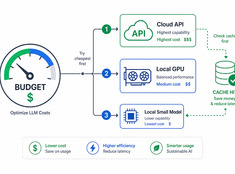
Uruchamianie modelu o 70 miliardach parametrów w celu podsumowania 200-znakowego e-maila jest marnotrawstwem. Zastosowanie modelu o 3 miliardach parametrów do recenzji kodu produkcyjnego jest bezmyślną ryzykownością. Większość systemów funkcjonuje gdzieś w tym spektrum – i tutaj z pomocą przychodzi routing modeli.

Ochronne mechanizmy dla LLM w praktyce: co naprawdę działa

Ochronne mechanizmy dla LLM w praktyce: co naprawdę działa

Kontroluj ryzyko, nie tylko model.

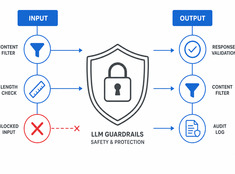
Modele językowe (LLM) są nieprzewidywalne. Mogą halucynować, wyciekać dane, generować szkodliwe treści lub odmawiać spełnienia legalnych żądań. Mechanizmy ochronne (guardrails) ograniczają zachowanie modelu, nie tracąc przy tym jego możliwości.

Systemy pamięci w asystentach AI

Systemy pamięci w asystentach AI

Pamięć robocza, strukturalna i odzyskiwania dla asystentów.

Pamięć zamienia asystentów w systemy trwałych, a nie tylko reaktywnych, ale to właśnie tam wiele systemów cichnie i podlega degradacji. Ankiety wskazują, że podział na pamięć krótkotrwałą i długotrwałą już nie wystarczy dla pamięci nowoczesnych agentów; SDK OpenAI i LangGraph wskazują na prostszy stos — pamięć roboczą, trwały stan i pobieranie danych (retrieval).

Usuń wszystkie modele routera llama.cpp bez restartowania

Usuń wszystkie modele routera llama.cpp bez restartowania

Darmowa pamięć VRAM bez zabijania llama-server.

Tryb routera w llama.cpp to jedna z najbardziej przydatnych zmian wprowadzonych do llama-server w ciągu ostatnich lat. Wreszcie daje lokalnym operatorom modeli LLM coś w rodzaju zarządzania modelami, do którego są przyzwyczajeni z Ollama, jednocześnie zachowując surową wydajność i kontrolę na niskim poziomie, która sprawia, że warto korzystać z llama.cpp w pierwszej kolejności.

Pobieranie vs. reprezentacja w systemach wiedzy

Pobieranie vs. reprezentacja w systemach wiedzy

Wyszukiwanie nie jest strukturą wiedzy

Większość współczesnych systemów wiedzy optymalizuje wyszukiwanie (retrieval), co jest zrozumiałe. Wyszukiwanie jest widoczne, łatwe do demonstracji i wydaje się magiczne, gdy działa poprawnie. Wpisujesz pytanie, otrzymujesz odpowiedź.

Subskrybuj

Otrzymuj nowe wpisy o systemach, infrastrukturze i inżynierii AI.