
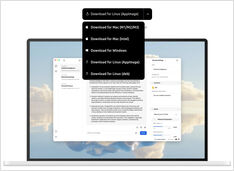
Frontend per LLM
Non ce ne sono così tanti tra cui scegliere, ma comunque....
Quando ho iniziato a sperimentare con gli LLM, le loro interfacce utente erano in fase di sviluppo attivo e ora alcune di esse sono davvero buone.
Non ce ne sono così tanti tra cui scegliere, ma comunque....
Quando ho iniziato a sperimentare con gli LLM, le loro interfacce utente erano in fase di sviluppo attivo e ora alcune di esse sono davvero buone.
Test della rilevazione delle fallacie logiche
Recentemente abbiamo visto l’uscita di diversi nuovi LLM. Tempi eccitanti. Proviamo a testarli e a vedere come si comportano nel rilevare le fallacie logiche.
Richiede alcuni esperimenti ma
Tuttavia, esistono alcuni approcci comuni per scrivere promemoria efficaci in modo che i modelli linguistici non si confondano cercando di capire cosa si desidera da essi.
8 versioni di llama3 (Meta+) e 5 versioni di phi3 (Microsoft) LLM
Testare come si comportano i modelli con diverso numero di parametri e quantizzazione.
I file dei modelli LLM di Ollama occupano molto spazio
Dopo aver installato Ollama, è meglio riconfigurare immediatamente Ollama per archivarli nel nuovo luogo. In questo modo, quando viene scaricato un nuovo modello, non verrà salvato nella vecchia posizione.
Verifichiamo la velocità degli LLM su GPU rispetto al CPU
Confronto della velocità di previsione di diverse versioni degli LLM (Large Language Models): llama3 (Meta/Facebook), phi3 (Microsoft), gemma (Google), mistral (open source) su CPU e GPU.
Verifichiamo la qualità del rilevamento delle fallacie logiche di diversi LLM
Ecco qui che confronto diverse versioni di LLM: Llama3 (Meta), Phi3 (Microsoft), Gemma (Google), Mistral Nemo (Mistral AI) e Qwen (Alibaba).