
Sviluppo guidato da specifiche vs Vibe Coding: Waterfall?
Specifiche come fonte di verità, o cerimonia lenta?
Lo Spec-Driven Development è entrato nel 2026 come la risposta seria dei sviluppatori alla deriva del vibe coding.
Specifiche come fonte di verità, o cerimonia lenta?
Lo Spec-Driven Development è entrato nel 2026 come la risposta seria dei sviluppatori alla deriva del vibe coding.
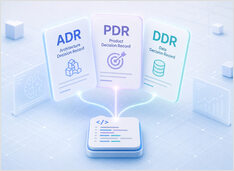
Mantieni l'intento vicino al codice.
I registrazioni di decisione costituiscono lo strato di memoria mancante nello sviluppo del software assistito dall’IA. Non catturano solo ciò che è stato costruito, ma anche il perché — una distinzione che diventa cruciale quando gli strumenti di IA sono a scrivere il tuo codice.

A2A non è morto. Semplicemente non è universale.
Il protocollo Agent2Agent di Google, solitamente abbreviato in A2A, ha avuto un primo anno bizzarro.
Pattern di polling affidabili per agenti AI.
Gli agenti di polling sono una delle parti meno glamour dell’architettura degli assistenti AI, ma sono anche tra le più utili.
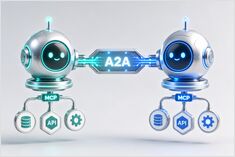
MCP fornisce agli agenti strumenti. A2A fornisce agli agenti pari.
L’architettura degli agenti AI sta iniziando a dividersi in due livelli.
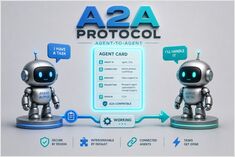
A2A trasforma gli agenti in pari della rete.
Il protocollo A2A, acronimo di Agent2Agent Protocol, è uno standard aperto per la comunicazione tra sistemi di agenti AI indipendenti.
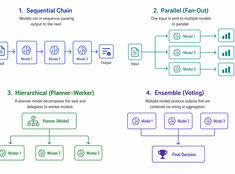
Scegli il pattern più semplice che funziona.
I sistemi a modello singolo sono semplici. I sistemi multi-modello sono potenti. La sfida non è scegliere i modelli: è progettare l’architettura che li orchestra.
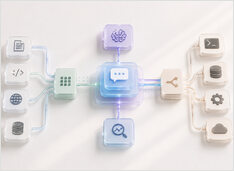
Come vengono realmente costruiti gli assistenti seri.
Un assistente AI di produzione non è “un LLM con un prompt”. È un sistema che accetta l’intento, mantiene lo stato, decide quando recuperare dati o agire, ed espone abbastanza dettagli runtime per debuggare i fallimenti.
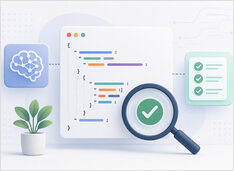
Smetti di interpretare le vibrazioni. Convalida i contratti.
La maggior parte dei tutorial sull’output strutturato degli LLM è superficiale. Ti insegnano a chiedere JSON gentilmente e poi sperare che il modello si comporti correttamente. Quello non è convalida. È ottimismo con le parentesi graffe.
Riferimento per l'ottimizzazione di LLM agentic
Questa pagina è un riferimento pratico per la regolazione dell’inferenza di LLM agentic (temperatura, top_p, top_k, penalità e come interagiscono in flussi di lavoro multi-step e intensivi nell’uso di strumenti).
Crea Claude Skills che resistano al lavoro reale
La maggior parte dei team usa in modo improprio Claude Skills in uno di due modi. O trasformano SKILL.md in un contenitore di tutto, o non riescono a superare la fase dei grandi prompt copiati e incollati.
Agentic coding, ora con backend di modelli locali.
Claude Code non è autocompletamento con una marketing migliore. È uno strumento di codifica agentico: legge il tuo codebase, modifica i file, esegue comandi e si integra con i tuoi strumenti di sviluppo.
Servire modelli open-source rapidamente con SGLang.
SGLang è un framework di serving ad alte prestazioni per grandi modelli linguistici e modelli multimodali, progettato per fornire inferenza a bassa latenza e alto throughput in tutto, da una singola GPU a cluster distribuiti.
Hot-swap dei LLM locali senza modificare i client.
Presto ti ritroverai a gestire vLLM, llama.cpp e altri componenti, ognuno su una porta propria. Tutta l’infrastruttura a valle richiede comunque un unico /v1 come base URL; altrimenti continuerai a riordinare porte, profili e script one-off. llama-swap è il proxy /v1 da posizionare davanti a quegli stack.
Cosa accade effettivamente quando esegui Ultrawork.
Oh My Opencode promette un “team virtuale di sviluppatori AI” — Sisyphus che orchestra specialisti, compiti eseguiti in parallelo e la magica parola chiave ultrawork che attiva tutto.
Conoscete Sisyphus e il suo team di agenti specialisti.
Il salto di capacità più significativo in OpenCode deriva dagli agenti specializzati: una separazione deliberata tra orchestrazione, pianificazione, esecuzione e ricerca.