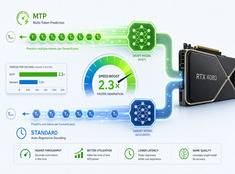
Speculative Decoding: inferenza degli LLM dal 20% al 50% più veloce
Inferenza LLM più veloce senza perdita di qualità: una guida pratica
Un modello da 70B genera un token per passaggio avanti e ogni passaggio ricarica i pesi dalla VRAM, calcola l’attenzione su tutto il contesto e sincronizza la memoria. Tra un token e l’altro, la GPU resta inattiva in attesa che si risolvano le dipendenze sequenziali.