
LLM Wiki:RAGでは代替できない統合された知識
AIシステム向けの構造化された知識
前提はシンプルです。コンパイルされた知識は、取得された断片的な情報よりも再利用性が高いというものです。 RAG(検索強化生成)は、LLM(大規模言語モデル)に外部知識へのアクセスをどのように与えるかという直接的な問いに対するデフォルトの答えとなりました。
AIシステム向けの構造化された知識
前提はシンプルです。コンパイルされた知識は、取得された断片的な情報よりも再利用性が高いというものです。 RAG(検索強化生成)は、LLM(大規模言語モデル)に外部知識へのアクセスをどのように与えるかという直接的な問いに対するデフォルトの答えとなりました。
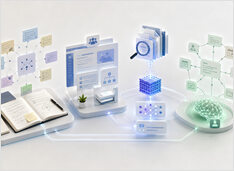
現代の知識システムの地図
PKM、RAG、ウィキ、AIメモリシステム、そして今実用化が進むAI支援ワークフローは、しばしば同じ問題を解決するかのように論じられます。 しかし、実際にはそうではありません。 これらはすべて知識を扱いますが、動作するレイヤーは異なります。
ノートは記憶です。セカンドブレインは計算です。
情報過多(インフォメーション・オーバーロード)の問題は、単なる情報の量というよりも、処理されていない入力に起因するものです。現代の知的労働では、開きっぱなしのブラウザタブ、チャットのやり取り、ドキュメント、ハイライト、スニペット、トランスクリプト、スクリーンショット、そして書きかけのメモといった痕跡を残します。
「雰囲気」に頼る解析をやめ、契約を検証せよ。
ほとんどのLLM「構造化出力」チュートリアルは、本気度にかけるものです。 それらは、JSONを丁寧な口調でリクエストし、モデルが適切に動作することを祈る方法を教えます。 それでは検証ではありません。 それは単に括弧で囲まれた楽観主義にすぎません。
エージェント型LLMのチューニングに関する参照資料
このページは、エージェント型LLM推論チューニングの実用的なリファレンス(temperature、top_p、top_k、ペナルティ、およびマルチステップやツール多用なワークフローにおけるそれらの相互作用)です。
より広範なLLMパフォーマンスエンジニアリングハブと併せて参照し、明確なLLMホスティングとサービングの概要と組み合わせることで、モデルがリソース不足に陥った際にはスループットとスケジューリングが依然として支配的ですが、不安定なサンプリングはGPUが処理を終える前にリトライと出力トークンを消費してしまうことがわかります。
このページでは以下をまとめます:
現在、以下に焦点を当てています:
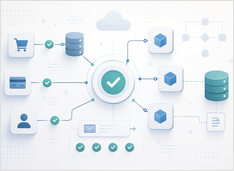
重複する副作用を回避する
分散システムにおける冪等性(Idempotency)とは、ネットワークが嘘をつき、キューが再送を試み、クライアントがパニックし、オペレーターがリプレイボタンを押した際に、あなたを救済する性質です。本番環境では、重複したメッセージの配信は正常な挙動です。問題となるのは、重複した副作用の発生です。
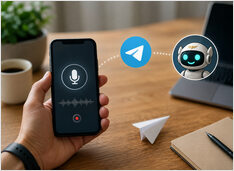
スマートフォンからHermesと会話する
スマートフォンからテキストでヘルメスエージェントとチャットすることはすでに可能でしょう。 今、あなたはエージェントと直接会話し、音声で返信を受け取りたいと考えています。 これは通常、正しい選択です。特にHermesを永続的な自己ホスト型アシスタントとして使用している場合には顕著です。 小さな画面で長いプロンプトをタイプするのは、時間がかかり、誤りも生じやすいものです。
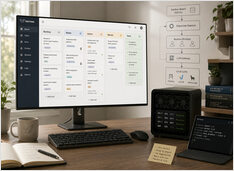
セルフホスト型LLMのHermesカンバンの負荷を制御する。
Hermes Agentには、Kanbanスタイルのボードと、一度に多くのタスクがディスパッチされるとセルフホスト型LLMを飽和状態にしてしまう可能性のあるHermes Gatewayが同梱されています。
著者:Hermes。高速に読み込まれ、安定して動作するスキル。
Hermes Agentは、繰り返し可能なワークフローを教えるデフォルトの方法としてスキルを採用しています。公式ドキュメントでは、スキルはオープンなagentskills.io仕様に準拠したオンデマンド型ナレッジ文書と説明されており、**プログレッシブ・ディスクロージャー(段階的開示)**によってモデルがまず小さなインデックスを見て、タスクが実際に必要としたときにのみ完全な指示を取得する仕組みになっています。
セルフホストされたHermes Agent用シェルおよびTUIコマンド。
Nous Research が提供する Hermes Agent は、モデル非依存型でツール利用可能なアシスタントであり、ローカルまたは VPS で実行し、シェル、全画面表示の TUI、メッセージングゲートウェイのいずれからでも利用できます。
MinIO CEは2026年に事実上EOL(寿命終了)となります。
MinIO Community Edition は、新規の本番環境システムにとって安全なデフォルトではもはやありません。
NemoClawでOpenClawを安全に実行
大多数のAIエージェントスタックは、セキュリティをデモ後の修正事項として扱っています。 NemoClawは対極の前提から始まり、隔離、ポリシー、ルーティングを初期設定(Day-Zero defaults)として採用しています。
キャプチャポリシーは、リコールと同じくらい重要である。
2026年9月更新: MnemosyneとMemoriを追加し、HonchoとHindsightの設定を拡充するとともに、元のインフラストラクチャ表に加え、キャプチャポリシー比較表を追加しました。
モダンなアシスタントは、タブを閉じるとすべてを忘れてしまいます。コンテキストウィンドウを超えるものがある場合を除いてです。**Agent memory providers(エージェントメモリプロバイダー)**とは、セッション間で事実や要約を保持するサービスまたはライブラリです。通常、プラグインとして組み込まれることで、フレームワークはスリムなままメモリを拡張できます。
本ガイドでは、Hermes Agentの外部メモリプラグインとして提供されるメモリバックエンド(Honcho、OpenViking、Mem0、Hindsight、Holographic、RetainDB、ByteRover、Supermemory、Mnemosyne、Memori)を比較し、それらがより広い**AIシステムスタックにどのように組み込まれるかを説明します。これらのベンダーは、コミュニティまたは公式の統合を通じて、OpenClawやその他のエージェントツールでも見られます。AIシステムのメモリハブ**では、この記事がCogneeおよび関連ガイドと共に一覧化されています。
Hermes固有のバウンドされたコアメモリ(MEMORY.mdとUSER.md)、フリーズ動作、トリガーについては、**Hermes Agent Memory System**を参照してください。プロバイダーの配線は、より広いエージェント知識階層の1つのレイヤーにすぎません。アイデンティティファイル、常駐メモリ、スキル、ウィキ、メモリバンクなど、それぞれに独自の注入トリガーがあり、これらは Tiered Context: AIエージェントのための知識階層 でマッピングされています。HermesのネイティブメモリプロバイダーがOpenClawとの採用面での優位性の拡大にどう貢献しているかの文脈(GitHubスター数、OpenRouterトークンランキング、エコシステム規模の比較を含む)については、 OpenClaw vs Hermes Agent: スター数、ダウンロード量、利用状況 2026 を参照してください。
メモリこそが、ツールとパートナーとの違いを創り出す。
AI エージェントとのチャットを開始し、プロジェクトの概要を説明し、好みを共有し、いくつかの作業を行い、タブを閉じる。その翌週にもう一度戻ってくると、まるで見知らぬ人と話しているかのようですね。すべてのコンテキストが失われ、すべての好みは忘れられ、プロジェクトはゼロから再説明しなければなりません。
OpenClawは急速に台頭し、その後、さらに急速に姿を消した。
OpenClawは製品として失敗したわけではありません。単に「燃料」を失っただけです。
再起動せずにLLMを配信・切り替え可能。
長らく、llama.cpp には致命的な制限がありました。
それは、1プロセスにつき1つのモデルしか提供できず、モデルを切り替えるには再起動が必要だった点です。
システム、インフラ、AIエンジニアリングの新記事をお届けします。